RF-DETR:Tutorial:02-BoxesIoU
lastmod 2026-11-18created 2026-11-183 edits
박스와 IoU는 RF-DETR 튜토리얼의 2장이다. 탐지기는 그림 속 객체마다 "여기에, 이만한 크기로 있다"를 숫자 네 개, 곧 박스로 말한다. 이 장은 박스를 숫자로 적는 두 가지 방법, 두 박스가 얼마나 겹치는지 재는 IoU 와 GIoU, 예측 박스를 정답 박스 쪽으로 끌어당기는 박스 회귀 손실을 수식·손계산·코드로 끝까지 따라간다. 뒤의 채점(3장), 매칭과 손실(7장), IoU 를 쓰는 분류 손실(9~11장)이 모두 이 장 위에 서 있다.
- 원문: 02. 박스와 IoU (읽는 시간 약 80분, 난이도 ★★☆☆☆)
- 실습 코드:
code/ch02_boxes.py. 박스 표현 변환, IoU·GIoU(모든 쌍/짝끼리), L1·IoU·GIoU 손실, 기울기 확인, 경사 하강법 실험, 도형 세상 흐트러뜨리기를 담았다.python ch02_boxes.py한 번으로 모두 돌아가고 CPU 로 8~15초 걸린다(GPU 는 쓰지 않는다). - 이전: 01. RF-DETR 이란 무엇인가 / 다음: 03. 탐지기 채점: AP 와 mAP
이 장에서 배우는 것은 다음과 같다.
- 박스의 두 표현 \((x_0, y_0, x_1, y_1)\) 과 \((c_x, c_y, w, h)\), 서로 바꾸는 식, 픽셀 좌표와 정규화 좌표
- 넓이·교집합·합집합을 구하는 법과, 교집합에 왜 max 와 min 이 나오는지
- IoU 의 정의와 성질(범위, 대칭, 크기 불변), 그리고 "IoU 0.5 는 얼마나 겹친 것인가"
- PyTorch 브로드캐스팅으로 모든 쌍의 IoU 를 한 번에 계산하기, 짝끼리 계산과의 차이
- 박스 회귀 손실 L1 과 IoU 손실의 장단점, 겹치지 않는 박스에서 IoU 손실의 기울기가 0 이 되는 이유
- GIoU 의 정의·성질·기울기, 그리고 DETR 계열이 쓰는 박스 손실 \(5 \cdot \text{L1} + 2 \cdot (1 - \operatorname{GIoU})\)
박스: 탐지기가 내놓는 네 개의 숫자
1장에서 본 것처럼 탐지기는 그림 한 장을 받아 "무엇이(클래스), 어디에(위치), 얼마나 확실하게(점수)"의 목록을 낸다. 이 가운데 "어디에"를 적는 방법이 박스(bounding box, 경계 상자)다. 박스는 객체를 빈틈없이 둘러싸는, 변이 그림의 가로·세로와 나란한 직사각형이다. 기울어진 직사각형은 쓰지 않는다. 그래서 숫자 네 개면 박스 하나가 완전히 정해진다.
이 장의 무대도 도형 세상이다. 96×96 그림에 원·사각형·삼각형이 놓여 있고, 도형마다 정답 박스가 하나씩 달려 있다. 먼저 그 박스가 어떤 숫자로 적혀 있는지부터 본다.
그림 좌표계
박스를 숫자로 적으려면 먼저 그림 위의 점에 좌표를 붙이는 약속이 필요하다. 컴퓨터 그림의 좌표계는 수학 시간의 좌표계와 한 가지가 다르다.
- 원점 \((0, 0)\) 은 그림의 왼쪽 위 모서리다.
- \(x\) 는 오른쪽으로 갈수록 커진다.
- \(y\) 는 아래쪽으로 갈수록 커진다. (수학 시간에는 위로 갈수록 컸다.)
그림이 배열 image[행, 열] 로 저장되고, 행 번호가 위에서 아래로 늘어나기 때문에 이렇게 정해졌다. 그래서 "위쪽 변"의 \(y\) 값이 "아래쪽 변"의 \(y\) 값보다 작다. 이 점만 기억하면 나머지는 평소의 좌표와 같다.
두 가지 표현
같은 박스를 적는 방법이 두 가지 있고, 탐지기 코드에서는 둘을 계속 오가며 쓴다.
- 모서리 표현(corner format, xyxy) \((x_0, y_0, x_1, y_1)\): 왼쪽 위 모서리 \((x_0, y_0)\) 와 오른쪽 아래 모서리 \((x_1, y_1)\) 을 적는다. 코드에서는
xyxy라고 부른다. 늘 \(x_0 \lt x_1\), \(y_0 \lt y_1\) 이다. - 중심 표현(center format, cxcywh) \((c_x, c_y, w, h)\): 박스 한가운데의 좌표 \((c_x, c_y)\) 와 너비 \(w\)(width), 높이 \(h\)(height)를 적는다. 코드에서는
cxcywh라고 부른다. \(c_x\) 는 "씨 엑스"라고 읽고, center 의 c 다.
원문 그림 2-1 은 같은 박스의 두 표현을 나란히 그린다. 왼쪽은 원점 \((0, 0)\) 이 왼쪽 위에 있고 \(y\) 가 아래로 커지는 좌표계 위에서 박스를 두 모서리 \((x_0, y_0)\), \((x_1, y_1)\) 로 적고, 오른쪽은 같은 박스를 중심 \((c_x, c_y)\) 와 너비 \(w\), 높이 \(h\) 로 적는다. 여기서 읽을 것은 두 가지다. 첫째, 두 표현 모두 숫자가 네 개이고 같은 직사각형을 가리킨다. 둘째, 쓰임새가 다르다.
| 표현 | 편한 일 | 이 튜토리얼에서 쓰는 곳 |
| 모서리 \((x_0, y_0, x_1, y_1)\) | 넓이·교집합·IoU 계산, 화면에 그리기 | IoU·GIoU 함수의 입력 |
| 중심 \((c_x, c_y, w, h)\) | 신경망이 예측하기(위치와 크기가 따로 떨어져 있다), L1 거리 | 정답 박스의 저장 형식, 탐지기의 출력 |
도형 세상의 정답 박스(rf_shapes.py)와 뒤에서 만들 탐지기의 출력은 모두 중심 표현이다. IoU 를 계산할 때만 모서리 표현으로 바꾼다.
서로 바꾸는 식
중심에서 왼쪽으로 너비의 절반만큼 가면 왼쪽 변, 오른쪽으로 절반만큼 가면 오른쪽 변이다. 세로도 같다. 이것을 그대로 식으로 적는다.
- 중심 표현 → 모서리 표현
- \(x_0 = c_x - \frac{w}{2}, \qquad x_1 = c_x + \frac{w}{2}\). 중심 \(c_x\) 는 왼쪽 변과 오른쪽 변의 한가운데다. 너비가 \(w\) 이므로 중심에서 양쪽 변까지의 거리는 \(w/2\) 씩이다.
- \(y_0 = c_y - \frac{h}{2}, \qquad y_1 = c_y + \frac{h}{2}\). 세로도 똑같다. \(y\) 는 아래로 커지므로 \(y_0\)(작은 값)이 위쪽 변, \(y_1\)(큰 값)이 아래쪽 변이다.
- \((x_0,\ y_0,\ x_1,\ y_1) = \left(c_x - \tfrac{w}{2},\ \ c_y - \tfrac{h}{2},\ \ c_x + \tfrac{w}{2},\ \ c_y + \tfrac{h}{2}\right)\). 네 식을 한 줄로 모았다. 숫자 예: \((c_x, c_y, w, h) = (3, 2.5, 4, 3)\) 이면 \((3 - 2,\ 2.5 - 1.5,\ 3 + 2,\ 2.5 + 1.5) = (1, 1, 5, 4)\).
- 모서리 표현 → 중심 표현
- \(x_1 - x_0 = \left(c_x + \frac{w}{2}\right) - \left(c_x - \frac{w}{2}\right) = w\). 위의 두 식을 서로 뺀다. \(c_x\) 가 지워지고 \(w/2\) 가 두 번 남아 \(w\) 가 된다. 너비는 "오른쪽 변 − 왼쪽 변"이다.
- \(x_0 + x_1 = \left(c_x - \frac{w}{2}\right) + \left(c_x + \frac{w}{2}\right) = 2c_x \quad\Longrightarrow\quad c_x = \frac{x_0 + x_1}{2}\). 이번에는 두 식을 더한다. \(w/2\) 가 지워지고 \(c_x\) 가 두 번 남는다. 2 로 나누면 중심은 "두 변의 평균"이다.
- \((c_x,\ c_y,\ w,\ h) = \left(\frac{x_0 + x_1}{2},\ \ \frac{y_0 + y_1}{2},\ \ x_1 - x_0,\ \ y_1 - y_0\right)\). 세로도 같은 방법으로 구해 모았다. 숫자 예: \((1, 1, 5, 4)\) 이면 \(\big(\tfrac{1+5}{2},\ \tfrac{1+4}{2},\ 5-1,\ 4-1\big) = (3, 2.5, 4, 3)\). 위의 예로 정확히 되돌아온다.
코드는 이 식을 그대로 옮긴 것이다. 넓이를 구하는 함수도 함께 둔다(넓이는 바로 뒤에서 다룬다).
def box_cxcywh_to_xyxy(boxes: torch.Tensor) -> torch.Tensor:
    """(cx, cy, w, h) → (x0, y0, x1, y1). 마지막 차원이 4 이면 앞의 모양은 무엇이든 된다.

    중심에서 너비 · 높이의 절반만큼 왼쪽 · 위로 가면 (x0, y0), 오른쪽 · 아래로 가면 (x1, y1) 이다.
    """
    cx, cy, w, h = boxes.unbind(-1)  # 마지막 차원을 풀어 네 텐서로. 각각의 모양은 (...,)
    return torch.stack([cx - w / 2, cy - h / 2, cx + w / 2, cy + h / 2], dim=-1)  # 다시 (..., 4)


def box_xyxy_to_cxcywh(boxes: torch.Tensor) -> torch.Tensor:
    """(x0, y0, x1, y1) → (cx, cy, w, h). 중심은 두 모서리의 평균, 너비 · 높이는 두 모서리의 차."""
    x0, y0, x1, y1 = boxes.unbind(-1)
    return torch.stack([(x0 + x1) / 2, (y0 + y1) / 2, x1 - x0, y1 - y0], dim=-1)


def box_area(boxes: torch.Tensor) -> torch.Tensor:
    """(x0, y0, x1, y1) 박스의 넓이 = 가로 × 세로. 모양 (..., 4) → (...,)."""
    return (boxes[..., 2] - boxes[..., 0]) * (boxes[..., 3] - boxes[..., 1])
코드에서 눈여겨볼 곳은 unbind(-1) 과 stack(..., dim=-1) 이다. 박스 텐서의 모양이 (4,) 이든 (N, 4) 든 (B, N, 4) 든 마지막 차원(길이 4)만 네 조각으로 풀었다가 다시 쌓으므로, 앞의 모양이 무엇이든 한 번에 바뀐다. unbind(-1) 로 얻은 cx 의 모양은 (N,) 이고, 네 개를 dim=-1 로 쌓으면 다시 (N, 4) 다.
픽셀 좌표와 정규화 좌표
좌표의 단위도 두 가지다.
- 픽셀 좌표(pixel coordinates): 픽셀 수로 잰다. 너비 \(W\), 높이 \(H\) 픽셀인 그림에서 \(x\) 는 0~\(W\), \(y\) 는 0~\(H\) 사이다.
- 정규화 좌표(normalized coordinates): 그림의 너비와 높이를 1 로 본다. \(x\) 도 \(y\) 도 0~1 사이다.
둘 사이의 변환은 나눗셈·곱셈 한 번이다. 정규화 좌표에는 물결표를 붙여 \(\tilde{x}\)("엑스 틸데")로 적는다.
\(\tilde{x} = \frac{x}{W}, \quad \tilde{y} = \frac{y}{H}, \quad \tilde{w} = \frac{w}{W}, \quad \tilde{h} = \frac{h}{H} \qquad\Longleftrightarrow\qquad x = \tilde{x}\,W, \quad y = \tilde{y}\,H, \quad w = \tilde{w}\,W, \quad h = \tilde{h}\,H\)
가로 방향의 값(\(x\), 너비)은 그림 너비 \(W\) 로, 세로 방향의 값(\(y\), 높이)은 그림 높이 \(H\) 로 나눈다. 예를 들어 640×480 그림에서 픽셀 박스 \((x_0, y_0, x_1, y_1) = (160, 120, 480, 360)\) 은 정규화 좌표로 \((160/640,\ 120/480,\ 480/640,\ 360/480) = (0.25, 0.25, 0.75, 0.75)\) 이다.
이 튜토리얼의 탐지기는 처음부터 끝까지 정규화 좌표로 박스를 다룬다. 이유는 세 가지다.
- 해상도가 바뀌어도 같은 숫자다. 같은 장면을 64×64 로 그리든 128×128 로 그리든 정규화 박스는 그대로이고, 픽셀 박스만 달라진다. 12장의 NAS 는 한 모델을 여러 입력 해상도로 돌리는데, 정답과 예측이 정규화 좌표라서 해상도마다 정답을 다시 만들 필요가 없다.
- 신경망이 내기 쉬운 범위다. 0~1 사이의 값은 시그모이드(4장) 같은 함수로 자연스럽게 만들 수 있고, 값의 크기가 그림 크기에 따라 수백 배씩 달라지지 않는다.
- 손실의 크기가 그림 크기에 휘둘리지 않는다. 뒤에서 볼 L1 거리는 좌표의 단위에 비례한다. 픽셀로 재면 큰 그림일수록 손실이 저절로 커진다.
주의: 지금 어떤 좌표인가. 박스 숫자 네 개만 봐서는 그것이 모서리 표현인지 중심 표현인지, 픽셀인지 정규화인지 알 수 없다. \((0.2, 0.3, 0.4, 0.5)\) 는 어느 쪽으로도 읽힌다. 탐지기 버그의 큰 부분이 이 혼동에서 나온다. 그래서 함수 이름에 cxcywh·xyxy 를 적고, 함수마다 독스트링에 어떤 표현을 받는지 밝혀 둔다. 이 장의 IoU 함수들은 모서리 표현을 받는다.
픽셀 중심 규약과 도형 세상의 박스
좌표는 연속인 숫자인데 픽셀은 칸이다. 둘을 잇는 약속이 하나 더 필요하다. 이 튜토리얼(과 대부분의 탐지 코드)은 다음 규약을 쓴다.
- 열 번호가 \(j\) 인 픽셀은 가로로 구간 \([j,\ j+1]\) 을 차지하는 작은 정사각형이다. 0번 픽셀은 \([0, 1]\), 95번 픽셀은 \([95, 96]\) 이다.
- 그 픽셀의 중심은 \(j + 0.5\) 이고, 한 변이
size픽셀인 그림에서 정규화 좌표로는 \((j + 0.5)/\text{size}\) 다. 행 번호 \(i\) 도 같다.
도형 세상은 이 규약대로 그림을 그린다. rf_shapes.py 의 shape_mask 는 픽셀마다 그 중심점이 도형 안에 있으면 그 픽셀을 칠한다. 정답 박스를 96 픽셀 좌표로 되돌려, 실제로 칠해진 픽셀과 견주어 본다.
def pixel_example(size: int = 96) -> None:
    """도형 세상의 정답 박스(정규화 cx, cy, w, h)를 픽셀 좌표로 되돌리고, 실제로 칠해진 픽셀과 견준다."""
    from rf_shapes import CLASS_NAMES_KO, ShapesDataset, shape_mask

    dataset = ShapesDataset(8, size=size, seed=0)
    objects = dataset.scenes[0]  # 첫 그림의 객체 목록
    print(f"[1] 도형 세상 첫 그림({size}×{size})의 정답 박스를 픽셀로 되돌리기")
    for obj in objects:
        box = torch.tensor(obj["box"])  # 정규화 (cx, cy, w, h)
        xyxy = box_cxcywh_to_xyxy(box)  # 정규화 (x0, y0, x1, y1)
        pixels = xyxy * size  # 픽셀 좌표: 가로 · 세로 모두 size 를 곱한다
        # 실제로 칠해진 픽셀: 픽셀 (행 i, 열 j) 의 중심 ((j + 0.5)/size, (i + 0.5)/size) 이 도형 안이면 True
        mask = shape_mask(obj["cls"], obj["box"], size)
        rows = mask.any(axis=1).nonzero()[0]
        cols = mask.any(axis=0).nonzero()[0]
        # 열 j 의 픽셀은 가로로 [j, j + 1] 을 차지하므로, 칠해진 픽셀을 꼭 맞게 싸는 박스는 [첫 열, 마지막 열 + 1]
        tight = torch.tensor([cols[0], rows[0], cols[-1] + 1, rows[-1] + 1], dtype=torch.float32)
        iou = paired_box_iou(pixels[None], tight[None]).item()
        print(f"  {CLASS_NAMES_KO[obj['cls']]:<4} 정규화 (cx, cy, w, h) = {fmt(box)}")
        print(f"       정규화 (x0, y0, x1, y1) = {fmt(xyxy)}")
        print(f"       픽셀   (x0, y0, x1, y1) = {fmt(pixels, 2)}")
        print(f"       칠해진 픽셀을 싸는 박스 = {fmt(tight, 0)}   두 박스의 IoU = {iou:.4f}")
    # 해상도를 바꿔도 정규화 좌표는 그대로이고 픽셀 좌표만 달라진다
    box = torch.tensor(objects[0]["box"])
    for other in (64, 96, 128):
        print(f"  해상도 {other:>3}: 첫 객체의 픽셀 박스 = {fmt(box_cxcywh_to_xyxy(box) * other, 2)}")
[1] 도형 세상 첫 그림(96×96)의 정답 박스를 픽셀로 되돌리기
  사각형  정규화 (cx, cy, w, h) = [0.1401, 0.7533, 0.2155, 0.1515]
       정규화 (x0, y0, x1, y1) = [0.0323, 0.6776, 0.2478, 0.8290]
       픽셀   (x0, y0, x1, y1) = [3.10, 65.04, 23.79, 79.59]
       칠해진 픽셀을 싸는 박스 = [3, 65, 24, 80]   두 박스의 IoU = 0.9552
  삼각형  정규화 (cx, cy, w, h) = [0.5284, 0.7679, 0.3099, 0.3443]
       정규화 (x0, y0, x1, y1) = [0.3734, 0.5958, 0.6833, 0.9400]
       픽셀   (x0, y0, x1, y1) = [35.85, 57.19, 65.60, 90.24]
       칠해진 픽셀을 싸는 박스 = [36, 58, 65, 90]   두 박스의 IoU = 0.9440
  삼각형  정규화 (cx, cy, w, h) = [0.3842, 0.4483, 0.3817, 0.2916]
       정규화 (x0, y0, x1, y1) = [0.1933, 0.3025, 0.5750, 0.5941]
       픽셀   (x0, y0, x1, y1) = [18.56, 29.04, 55.20, 57.04]
       칠해진 픽셀을 싸는 박스 = [19, 30, 55, 57]   두 박스의 IoU = 0.9476
  원    정규화 (cx, cy, w, h) = [0.8543, 0.8426, 0.2474, 0.2474]
       정규화 (x0, y0, x1, y1) = [0.7306, 0.7189, 0.9780, 0.9663]
       픽셀   (x0, y0, x1, y1) = [70.14, 69.02, 93.89, 92.77]
       칠해진 픽셀을 싸는 박스 = [70, 69, 94, 93]   두 박스의 IoU = 0.9795
  해상도  64: 첫 객체의 픽셀 박스 = [2.07, 43.36, 15.86, 53.06]
  해상도  96: 첫 객체의 픽셀 박스 = [3.10, 65.04, 23.79, 79.59]
  해상도 128: 첫 객체의 픽셀 박스 = [4.13, 86.73, 31.72, 106.12]
첫 객체(사각형)를 한 줄씩 손으로 따라가 본다.
- 도형 세상의 정답 박스를 픽셀로 되돌리기 (손계산)
- \(\tilde{x}_0 = c_x - \frac{w}{2} = 0.1401 - \frac{0.2155}{2} = 0.0323, \qquad \tilde{x}_1 = 0.1401 + \frac{0.2155}{2} = 0.2478\). 정규화 중심 표현 \((0.1401, 0.7533, 0.2155, 0.1515)\) 를 모서리 표현으로 바꾼다. 여기서는 가로만 적었다. (출력은 소수 넷째 자리로 반올림한 값이라 끝자리가 1 쯤 다를 수 있다.)
- \(x_0 = 0.0323 \times 96 = 3.10, \qquad x_1 = 0.2478 \times 96 = 23.79\). 정규화 좌표에 그림의 한 변 96 을 곱하면 픽셀 좌표다. 박스의 왼쪽 변은 3번 픽셀의 안쪽, 오른쪽 변은 23번 픽셀의 안쪽을 지난다.
- \(3.10 \le j + 0.5 \le 23.79 \quad\Longrightarrow\quad j = 3,\ 4,\ \dots,\ 23\). 사각형은 박스를 꽉 채우는 도형이므로, 중심 \(j + 0.5\) 가 박스 안에 있는 열이 칠해진다. 3번(중심 3.5)부터 23번(중심 23.5)까지다. 2번(중심 2.5)과 24번(중심 24.5)은 박스 밖이다.
- \(\text{칠해진 열이 차지하는 구간} = [3,\ 24]\). 3번 픽셀의 왼쪽 끝은 3, 23번 픽셀의 오른쪽 끝은 24 다. 출력의 "칠해진 픽셀을 싸는 박스"가 \([3, 65, 24, 80]\) 인 것과 맞는다. 정답 박스 \([3.10,\ 23.79]\) 와 변마다 1픽셀 미만으로 다르다.
출력에서 읽을 것은 세 가지다.
- 정답 박스는 픽셀 격자에 딱 맞지 않는다. 박스는 연속인 숫자로 정해지고, 그림은 그것을 칸 단위로 칠한 결과다. 칠해진 픽셀을 꼭 맞게 싼 박스와 정답 박스의 IoU 가 사각형 0.9552, 삼각형 0.9440·0.9476, 원 0.9795 다. IoU 는 바로 뒤에서 정의하지만 "완전히 같으면 1"인 값이다. 변마다 1픽셀 안팎의 차이로 이미 1 에서 0.02~0.06 이 깎였다. 삼각형은 뾰족한 꼭짓점 쪽 줄에서 칠해지는 폭이 0 에 가깝고 맨 아래 줄에서도 폭이 \(w\) 에 조금 못 미치므로, 칠해진 픽셀의 박스가 정답 박스보다 조금 작다.
- 정규화 좌표는 해상도와 무관하다. 같은 박스가 64 픽셀 그림에서는 \([2.07, 43.36, 15.86, 53.06]\), 128 픽셀 그림에서는 \([4.13, 86.73, 31.72, 106.12]\) 다. 정규화 좌표에 한 변의 길이를 곱했을 뿐이다.
- 반 픽셀을 조심해야 한다. "\(j\)번 픽셀의 좌표는 \(j\)"라고 여기는 코드와 "\(j + 0.5\)"라고 여기는 코드를 섞으면 박스가 반 픽셀 밀린다.
rf_shapes.draw_boxes가 박스를 그릴 때 0.5 를 빼는 것도 이 때문이다. matplotlib 의imshow는 픽셀의 중심을 정수 좌표에 놓으므로, 우리 규약의 좌표에서 0.5 를 빼야 그림과 박스가 맞는다.
넓이, 교집합, 합집합
두 박스가 "얼마나 겹치는가"를 재려면 세 가지 넓이가 필요하다. 각 박스의 넓이, 둘이 겹친 부분의 넓이, 둘을 합친 부분의 넓이다. 앞으로 박스를 대문자 \(A\), \(B\) 로 부르고, 넓이는 절댓값 기호를 빌려 \(|A|\) 로 적는다("A 의 넓이"라고 읽는다).
박스의 넓이
직사각형의 넓이는 가로 × 세로다. 모서리 표현에서는 가로가 \(x_1 - x_0\), 세로가 \(y_1 - y_0\) 이므로
\(|A| = (x_1 - x_0)\,(y_1 - y_0) = w \cdot h\)
이 장 내내 쓸 두 박스를 정한다. \(A = (1, 1, 5, 4)\) 와 \(B = (3, 2, 7, 6)\), 둘 다 모서리 표현이다(단위는 무엇이든 좋다. 모눈종이의 칸이라고 생각하면 된다).
\(|A| = (5 - 1)(4 - 1) = 4 \times 3 = 12, \qquad |B| = (7 - 3)(6 - 2) = 4 \times 4 = 16\)
일차원에서 먼저: 두 구간의 겹침
두 직사각형의 겹침은 곧바로 생각하기 어렵다. 한 차원 낮춰, 수직선 위의 두 구간이 얼마나 겹치는지부터 본다. 구간 \([a_0, a_1]\) 은 \(a_0\) 부터 \(a_1\) 까지의 점들이다.
- 두 구간 \([a_0, a_1]\), \([b_0, b_1]\) 의 겹친 부분
- \(x \in [a_0, a_1] \iff a_0 \le x \ \text{ 이고 } \ x \le a_1\). 점 \(x\) 가 구간 안에 있다는 것은 왼쪽 끝보다 크거나 같고 오른쪽 끝보다 작거나 같다는 뜻이다. \(\in\) 은 "안에 들어 있다", \(\iff\) 는 "같은 말이다"이다.
- \(x \ \text{가 두 구간 모두에 있다} \iff a_0 \le x,\ \ b_0 \le x,\ \ x \le a_1,\ \ x \le b_1\). 겹친 부분의 점은 두 구간의 조건 네 개를 모두 만족해야 한다.
- \(a_0 \le x \ \text{ 이고 } \ b_0 \le x \iff \max(a_0, b_0) \le x\). \(x\) 가 두 수보다 모두 크거나 같다는 것은, 둘 중 큰 쪽보다 크거나 같다는 것과 같다. 그래서 겹친 부분의 왼쪽 끝은 두 왼쪽 끝 가운데 큰 값(max)이다.
- \(x \le a_1 \ \text{ 이고 } \ x \le b_1 \iff x \le \min(a_1, b_1)\). 마찬가지로 두 수보다 모두 작거나 같다는 것은 둘 중 작은 쪽보다 작거나 같다는 것이다. 겹친 부분의 오른쪽 끝은 두 오른쪽 끝 가운데 작은 값(min)이다.
- \(\text{겹친 부분} = \big[\max(a_0, b_0),\ \min(a_1, b_1)\big], \qquad \text{겹친 길이} = \max\!\big(0,\ \min(a_1, b_1) - \max(a_0, b_0)\big)\). 길이는 오른쪽 끝 − 왼쪽 끝이다. 이 값이 음수이면 조건을 만족하는 \(x\) 가 하나도 없다는 뜻, 곧 두 구간이 떨어져 있다는 뜻이므로 겹친 길이는 0 으로 둔다. 바깥의 \(\max(0, \cdot)\) 이 그 일을 한다.
숫자로 두 경우를 확인한다.
- 겹치는 경우: \([1, 5]\) 와 \([3, 7]\). 왼쪽 끝 \(\max(1, 3) = 3\), 오른쪽 끝 \(\min(5, 7) = 5\). 겹친 부분은 \([3, 5]\), 길이 \(5 - 3 = 2\).
- 떨어진 경우: \([1, 2]\) 와 \([4, 6]\). \(\min(2, 6) - \max(1, 4) = 2 - 4 = -2\). 음수다. 이 \(-2\) 의 크기 2 는 두 구간 사이의 틈(2 에서 4 까지)의 길이다. 겹친 길이는 \(\max(0, -2) = 0\) 이다.
코드에서는 \(\max(0, \cdot)\) 을 .clamp(min=0) 으로 쓴다. clamp 는 "죔쇠"라는 뜻으로, 값이 정한 범위 밖으로 나가면 범위의 끝으로 당겨 놓는다.
이차원으로: 교집합 사각형
점 \((x, y)\) 가 박스 안에 있다는 것은 "\(x\) 가 박스의 가로 구간 안에 있고, 동시에 \(y\) 가 세로 구간 안에 있다"는 뜻이다. 그러므로 두 박스에 모두 들어 있는 점들, 곧 교집합(intersection) \(A \cap B\) 는 가로 구간끼리의 겹침 × 세로 구간끼리의 겹침으로 이루어진 직사각형이다. 일차원의 결과를 가로와 세로에 한 번씩 쓰면 된다.
\(A \cap B = \big(\underbrace{\max(x_0^A, x_0^B)}_{\text{왼쪽}},\ \ \underbrace{\max(y_0^A, y_0^B)}_{\text{위}},\ \ \underbrace{\min(x_1^A, x_1^B)}_{\text{오른쪽}},\ \ \underbrace{\min(y_1^A, y_1^B)}_{\text{아래}}\big)\)
위 첨자 \(A\), \(B\) 는 "어느 박스의 값인가"를 나타낸다(거듭제곱이 아니다). "왼쪽 위 모서리는 큰 값끼리, 오른쪽 아래 모서리는 작은 값끼리"라고 외우면 된다. 넓이는
\(|A \cap B| = \max\!\big(0,\ \min(x_1^A, x_1^B) - \max(x_0^A, x_0^B)\big) \times \max\!\big(0,\ \min(y_1^A, y_1^B) - \max(y_0^A, y_0^B)\big)\)
원문 그림 2-2 는 모눈 위에 이 장의 예 \(A = (1, 1, 5, 4)\)(넓이 12)와 \(B = (3, 2, 7, 6)\)(넓이 16)을 그리고, 둘이 겹친 교집합 사각형을 칠해 보여 준다(\(y\) 는 아래로 커진다). 교집합의 왼쪽 = \(\max(1, 3) = 3\), 위 = \(\max(1, 2) = 2\), 오른쪽 = \(\min(5, 7) = 5\), 아래 = \(\min(4, 6) = 4\) 이므로 \(A \cap B = (3, 2, 5, 4)\), 넓이 \((5 - 3) \times (4 - 2) = 4\) 이고, 합집합은 \(12 + 16 - 4 = 24\) 다. 모눈을 직접 세어 보면 \(A\) 는 12칸, \(B\) 는 16칸, 둘 다에 속한 칸은 4칸으로 식으로 구한 값과 같다.
주의: 0 으로 자르기는 곱하기 전에. 가로와 세로의 겹친 길이를 각각 먼저 0 으로 자른 다음 곱해야 한다. 두 박스가 대각선 방향으로 떨어져 있으면 가로도 세로도 음수가 나온다. 예를 들어 가로 \(-2\), 세로 \(-3\) 을 그대로 곱하면 \((-2) \times (-3) = +6\) 이라는, 있지도 않은 교집합 넓이가 생긴다. 코드의 wh = (right_bottom - left_top).clamp(min=0) 이 곱하기 앞에 있는 이유다.
합집합과 포함 배제
합집합(union) \(A \cup B\) 는 두 박스 가운데 하나에라도 들어 있는 점들이다. 합집합은 보통 직사각형이 아니라 ㄱ 자나 계단 모양이라서 넓이를 직접 구하기가 번거롭다. 대신 이렇게 생각한다.
- 합집합의 넓이 (포함 배제의 원리)
- \(|A| + |B|\). 두 박스의 넓이를 그냥 더한다. 그런데 겹친 부분 \(A \cap B\) 의 점들은 \(A\) 를 셀 때 한 번, \(B\) 를 셀 때 또 한 번, 두 번 세어졌다.
- \(|A \cup B| = |A| + |B| - |A \cap B|\). 두 번 센 부분을 한 번 빼 주면 모든 점이 정확히 한 번씩 세어진다. 넣었다가(포함) 빼는(배제) 이 셈법을 포함 배제의 원리(inclusion–exclusion principle)라고 부른다.
우리의 예에서는 \(|A \cup B| = 12 + 16 - 4 = 24\) 다. 그림 2-2 에서 색 테두리 안의 칸을 모두 세면 24칸이다. 두 박스가 떨어져 있으면 \(|A \cap B| = 0\) 이므로 합집합은 그냥 두 넓이의 합이다.
IoU: 겹침을 하나의 숫자로
IoU 의 정의
이제 "두 박스가 얼마나 비슷한가"를 숫자 하나로 만들 차례다. 교집합의 넓이만으로는 부족하다. 교집합이 4 라고 해도 두 박스가 넓이 5 짜리라면 거의 일치한 것이고, 넓이 1000 짜리라면 스친 것에 지나지 않는다. 그래서 교집합을 합집합으로 나눈다.
\(\operatorname{IoU}(A, B) = \frac{|A \cap B|}{|A \cup B|} = \frac{|A \cap B|}{|A| + |B| - |A \cap B|}\)
이것이 IoU(Intersection over Union), 우리말로 "교집합 대 합집합 비"다. "아이 오 유"라고 읽는다. "두 박스가 차지한 땅 전체 가운데 둘이 함께 차지한 땅의 비율"이라고 읽으면 된다.
비유하면, 두 사람이 각자 돗자리를 폈을 때 IoU 는 "두 돗자리가 덮은 땅 전체 가운데, 두 장이 포개진 땅의 비율"이다. 완전히 포개 놓았다면 1, 조금도 닿지 않았다면 0 이다. 한 사람의 돗자리가 아주 커서 다른 사람의 것을 통째로 덮어도, 덮은 땅 전체에 견주면 포개진 부분이 작으므로 IoU 는 낮다.
손으로 계산하기
- \(A = (1, 1, 5, 4)\), \(B = (3, 2, 7, 6)\) 의 IoU
- \(|A| = (5 - 1)(4 - 1) = 12, \qquad |B| = (7 - 3)(6 - 2) = 16\). 먼저 두 박스의 넓이. 가로 × 세로다.
- \(\text{가로 겹침} = \min(5, 7) - \max(1, 3) = 5 - 3 = 2, \qquad \text{세로 겹침} = \min(4, 6) - \max(1, 2) = 4 - 2 = 2\). 오른쪽 끝은 작은 값, 왼쪽 끝은 큰 값. 둘 다 양수이므로 0 으로 자를 일이 없다.
- \(|A \cap B| = 2 \times 2 = 4\). 교집합 사각형의 넓이.
- \(|A \cup B| = 12 + 16 - 4 = 24\). 포함 배제: 두 넓이를 더하고, 두 번 센 교집합을 한 번 뺀다.
- \(\operatorname{IoU}(A, B) = \frac{4}{24} = \frac{1}{6} \approx 0.1667\). 두 박스가 덮은 24칸 가운데 4칸만 함께 덮었다. 꽤 겹쳐 보이는데도 IoU 는 0.17 밖에 안 된다. IoU 는 생각보다 짠 점수다.
코드로 같은 값을 확인한다. box_iou 의 구현은 조금 뒤 "텐서로 모든 쌍 계산하기"에서 한 줄씩 읽는다.
def hand_example() -> None:
    """본문에서 손으로 계산하는 예: A = (1, 1, 5, 4), B = (3, 2, 7, 6)."""
    a = torch.tensor([[1.0, 1.0, 5.0, 4.0]])  # (1, 4)
    b = torch.tensor([[3.0, 2.0, 7.0, 6.0]])
    iou, union = box_iou(a, b)  # 둘 다 (1, 1)
    giou = generalized_box_iou(a, b)
    print("[2] 손계산 예  A = (1, 1, 5, 4), B = (3, 2, 7, 6)")
    print(f"  A 의 (cx, cy, w, h) = {fmt(box_xyxy_to_cxcywh(a)[0], 1)},  B 의 (cx, cy, w, h) = {fmt(box_xyxy_to_cxcywh(b)[0], 1)}")
    print(f"  되돌리기: {fmt(box_cxcywh_to_xyxy(box_xyxy_to_cxcywh(a))[0], 1)}")
    print(f"  넓이 A = {box_area(a).item():.0f}, 넓이 B = {box_area(b).item():.0f}")
    print(f"  교집합 = {(iou * union).item():.0f}, 합집합 = {union.item():.0f}")
    print(f"  IoU  = {iou.item():.4f}")
    print(f"  GIoU = {giou.item():.4f}")
    print(f"  L1 (cx, cy, w, h 로) = {box_l1(box_xyxy_to_cxcywh(a), box_xyxy_to_cxcywh(b)).item():.1f}")
    # 크기 불변: 두 박스를 같은 비율로 키우거나, 가로 · 세로를 서로 다른 비율로 늘려도 IoU · GIoU 는 그대로
    scale = torch.tensor([96.0, 64.0, 96.0, 64.0])  # x 에는 96, y 에는 64 를 곱한다
    print(f"  모두 10배:          IoU = {box_iou(a * 10, b * 10)[0].item():.4f}, GIoU = {generalized_box_iou(a * 10, b * 10).item():.4f}"
          f", L1 = {box_l1(box_xyxy_to_cxcywh(a * 10), box_xyxy_to_cxcywh(b * 10)).item():.1f}")
    print(f"  가로 96배 세로 64배: IoU = {box_iou(a * scale, b * scale)[0].item():.4f}, GIoU = {generalized_box_iou(a * scale, b * scale).item():.4f}")
[2] 손계산 예  A = (1, 1, 5, 4), B = (3, 2, 7, 6)
  A 의 (cx, cy, w, h) = [3.0, 2.5, 4.0, 3.0],  B 의 (cx, cy, w, h) = [5.0, 4.0, 4.0, 4.0]
  되돌리기: [1.0, 1.0, 5.0, 4.0]
  넓이 A = 12, 넓이 B = 16
  교집합 = 4, 합집합 = 24
  IoU  = 0.1667
  GIoU = -0.0333
  L1 (cx, cy, w, h 로) = 4.5
  모두 10배:          IoU = 0.1667, GIoU = -0.0333, L1 = 45.0
  가로 96배 세로 64배: IoU = 0.1667, GIoU = -0.0333
넓이 12 와 16, 교집합 4, 합집합 24, IoU 0.1667. 손계산과 모두 같다. GIoU 와 L1, 그리고 마지막 두 줄은 이 장의 뒤에서 차례로 설명한다.
IoU 의 네 가지 성질
IoU 가 박스의 "비슷한 정도"를 재는 표준 잣대가 된 것은 다음 성질들 덕분이다. 하나씩 이유를 붙여 확인한다.
- 0 이상 1 이하다. 교집합은 합집합의 일부이므로 \(0 \le |A \cap B| \le |A \cup B|\) 이다. 양변을 \(|A \cup B|\) 로 나누면 \(0 \le \operatorname{IoU} \le 1\). 넓이가 아무리 큰 박스든 작은 박스든 같은 눈금으로 비교할 수 있다.
- 대칭이다. \(\operatorname{IoU}(A, B) = \operatorname{IoU}(B, A)\). 교집합도 합집합도 두 박스의 순서를 바꿔도 같기 때문이다. "예측과 정답" 가운데 누구를 앞에 써도 된다.
- 두 박스가 완전히 같을 때만 1 이다. \(A = B\) 이면 교집합도 합집합도 \(A\) 자신이므로 1 이다. 거꾸로 IoU 가 1 이면 교집합과 합집합의 넓이가 같다는 뜻인데, 어느 한 박스에 상대 박스 밖으로 삐져나온 부분이 조금이라도 있으면 그 부분은 합집합에는 들어가고 교집합에는 들어가지 않으므로 합집합이 더 커진다. 삐져나온 부분이 없다는 것은 두 박스가 같다는 뜻이다.
- 크기 불변(scale invariance)이다. 두 박스를 같은 비율로 키우거나 줄여도 IoU 는 변하지 않는다. 이 성질은 아래에서 유도한다.
- 크기 불변 — 모든 좌표에 \(k\) 를 곱해도 IoU 는 그대로
- \(A' = (k x_0^A,\ k y_0^A,\ k x_1^A,\ k y_1^A), \qquad B' = (k x_0^B,\ k y_0^B,\ k x_1^B,\ k y_1^B), \qquad k \gt 0\). 두 박스의 모든 좌표에 같은 양수 \(k\) 를 곱한 박스를 \(A'\), \(B'\) 라 한다("에이 프라임"). 그림 전체를 \(k\) 배로 확대한 것과 같다.
- \(|A'| = (k x_1^A - k x_0^A)(k y_1^A - k y_0^A) = k^2\,(x_1^A - x_0^A)(y_1^A - y_0^A) = k^2\,|A|\). 가로도 \(k\) 배, 세로도 \(k\) 배이므로 넓이는 \(k^2\) 배다. \(|B'| = k^2 |B|\) 도 같다.
- \(\max(k x_0^A,\ k x_0^B) = k \max(x_0^A,\ x_0^B), \qquad \min(k x_1^A,\ k x_1^B) = k \min(x_1^A,\ x_1^B)\). 양수를 곱해도 크기 순서는 바뀌지 않으므로, 둘 중 큰 것(작은 것)은 그대로 큰 것(작은 것)이다. 그래서 \(k\) 를 max·min 밖으로 꺼낼 수 있다. (\(k\) 가 음수였다면 순서가 뒤집혀 성립하지 않는다.)
- \(|A' \cap B'| = k^2\,|A \cap B|\). 교집합 사각형의 네 좌표가 모두 \(k\) 배이므로, 그 가로·세로가 \(k\) 배, 넓이가 \(k^2\) 배다. \(\max(0, k \cdot t) = k \max(0, t)\) 이므로 0 으로 자르는 것도 영향을 받지 않는다.
- \(|A' \cup B'| = k^2|A| + k^2|B| - k^2|A \cap B| = k^2\,|A \cup B|\). 포함 배제의 세 항이 모두 \(k^2\) 배이므로 합집합도 \(k^2\) 배다.
- \(\operatorname{IoU}(A', B') = \frac{k^2\,|A \cap B|}{k^2\,|A \cup B|} = \operatorname{IoU}(A, B)\). 분자와 분모의 \(k^2\) 이 약분된다. IoU 는 넓이의 비율이라서 단위가 없고, 그래서 크기에 무관하다.
이 유도에는 덤이 하나 있다. 가로에 \(k_x\), 세로에 \(k_y\) 로 서로 다른 수를 곱해도 똑같이 성립한다. 넓이들이 모두 \(k_x k_y\) 배가 되어 역시 약분되기 때문이다. 정규화 좌표와 픽셀 좌표의 관계가 바로 이것이다(\(k_x = W\), \(k_y = H\)). 따라서 IoU 는 정규화 좌표로 계산하든 픽셀 좌표로 계산하든 같다. 그림이 정사각형이 아니어도 그렇다. 앞의 출력에서 "모두 10배"와 "가로 96배 세로 64배"의 IoU 가 원래와 같은 0.1667 인 것이 이 성질이다. 반면 같은 줄의 L1 은 4.5 에서 45.0 으로 10배가 되었다. 이 차이가 뒤에서 중요해진다.
같은 방법으로, 두 박스를 함께 평행 이동해도(모든 \(x\) 에 같은 수를 더해도) IoU 가 변하지 않음을 보일 수 있다. 가로 길이와 겹친 길이는 좌표의 차로만 정해지기 때문이다.
IoU 0.5 는 얼마나 겹친 것인가
3장의 채점은 "예측 박스와 정답 박스의 IoU 가 0.5 이상이면 맞힌 것으로 친다" 같은 문턱값을 쓴다. 0.5 라는 숫자가 어느 정도의 어긋남인지 감을 잡아 둔다. 가장 단순한 경우부터, 크기가 같은 두 박스가 가로로 \(d\) 만큼 어긋나 있다고 하자.
- 크기가 같은 박스(너비 \(w\), 높이 \(h\))를 가로로 \(d\) 만큼 밀었을 때의 IoU
- \(\text{정답 } [0,\ w] \times [0,\ h], \qquad \text{예측 } [d,\ w + d] \times [0,\ h], \qquad 0 \le d \le w\). 정답 박스의 가로 구간은 \([0, w]\), 예측 박스는 그것을 오른쪽으로 \(d\) 만큼 민 \([d, w + d]\) 다. 세로 구간은 둘 다 \([0, h]\) 로 같다. \(\times\) 는 "가로 구간과 세로 구간으로 만든 직사각형"을 뜻한다.
- \(\text{가로 겹침} = \min(w,\ w + d) - \max(0,\ d) = w - d, \qquad \text{세로 겹침} = h\). 오른쪽 끝 가운데 작은 것은 \(w\), 왼쪽 끝 가운데 큰 것은 \(d\) 다. 민 만큼 겹침이 줄어든다.
- \(|A \cap B| = (w - d)\,h\). 교집합의 넓이.
- \(|A \cup B| = wh + wh - (w - d)h = (w + d)\,h\). 포함 배제. 두 박스의 넓이는 각각 \(wh\) 다. 정리하면 \(2wh - wh + dh = (w + d)h\). 합집합은 가로 \([0, w + d]\) 를 덮는 직사각형이므로 그림으로 봐도 맞다.
- \(\operatorname{IoU} = \frac{(w - d)\,h}{(w + d)\,h} = \frac{w - d}{w + d}\). 높이 \(h\) 가 약분된다. 민 거리 \(d\) 는 분자에서 빼지고 분모에서 더해지므로, IoU 는 \(d\) 에 대해 두 배로 빠르게 줄어든다.
이 식을 \(d\) 에 대해 풀면 "IoU 가 얼마이려면 얼마나 어긋나도 되는가"를 알 수 있다.
- 원하는 IoU 를 주는 어긋남 \(d\)
- \(\operatorname{IoU} \cdot (w + d) = w - d\). \(\operatorname{IoU} = \dfrac{w - d}{w + d}\) 의 양변에 \((w + d)\) 를 곱한다.
- \(d\,(1 + \operatorname{IoU}) = w\,(1 - \operatorname{IoU})\). \(d\) 가 든 항을 왼쪽으로, \(w\) 가 든 항을 오른쪽으로 모은다: \(\operatorname{IoU} \cdot d + d = w - \operatorname{IoU} \cdot w\).
- \(d = w \cdot \frac{1 - \operatorname{IoU}}{1 + \operatorname{IoU}} \qquad\Longrightarrow\qquad \operatorname{IoU} = 0.5:\ d = \frac{w}{3}, \qquad \operatorname{IoU} = 0.75:\ d = \frac{w}{7}, \qquad \operatorname{IoU} = 0.9:\ d = \frac{w}{19}\). \(\frac{1 - 0.5}{1 + 0.5} = \frac{1}{3}\), \(\frac{0.25}{1.75} = \frac{1}{7}\), \(\frac{0.1}{1.9} = \frac{1}{19}\). 너비의 3분의 1 만 어긋나도 IoU 는 벌써 0.5 다.
어긋나는 방식은 가로로 미는 것만이 아니다. 두 가지를 더 본다.
- 가로·세로 둘 다 밀기. 한 변이 \(w\) 인 정사각형을 가로로도 세로로도 \(d\) 만큼 밀면 교집합은 한 변 \((w - d)\) 인 정사각형이고, 합집합은 \(2w^2 - (w - d)^2\) 이다. \(q = (w - d)/w\) 로 두면 \(\operatorname{IoU} = \dfrac{q^2}{2 - q^2}\) 이고, 이것을 풀면 \(q^2 = \dfrac{2\,\operatorname{IoU}}{1 + \operatorname{IoU}}\) 다. IoU 0.5 이면 \(q^2 = 2/3\), \(q = 0.8165\), 곧 \(d = 0.1835\,w\). IoU 0.75 이면 \(q^2 = 6/7\), \(d = 0.0742\,w\) 다. 두 방향으로 밀면 한 방향일 때(\(w/3 = 0.333\,w\))의 절반 남짓만 밀어도 같은 IoU 로 떨어진다.
- 가운데는 맞고 크기만 다르기. 정답과 중심이 같고 가로·세로가 모두 \(s\) 배(\(s \lt 1\))인 예측은 정답 안에 통째로 들어간다. 교집합은 예측 자신(\(s^2 wh\)), 합집합은 정답(\(wh\))이므로 \(\operatorname{IoU} = s^2\) 이다. 예측이 더 크면(\(s \gt 1\)) 거꾸로 \(\operatorname{IoU} = 1/s^2\) 이다. IoU 0.5 는 \(s = 0.707\) 또는 \(s = 1.414\), 곧 변의 길이가 약 30% 작거나 41% 큰 경우다.
def shifted_pair(width: float, height: float, dx: float, dy: float = 0.0, scale: float = 1.0):
    """정답 박스 (0, 0, width, height) 와, 그것을 (dx, dy) 만큼 밀고 가운데를 기준으로 scale 배 한 예측 박스. 모양 (1, 4) 둘."""
    target = torch.tensor([[0.0, 0.0, width, height]])
    center = torch.tensor([width / 2 + dx, height / 2 + dy, width * scale, height * scale])
    return box_cxcywh_to_xyxy(center)[None], target


def how_much_overlap() -> None:
    """IoU 0.5 · 0.75 는 얼마나 어긋난 것인가, 그리고 작은 박스는 왜 불리한가."""
    print("[3] 같은 크기(가로 w)의 박스를 가로로 d 만큼 밀기: IoU = (w − d) / (w + d)")
    width = 1.0
    for name, d in [("w/7", 1 / 7), ("w/3", 1 / 3), ("w/2", 1 / 2), ("w", 1.0)]:
        pred, target = shifted_pair(width, 0.6, d)
        iou = paired_box_iou(pred, target).item()
        print(f"  d = {name:<4} → IoU = {iou:.4f}   (공식 {(width - d) / (width + d):.4f})")
    print("  정사각형(한 변 w)을 가로 · 세로 둘 다 d 만큼 밀기")
    for d in (0.0742, 0.1835, 1 / 3):
        pred, target = shifted_pair(1.0, 1.0, d, d)
        print(f"  d = {d:.4f} w → IoU = {paired_box_iou(pred, target).item():.4f}")
    print("  가운데는 같고 크기만 s 배")
    for s in (0.866, 0.7071, 0.5, 1.4142, 2.0):
        pred, target = shifted_pair(1.0, 1.0, 0.0, 0.0, scale=s)
        print(f"  s = {s:<6} → IoU = {paired_box_iou(pred, target).item():.4f}")
    print("  같은 2 픽셀 오차, 다른 크기의 정사각형 (가로로만 / 가로 · 세로 둘 다)")
    for side in (80, 40, 20, 10, 5):
        pred_x, target = shifted_pair(side, side, 2.0)
        pred_xy, _ = shifted_pair(side, side, 2.0, 2.0)
        print(f"  한 변 {side:>2} 픽셀: IoU = {paired_box_iou(pred_x, target).item():.4f} / {paired_box_iou(pred_xy, target).item():.4f}")
[3] 같은 크기(가로 w)의 박스를 가로로 d 만큼 밀기: IoU = (w − d) / (w + d)
  d = w/7  → IoU = 0.7500   (공식 0.7500)
  d = w/3  → IoU = 0.5000   (공식 0.5000)
  d = w/2  → IoU = 0.3333   (공식 0.3333)
  d = w    → IoU = 0.0000   (공식 0.0000)
  정사각형(한 변 w)을 가로 · 세로 둘 다 d 만큼 밀기
  d = 0.0742 w → IoU = 0.7499
  d = 0.1835 w → IoU = 0.5000
  d = 0.3333 w → IoU = 0.2857
  가운데는 같고 크기만 s 배
  s = 0.866  → IoU = 0.7500
  s = 0.7071 → IoU = 0.5000
  s = 0.5    → IoU = 0.2500
  s = 1.4142 → IoU = 0.5000
  s = 2.0    → IoU = 0.2500
  같은 2 픽셀 오차, 다른 크기의 정사각형 (가로로만 / 가로 · 세로 둘 다)
  한 변 80 픽셀: IoU = 0.9512 / 0.9059
  한 변 40 픽셀: IoU = 0.9048 / 0.8223
  한 변 20 픽셀: IoU = 0.8182 / 0.6807
  한 변 10 픽셀: IoU = 0.6667 / 0.4706
  한 변  5 픽셀: IoU = 0.4286 / 0.2195
코드의 값이 공식과 모두 맞는다. (대각선으로 \(0.0742\,w\) 밀었을 때 0.7500 이 아니라 0.7499 인 것은 \(d\) 를 소수 넷째 자리로 반올림해 넣었기 때문이다.) 마지막 표는 다음 절에서 읽는다. 이 경우들을 그림으로 보면 감이 더 분명해진다.
- 그림: 그림 2-3. 여러 IoU 값의 실제 모습 — 정답 박스(초록 실선)와 예측 박스(주황 점선)의 여덟 가지 배치와 그때의 IoU, GIoU 값. 윗줄은 가로로 밀어 IoU 가 0.9, 0.75, 0.5, 0.25 인 경우, 아랫줄은 대각선으로 민 경우, 크기만 작은 경우, 크기만 큰 경우, 겹치지 않는 경우다.
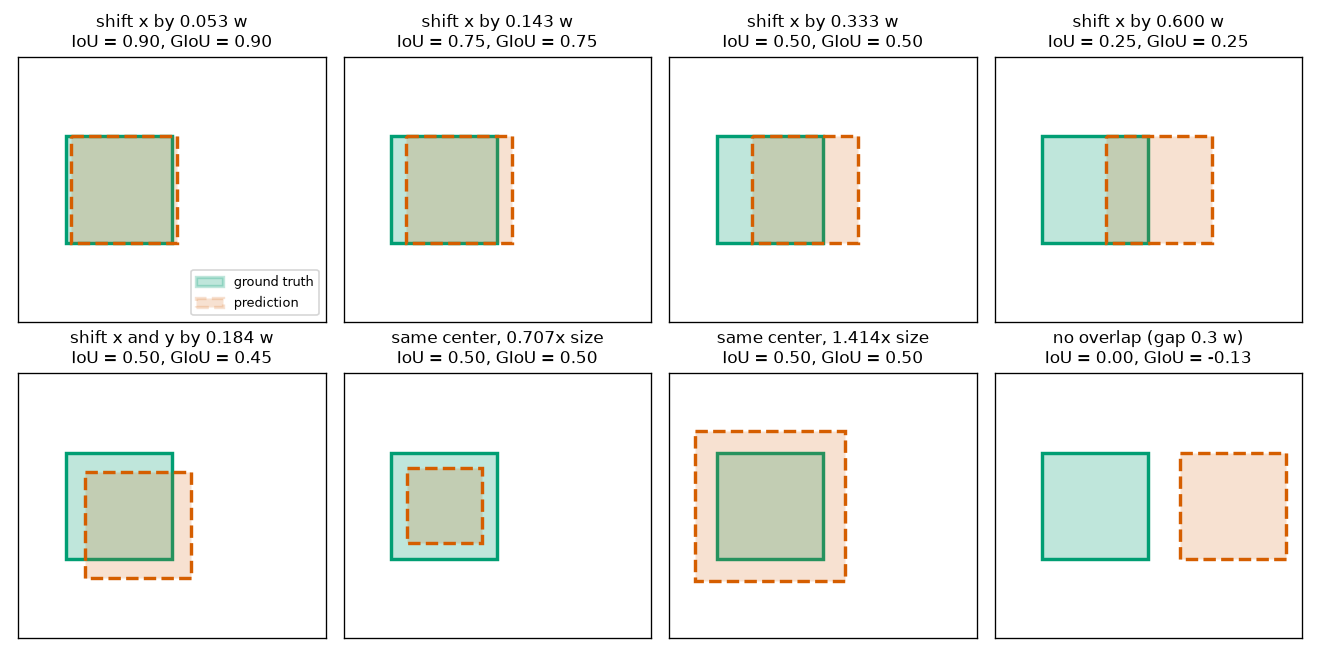
그림 2-3 에서 읽을 것은 다음과 같다.
- 윗줄(왼쪽부터 IoU 0.90, 0.75, 0.50, 0.25): IoU 0.9 는 눈으로는 거의 일치다. 0.75 도 "잘 맞혔다"로 보인다. 0.5 는 분명히 어긋나 있지만 같은 객체를 가리킨다고는 볼 수 있다. 0.25 는 절반도 못 덮었다.
- 아랫줄 왼쪽 세 칸은 모두 IoU 0.50 이다. 대각선으로 조금 민 것, 가운데는 같고 작은 것, 가운데는 같고 큰 것. 생김새가 전혀 다른 어긋남이 같은 점수를 받는다. IoU 는 "어떻게" 틀렸는지는 말해 주지 않는다.
- 아랫줄 맨 오른쪽: 겹치지 않으면 IoU 는 0 이다. 바로 옆에 있든 그림 반대편에 있든 똑같이 0 이다. 이 약점이 이 장 뒷부분의 주제다.
작은 박스는 왜 불리한가
\(\operatorname{IoU} = (w - d)/(w + d)\) 를 다시 보면, IoU 를 정하는 것은 어긋남 \(d\) 자체가 아니라 너비에 대한 비율 \(d/w\)다(분자·분모를 \(w\) 로 나누면 \(\frac{1 - d/w}{1 + d/w}\)). 그래서 똑같은 2 픽셀의 오차가 큰 박스에는 아무것도 아니지만 작은 박스에는 치명적이다. 앞 출력의 마지막 표를 옮기면 다음과 같다.
| 정사각형 박스의 한 변 | 가로로 2 픽셀 어긋남 | 가로·세로 2 픽셀씩 어긋남 |
| 80 픽셀 | IoU 0.9512 | IoU 0.9059 |
| 40 픽셀 | IoU 0.9048 | IoU 0.8223 |
| 20 픽셀 | IoU 0.8182 | IoU 0.6807 |
| 10 픽셀 | IoU 0.6667 | IoU 0.4706 |
| 5 픽셀 | IoU 0.4286 | IoU 0.2195 |
한 변 10 픽셀짜리 박스는 대각선으로 2 픽셀만 틀려도 IoU 가 0.4706 으로, 문턱값 0.5 를 넘지 못한다. 같은 오차가 80 픽셀 박스에서는 0.9059 다. 손으로도 확인된다: 가로로만 밀 때 \(\frac{10 - 2}{10 + 2} = \frac{8}{12} = 0.6667\), \(\frac{80 - 2}{80 + 2} = \frac{78}{82} = 0.9512\).
탐지기들이 작은 객체에서 점수가 낮은 데에는 여러 이유가 있지만(픽셀이 적어 정보 자체가 부족한 것이 크다), 채점 잣대인 IoU 가 작은 박스에 이렇게 엄격하다는 것도 그 하나다. 3장에서 작은·중간·큰 객체의 점수를 따로 내는 것(APS, APM, APL)을 볼 때 이 표를 떠올리면 된다. 도형 세상에서도 앞에서 본 것처럼, 픽셀 격자에 맞춘 것만으로 IoU 가 0.9440~0.9795 로 내려갔다.
텐서로 모든 쌍 계산하기
박스 두 개의 IoU 는 이제 손으로도 구할 수 있다. 그런데 탐지기는 그림 한 장에 예측 박스를 수십~수백 개 내고, 정답 박스도 여러 개다. 7장의 매칭은 모든 예측 × 모든 정답의 IoU 표가 필요하다. 예측이 \(N\) 개, 정답이 \(M\) 개이면 \(N \times M\) 개의 IoU 다. 이것을 파이썬 for 문 두 겹으로 돌리면 느리다. PyTorch 의 브로드캐스팅(broadcasting)을 쓰면 반복문 없이 한 번에 계산된다.
def box_iou(boxes1: torch.Tensor, boxes2: torch.Tensor):
    """모든 쌍의 IoU. boxes1: (N, 4), boxes2: (M, 4), 둘 다 (x0, y0, x1, y1).

    돌려주는 값: iou (N, M), union (N, M). [i, j] 가 boxes1[i] 와 boxes2[j] 의 값이다.
    """
    area1 = box_area(boxes1)  # (N,)
    area2 = box_area(boxes2)  # (M,)
    # 교집합 사각형: 왼쪽 위는 두 박스의 왼쪽 위 가운데 큰 값, 오른쪽 아래는 작은 값
    # boxes1[:, None, :2] 는 (N, 1, 2), boxes2[None, :, :2] 는 (1, M, 2) → 브로드캐스팅으로 (N, M, 2)
    left_top = torch.max(boxes1[:, None, :2], boxes2[None, :, :2])  # (N, M, 2)
    right_bottom = torch.min(boxes1[:, None, 2:], boxes2[None, :, 2:])  # (N, M, 2)
    wh = (right_bottom - left_top).clamp(min=0)  # 겹치지 않으면 음수 → 0 으로 자른다
    inter = wh[..., 0] * wh[..., 1]  # (N, M)
    union = area1[:, None] + area2[None, :] - inter  # (N, 1) + (1, M) − (N, M) → (N, M)
    return inter / union, union
브로드캐스팅 한 단계씩
브로드캐스팅은 모양이 다른 두 텐서를 계산할 때, 길이가 1 인 축을 상대의 길이만큼 복사한 것처럼 늘려 맞추는 규칙이다. 규칙은 두 줄이다.
- 두 텐서의 모양을 오른쪽 끝부터 나란히 놓고 축마다 비교한다.
- 축의 길이가 같으면 그대로 두고, 한쪽이 1 이면 그쪽을 상대의 길이로 늘린다. 둘 다 아니면 오류다.
box_iou 의 핵심 한 줄 torch.max(boxes1[:, None, :2], boxes2[None, :, :2]) 를 모양으로 따라간다. boxes1 은 (N, 4), boxes2 는 (M, 4) 다.
| 단계 | 식 | 모양 | 뜻 |
| 1 | | | 박스마다 앞의 두 숫자 \((x_0, y_0)\), 곧 왼쪽 위 모서리 |
| 2 | | | |
| 3 | | | 이번에는 맨 앞에 길이 1 인 축. "예측 쪽" 축을 비워 둔 것 |
| 4 | | | 오른쪽부터 비교: 2 와 2 는 같음, 1 과 M 은 M 으로, N 과 1 은 N 으로 |
결과의 [i, j] 자리에는 "boxes1[i] 와 boxes2[j] 의 왼쪽 위 모서리 가운데 큰 값", 곧 그 둘의 교집합 사각형의 왼쪽 위 모서리가 들어간다. \(N \times M\) 개의 쌍을 한 번에 만든 것이다. 나머지 줄도 같은 방식이다.
-
right_bottom: 뒤의 두 숫자 \((x_1, y_1)\) 끼리의min. 모양(N, M, 2). -
wh = (right_bottom - left_top).clamp(min=0): 쌍마다의 (가로 겹침, 세로 겹침). 모양(N, M, 2). 곱하기 전에 0 으로 자른다. -
inter = wh[..., 0] * wh[..., 1]: 마지막 축의 두 숫자를 곱해 교집합 넓이. 모양(N, M)....은 "앞의 축들은 그대로"라는 뜻이다. -
union = area1[:, None] + area2[None, :] - inter:(N, 1) + (1, M) − (N, M)→(N, M). 포함 배제다. -
inter / union: 모양(N, M)의 IoU 표. 합집합도 함께 돌려주는 것은 GIoU 계산에 다시 쓰기 위해서다.
예측 3개와 정답 2개로 실제 모양을 찍어 본다. 첫 예측과 첫 정답은 우리의 \(A\), \(B\) 다.
def broadcast_example() -> None:
    """모든 쌍 계산의 모양을 한 단계씩 찍어 본다. 예측 3개 × 정답 2개."""
    preds = torch.tensor([[1.0, 1.0, 5.0, 4.0], [3.0, 2.0, 7.0, 6.0], [8.0, 8.0, 9.0, 9.0]])  # (N = 3, 4)
    targets = torch.tensor([[3.0, 2.0, 7.0, 6.0], [0.0, 0.0, 4.0, 4.0]])  # (M = 2, 4)
    a = preds[:, None, :2]  # (3, 1, 2): 예측마다의 왼쪽 위 (x0, y0). 가운데에 길이 1 인 축을 끼웠다
    b = targets[None, :, :2]  # (1, 2, 2): 정답마다의 왼쪽 위. 맨 앞에 길이 1 인 축을 끼웠다
    left_top = torch.max(a, b)  # 길이 1 인 축이 상대의 길이만큼 늘어난다 → (3, 2, 2)
    print("[4] 모든 쌍 계산의 모양")
    print(f"  preds {tuple(preds.shape)}, targets {tuple(targets.shape)}")
    print(f"  preds[:, None, :2] {tuple(a.shape)}  vs  targets[None, :, :2] {tuple(b.shape)}  →  max {tuple(left_top.shape)}")
    iou, _ = box_iou(preds, targets)
    giou = generalized_box_iou(preds, targets)
    print(f"  IoU  (3, 2) =\n{iou}")
    print(f"  GIoU (3, 2) =\n{giou}")
    # 짝끼리: 예측 k 와 정답 k 만. 여기서는 앞의 두 예측을 두 정답과 짝지었다
    print(f"  짝끼리 IoU (2,) = {paired_box_iou(preds[:2], targets)}  (= 위 행렬의 [0, 0], [1, 1])")
[4] 모든 쌍 계산의 모양
  preds (3, 4), targets (2, 4)
  preds[:, None, :2] (3, 1, 2)  vs  targets[None, :, :2] (1, 2, 2)  →  max (3, 2, 2)
  IoU  (3, 2) =
tensor([[0.1667, 0.4737],
        [1.0000, 0.0667],
        [0.0000, 0.0000]])
  GIoU (3, 2) =
tensor([[-0.0333,  0.4237],
        [ 1.0000, -0.2190],
        [-0.5952, -0.7901]])
  짝끼리 IoU (2,) = tensor([0.1667, 0.0667])  (= 위 행렬의 [0, 0], [1, 1])
IoU 표를 읽어 본다. 줄이 예측, 칸이 정답이다.
-
[0, 0]= 0.1667: 손으로 구한 \(\operatorname{IoU}(A, B)\) 다. -
[1, 0]= 1.0000: 둘째 예측은 첫 정답과 똑같은 박스 \((3, 2, 7, 6)\) 이므로 1 이다. -
[0, 1]= 0.4737: \(A = (1, 1, 5, 4)\) 와 정답 \((0, 0, 4, 4)\). 교집합은 가로 \(\min(5, 4) - \max(1, 0) = 3\), 세로 \(\min(4, 4) - \max(1, 0) = 3\) 으로 9, 합집합은 \(12 + 16 - 9 = 19\), IoU 는 \(9/19 = 0.4737\). 맞는다. -
[2, 0],[2, 1]= 0: 셋째 예측 \((8, 8, 9, 9)\) 는 어느 정답과도 겹치지 않는다.
모든 쌍과 짝끼리
IoU 를 계산하는 상황은 두 가지이고, 필요한 계산의 모양이 다르다.
| 모든 쌍 ( | 짝끼리 ( | |
| 입력 | | |
| 출력 | | |
| 언제 | 누가 누구의 짝인지 아직 모를 때: 매칭 비용(7장), 채점에서 예측과 정답 맞춰 보기(3장), NMS(3장) | 짝이 이미 정해졌을 때: 매칭된 쌍의 박스 손실(7·11장), IoU 를 목표로 쓰는 분류 손실(9~11장) |
| 계산량 | \(N \times M\) 쌍 | \(K\) 쌍 |
def paired_box_iou(boxes1: torch.Tensor, boxes2: torch.Tensor) -> torch.Tensor:
    """짝지어진 박스끼리의 IoU. boxes1, boxes2: (K, 4) (x0, y0, x1, y1) → (K,). k 번째끼리만 계산한다."""
    left_top = torch.max(boxes1[:, :2], boxes2[:, :2])  # (K, 2): 새 축을 끼우지 않으니 같은 줄끼리만 만난다
    right_bottom = torch.min(boxes1[:, 2:], boxes2[:, 2:])
    wh = (right_bottom - left_top).clamp(min=0)
    inter = wh[:, 0] * wh[:, 1]
    union = box_area(boxes1) + box_area(boxes2) - inter
    return inter / union


def paired_generalized_box_iou(boxes1: torch.Tensor, boxes2: torch.Tensor) -> torch.Tensor:
    """짝지어진 박스끼리의 GIoU (K,). 손실을 계산할 때는 매칭된 쌍만 필요하므로 이 함수를 쓴다."""
    left_top = torch.max(boxes1[:, :2], boxes2[:, :2])
    right_bottom = torch.min(boxes1[:, 2:], boxes2[:, 2:])
    wh = (right_bottom - left_top).clamp(min=0)
    inter = wh[:, 0] * wh[:, 1]
    union = box_area(boxes1) + box_area(boxes2) - inter
    iou = inter / union
    outer_left_top = torch.min(boxes1[:, :2], boxes2[:, :2])
    outer_right_bottom = torch.max(boxes1[:, 2:], boxes2[:, 2:])
    outer_wh = (outer_right_bottom - outer_left_top).clamp(min=0)
    enclosing = outer_wh[:, 0] * outer_wh[:, 1]
    return iou - (enclosing - union) / enclosing
짝끼리 버전은 None 으로 축을 끼우지 않는다. boxes1[:, :2] 와 boxes2[:, :2] 는 둘 다 (K, 2) 라서 같은 줄끼리만 만난다. 결과는 모든 쌍 표의 대각선과 같다. 위 출력의 "짝끼리 IoU" 0.1667 과 0.0667 이 표의 [0, 0], [1, 1] 과 같다. 표를 다 만든 뒤 대각선만 꺼내도 답은 같지만, 예측 300개·정답 300개라면 9만 쌍을 계산하고 300개만 쓰는 낭비다.
주의: 조용히 틀리는 경우. 모든 쌍을 계산하려다 None 을 빠뜨리면 (N, 2) 와 (M, 2) 를 비교하게 된다. \(N \ne M\) 이면 오류가 나서 금방 알아챈다. 그런데 우연히 \(N = M\) 이면 오류 없이 짝끼리 계산이 되어 버린다. 모양이 (N, N) 이어야 할 결과가 (N,) 로 나온다. 텐서 코드를 쓸 때는 결과의 모양을 한 번씩 찍어 보는 습관이 이런 실수를 잡아 준다.
구현이 맞는지 확인하기
3장부터의 모든 실습이 이 함수들을 가져다 쓴다. 여기서 틀리면 뒤가 모두 틀리므로, 두 가지 방법으로 확인해 둔다.
- 성질 검사: 무작위 박스 1000쌍에서, 앞에서 유도한 성질(범위, 대칭, 자기 자신과는 1, 크기 불변)이 숫자로도 성립하는지 본다.
- 다른 방법과 대조: 공식을 쓰지 않고, 정수 좌표 박스를 모눈에 칠한 뒤 칸을 하나하나 세어 교집합·합집합을 구한다. 그림 2-2 에서 손으로 칸을 센 것을 컴퓨터에게 시키는 셈이다.
def random_boxes(n: int, generator: torch.Generator) -> torch.Tensor:
    """0 – 1 안에 들어가는 무작위 박스 n 개. (n, 4) (x0, y0, x1, y1)."""
    wh = torch.rand(n, 2, generator=generator) * 0.5 + 0.02  # 너비 · 높이 0.02 – 0.52
    center = wh / 2 + torch.rand(n, 2, generator=generator) * (1 - wh)  # 박스가 그림 밖으로 나가지 않게
    return box_cxcywh_to_xyxy(torch.cat([center, wh], dim=-1))


def check_properties(n: int, generator: torch.Generator) -> None:
    """무작위 박스 n 쌍으로 IoU · GIoU 의 성질을 확인한다. 본문에서 유도한 성질이 숫자로도 맞는지 본다."""
    a, b = random_boxes(n, generator), random_boxes(n, generator)
    a, b = a.double(), b.double()  # 부동소수점 오차를 줄이려고 배정밀도로
    iou = paired_box_iou(a, b)
    giou = paired_generalized_box_iou(a, b)
    all_iou, _ = box_iou(a, b)  # (n, n)
    all_giou = generalized_box_iou(a, b)
    print(f"[5] 무작위 박스 {n}쌍으로 성질 확인")
    print(f"  겹치는 쌍 {int((iou > 0).sum())}개, 겹치지 않는 쌍 {int((iou == 0).sum())}개")
    print(f"  IoU 범위  [{iou.min().item():.4f}, {iou.max().item():.4f}]  → 0 이상 1 이하: {bool((iou >= 0).all() and (iou <= 1).all())}")
    print(f"  GIoU 범위 [{giou.min().item():.4f}, {giou.max().item():.4f}]  → −1 초과 1 이하: {bool((giou > -1).all() and (giou <= 1).all())}")
    print(f"  GIoU ≤ IoU: {bool((giou <= iou + 1e-12).all())}   (IoU − GIoU 의 최솟값 {(iou - giou).min().item():.2e})")
    print(f"  대칭 IoU(A, B) = IoU(B, A): 최대 차 {(iou - paired_box_iou(b, a)).abs().max().item():.1e}"
          f",  GIoU 최대 차 {(giou - paired_generalized_box_iou(b, a)).abs().max().item():.1e}")
    print(f"  자기 자신과는 1: IoU {paired_box_iou(a, a).min().item():.4f}, GIoU {paired_generalized_box_iou(a, a).min().item():.4f}")
    print(f"  짝끼리 = 모든 쌍 행렬의 대각선: 최대 차 IoU {(all_iou.diagonal() - iou).abs().max().item():.1e}"
          f", GIoU {(all_giou.diagonal() - giou).abs().max().item():.1e}")
    scale = torch.tensor([640.0, 480.0, 640.0, 480.0], dtype=torch.float64)  # 가로 640, 세로 480 픽셀로
    print(f"  크기 불변 (가로 640배, 세로 480배): 최대 차 IoU {(paired_box_iou(a * scale, b * scale) - iou).abs().max().item():.1e}"
          f", GIoU {(paired_generalized_box_iou(a * scale, b * scale) - giou).abs().max().item():.1e}")
    back = box_cxcywh_to_xyxy(box_xyxy_to_cxcywh(a))
    print(f"  표현을 바꿨다 되돌리기: 최대 차 {(back - a).abs().max().item():.1e}")


def check_pixel_counting(n: int, generator: torch.Generator, grid: int = 32) -> None:
    """공식을 쓰지 않는 다른 방법과 대조: 정수 좌표 박스를 grid × grid 모눈에 칠하고 칸을 하나하나 센다."""
    low = torch.randint(0, grid - 1, (2, n, 2), generator=generator)  # 왼쪽 위 (x0, y0)
    size = torch.randint(1, grid // 2, (2, n, 2), generator=generator)  # 너비 · 높이 (1 이상)
    boxes = torch.cat([low, (low + size).clamp(max=grid)], dim=-1).float()  # (2, n, 4)
    a, b = boxes[0], boxes[1]
    cells = torch.arange(grid).float() + 0.5  # 칸의 중심 좌표 0.5, 1.5, …

    def paint(box):  # (n, 4) → (n, grid, grid) bool. 칸의 중심이 박스 안이면 True
        inside_x = (cells[None, :] > box[:, 0:1]) & (cells[None, :] < box[:, 2:3])  # (n, grid)
        inside_y = (cells[None, :] > box[:, 1:2]) & (cells[None, :] < box[:, 3:4])
        return inside_y[:, :, None] & inside_x[:, None, :]

    mask_a, mask_b = paint(a), paint(b)
    inter = (mask_a & mask_b).sum(dim=(1, 2)).float()  # 둘 다 칠한 칸 수
    union = (mask_a | mask_b).sum(dim=(1, 2)).float()  # 하나라도 칠한 칸 수
    # 둘러싸는 박스 C: 칠해진 칸이 있는 열 · 행의 범위
    either = mask_a | mask_b
    cols, rows = either.any(dim=1), either.any(dim=2)  # (n, grid)
    # (두 박스 사이에 틈이 있으면 칠해진 열 · 행의 개수가 아니라 처음과 끝 사이의 범위를 써야 한다)
    first_col, last_col = cols.float().argmax(dim=1), grid - 1 - cols.flip(1).float().argmax(dim=1)
    first_row, last_row = rows.float().argmax(dim=1), grid - 1 - rows.flip(1).float().argmax(dim=1)
    enclosing = ((last_col - first_col + 1) * (last_row - first_row + 1)).float()
    count_iou = inter / union
    count_giou = count_iou - (enclosing - union) / enclosing
    print(f"[5] 칸 세기와 대조 ({grid}×{grid} 모눈, 정수 좌표 박스 {n}쌍)")
    print(f"  IoU 최대 차 {(count_iou - paired_box_iou(a, b)).abs().max().item():.1e}"
          f",  GIoU 최대 차 {(count_giou - paired_generalized_box_iou(a, b)).abs().max().item():.1e}")
[5] 무작위 박스 1000쌍으로 성질 확인
  겹치는 쌍 333개, 겹치지 않는 쌍 667개
  IoU 범위  [0.0000, 0.6341]  → 0 이상 1 이하: True
  GIoU 범위 [-0.9810, 0.6196]  → −1 초과 1 이하: True
  GIoU ≤ IoU: True   (IoU − GIoU 의 최솟값 0.00e+00)
  대칭 IoU(A, B) = IoU(B, A): 최대 차 0.0e+00,  GIoU 최대 차 0.0e+00
  자기 자신과는 1: IoU 1.0000, GIoU 1.0000
  짝끼리 = 모든 쌍 행렬의 대각선: 최대 차 IoU 0.0e+00, GIoU 0.0e+00
  크기 불변 (가로 640배, 세로 480배): 최대 차 IoU 1.1e-16, GIoU 2.4e-16
  표현을 바꿨다 되돌리기: 최대 차 0.0e+00
[5] 칸 세기와 대조 (32×32 모눈, 정수 좌표 박스 1000쌍)
  IoU 최대 차 0.0e+00,  GIoU 최대 차 0.0e+00
- 무작위로 뽑은 1000쌍 가운데 겹치는 쌍은 333개뿐이다. 아무렇게나 놓은 두 박스는 겹치지 않는 경우가 더 흔하다. 학습을 막 시작한 탐지기의 예측도 이와 비슷한 처지다.
- IoU 는 모두 0~1 사이, 순서를 바꿔도 차이 0, 자기 자신과는 1, 짝끼리 계산은 모든 쌍 표의 대각선과 차이 0 이다.
- 가로 640배·세로 480배로 늘려도(정규화 좌표를 640×480 픽셀로 바꾼 것) IoU 의 차이는 \(10^{-16}\) 수준, 곧 부동소수점 반올림 오차뿐이다.
- 칸을 세는 방법과 공식의 차이는 IoU·GIoU 모두 정확히 0 이다.
GIoU 에 관한 줄(범위, GIoU ≤ IoU)은 GIoU 를 배운 뒤에 다시 읽는다.
박스 회귀 손실 하나: L1 거리
지금까지는 두 박스를 비교했다. 이제 관점을 바꿔, 예측 박스를 정답 박스에 맞춰 가는 일을 생각한다. 신경망의 학습은 다음 순서로 돌아간다(자세한 내용은 4장에서 처음부터 다룬다. 여기서는 세 낱말의 뜻만 잡으면 된다).
- 손실: 예측이 정답에서 얼마나 틀렸는지를 재는 숫자 하나. 작을수록 좋고, 완벽하면 0 이다. 손실을 계산하는 식을 손실 함수라고 한다.
- 기울기: 예측을 아주 조금 바꿀 때 손실이 얼마나 변하는지(미분). "어느 쪽으로 움직이면 손실이 줄어드는가"를 알려 주는 나침반이다.
- 경사 하강법(Gradient descent): 기울기의 반대 방향으로 조금씩 움직이기를 되풀이해 손실을 줄이는 방법.
박스의 네 숫자처럼 연속인 값을 맞히는 문제를 회귀라고 하고, 박스를 맞히는 일을 박스 회귀(box regression)라고 부른다. 이 장의 남은 부분은 "박스 회귀에는 어떤 손실을 써야 하는가"다. 정답 박스를 \(b\), 예측 박스를 \(\hat{b}\)("비 햇". 모자 기호는 "모델이 예측한 값"이라는 표시)로 적는다. 둘 다 정규화 중심 표현이다.
\(b = (c_x,\ c_y,\ w,\ h), \qquad \hat{b} = (\hat{c}_x,\ \hat{c}_y,\ \hat{w},\ \hat{h})\)
L1 거리의 정의와 손계산
가장 먼저 떠오르는 방법은 네 숫자를 하나씩 비교해 차이를 더하는 것이다.
\(\mathcal{L}_{\text{L1}}(b, \hat{b}) = \|b - \hat{b}\|_1 = |c_x - \hat{c}_x| + |c_y - \hat{c}_y| + |w - \hat{w}| + |h - \hat{h}|\)
이것이 L1 거리(L1 distance)이고, 손실로 쓸 때는 L1 손실이라고 부른다. \(\mathcal{L}\) 은 손실(loss)을 뜻하는 흘림체 L 이고, \(\|\cdot\|_1\) 은 "성분마다 절댓값을 취해 더한다"는 기호(L1 노름)다. 우리의 예로 계산한다. \(A\) 와 \(B\) 를 중심 표현으로 바꾸면 \((3, 2.5, 4, 3)\) 과 \((5, 4, 4, 4)\) 이므로
\(\|A - B\|_1 = |3 - 5| + |2.5 - 4| + |4 - 4| + |3 - 4| = 2 + 1.5 + 0 + 1 = 4.5\)
앞의 출력 "L1 (cx, cy, w, h 로) = 4.5"와 같다. 두 박스가 같으면 0 이고, 다를수록 커진다. 겹치든 말든 값이 정해진다는 점도 눈여겨 둔다.
왜 L2 가 아닌가
차이를 재는 방법으로는 절댓값 대신 제곱을 쓰는 L2 손실(제곱 오차) \(\sum (\text{차이})^2\) 도 있다. 박스 회귀에서 L1 계열이 더 널리 쓰이는 까닭은 기울기를 비교하면 보인다. 좌표 하나의 오차를 \(e\) 라고 하자(예: \(e = \hat{c}_x - c_x\)).
| 손실 | 기울기 (손실을 \(e\) 로 미분) | \(e = 0.01\) 일 때 기울기 | \(e = 0.5\) 일 때 기울기 | |
| L1 | \(|e|\) | \(e \gt 0\) 이면 \(+1\), \(e \lt 0\) 이면 \(-1\) | 1 | 1 |
| L2 | \(e^2\) | \(2e\) | 0.02 | 1.0 |
- L2 는 크게 틀린 예측에 끌려다닌다. 기울기가 오차에 비례하므로, 오차 0.5 인 박스 하나가 오차 0.01 인 박스 50개만큼의 힘으로 모델을 당긴다. 학습 초반에는 예측이 엉뚱한 곳에 있는 일이 흔하고, 이런 이상치(outlier: 유난히 크게 벗어난 값) 몇 개가 학습을 좌우하게 된다.
- L1 은 기울기의 크기가 늘 1 이다. 많이 틀렸든 조금 틀렸든 같은 힘으로 당기므로 이상치에 덜 휘둘린다. GIoU 논문도 관련 연구를 돌아보며, Fast R-CNN 이 이상치에 더 강인하게 학습하려고 (L1 을 0 근처에서 매끄럽게 다듬은) smooth L1 손실을 제안했다고 적고 있다.
- 대가도 있다. L1 의 기울기는 정답 바로 옆에서도 줄어들지 않는다. 정답에 다 와서도 처음과 같은 보폭으로 움직이려 하므로, 보폭(학습률)을 줄여 주지 않으면 정답 둘레에서 왔다 갔다 한다. 뒤의 실험에서 이 모습을 직접 본다. 또 \(e = 0\) 인 한 점에서는 그래프가 뾰족해서 미분이 정해지지 않는다(PyTorch 는 이때 0 을 돌려준다).
L1 의 약점: 크기 의존
L1 에는 더 근본적인 문제가 있다. 박스의 크기를 모른다. 같은 0.05 의 오차가 큰 박스에서는 사소하고 작은 박스에서는 치명적이라는 것을 앞에서 보았는데, L1 은 둘에 같은 값을 준다.
| 정답 박스 (정규화) | 예측 | L1 거리 | IoU |
| 큰 박스: 너비·높이 0.5 | 중심만 가로로 0.05 어긋남 | 0.05 | \(\dfrac{0.5 - 0.05}{0.5 + 0.05} = 0.8182\) |
| 작은 박스: 너비·높이 0.1 | 중심만 가로로 0.05 어긋남 | 0.05 | \(\dfrac{0.1 - 0.05}{0.1 + 0.05} = 0.3333\) |
L1 은 둘 다 0.05 로 똑같은데, 채점 잣대인 IoU 로는 0.8182 와 0.3333 이다. 하나는 훌륭한 예측이고 하나는 실패다. L1 손실만으로 학습하면 모델은 손실을 많이 줄일 수 있는 큰 박스에 공을 들이고, 작은 박스의 "작지만 치명적인" 오차는 가볍게 여기게 된다.
DETR 논문(3.1절)도 같은 문제를 짚는다. 박스를 직접 예측하면 손실의 상대적인 크기가 문제가 되는데, L1 손실은 상대 오차가 비슷해도 작은 박스와 큰 박스에서 크기가 달라진다는 것이다. GIoU 논문의 그림 1 도 L1 거리가 똑같이 9.07 인 세 쌍의 박스가 IoU 는 0.27, 0.59, 0.66 으로 서로 다른 예를 보여 준다. 우리가 정말로 높이고 싶은 것은 IoU 이므로, IoU 자체를 손실로 쓰면 어떨까 하는 생각이 자연스럽게 나온다.
박스 회귀 손실 둘: IoU 손실과 평평한 땅
IoU 손실
IoU 는 클수록 좋고 손실은 작을수록 좋아야 하므로, 1 에서 뺀다.
\(\mathcal{L}_{\operatorname{IoU}}(b, \hat{b}) = 1 - \operatorname{IoU}(b, \hat{b})\)
이것이 IoU 손실(IoU loss)이다. 완전히 일치하면 0, 전혀 겹치지 않으면 1 이다. IoU 가 크기 불변이므로 이 손실도 크기 불변이다. 큰 박스와 작은 박스의 "같은 정도의 어긋남"에 같은 값을 준다. L1 의 약점이 사라졌다. 그런데 새로운, 더 심각한 문제가 생긴다.
겹치지 않으면 기울기가 0
앞에서 구한 "가로로 \(d\) 만큼 민 박스"의 IoU 를 \(d\) 의 함수로 다시 본다. 이번에는 \(d\) 가 \(w\) 를 넘어 두 박스가 완전히 떨어지는 경우까지 적는다.
- 가로로 민 거리 \(d\) 에 대한 IoU 손실의 기울기
- \(\operatorname{IoU}(d) = \begin{cases} \dfrac{w - d}{w + d} & 0 \le d \lt w \quad (\text{겹침}) \\ 0 & d \ge w \quad (\text{겹치지 않음}) \end{cases}\). \(d \lt w\) 일 때는 앞에서 유도한 식이다. \(d \ge w\) 이면 가로 겹침 \(w - d\) 가 0 이하이므로 0 으로 잘려 교집합이 0, IoU 도 0 이다. 중괄호는 "경우에 따라 다른 식"을 뜻한다.
- \(\frac{d}{dd}\,\frac{w - d}{w + d} = \frac{(-1)(w + d) - (w - d)(1)}{(w + d)^2}\). 겹치는 구간에서 \(d\) 로 미분한다. 분수의 미분법 \(\left(\frac{f}{g}\right)' = \frac{f'g - fg'}{g^2}\) 에 \(f = w - d\) (\(f' = -1\)), \(g = w + d\) (\(g' = 1\))를 넣었다. 맨 앞의 \(\frac{d}{dd}\) 는 "\(d\) 로 미분한다"는 기호다.
- \(= \frac{-w - d - w + d}{(w + d)^2} = -\frac{2w}{(w + d)^2}\). 분자를 전개하면 \(d\) 가 지워지고 \(-2w\) 가 남는다. 음수이므로 "밀수록 IoU 가 줄어든다"는 뜻이다.
- \(\frac{d\,\mathcal{L}_{\operatorname{IoU}}}{dd} = -\frac{d\,\operatorname{IoU}}{dd} = \begin{cases} \dfrac{2w}{(w + d)^2} & 0 \lt d \lt w \\ 0 & d \gt w \end{cases}\). 손실은 \(1 - \operatorname{IoU}\) 이므로 부호만 바뀐다. 겹치는 동안에는 기울기가 양수라서 "\(d\) 를 줄여라(정답 쪽으로 가라)"는 신호가 나온다. 그러나 떨어지고 나면 IoU 가 상수 0 이므로 미분도 0이다.
숫자로 확인한다. \(w = 2\) 인 박스를 \(d = 1\) 만큼 밀었다면 \(\operatorname{IoU} = \frac{2 - 1}{2 + 1} = \frac{1}{3}\), 손실은 \(0.6667\), 기울기는 \(\frac{2 \cdot 2}{(2 + 1)^2} = \frac{4}{9} = 0.4444\) 다. \(d = 3\) 이면 두 박스 사이에 틈이 1 생기고, IoU 는 0, 손실은 1, 기울기는 0 이다. \(d = 3\) 이든 \(d = 300\) 이든 똑같이 손실 1, 기울기 0 이다.
짙은 안개 속에서 골짜기 바닥을 찾아 내려간다고 하자. 할 수 있는 일은 발밑의 기울어짐을 느끼고 낮은 쪽으로 가는 것뿐이다. 비탈에 서 있으면 문제없지만, 넓은 평지 한가운데라면 어느 쪽이 골짜기인지 알 길이 없다. 겹치지 않는 박스의 IoU 손실이 바로 그 평지다. 손실은 1 로 높은데(골짜기에서 멀다) 발밑은 완전히 평평해서(기울기 0) 움직일 방향을 알려 주지 않는다.
이것은 드문 일이 아니다. 조금 전 무작위 박스 1000쌍 가운데 667쌍이 겹치지 않았다. 학습을 시작할 때 예측 박스는 정답과 겹치지 않는 경우가 많고, IoU 손실만으로는 그런 박스가 영영 움직이지 못한다. GIoU 논문은 이 현상을 IoU 의 "고원(plateau)"이라고 부르며, 겹치지 않는 모든 경우에 IoU 의 기울기가 0 이라고 적는다.
GIoU: 떨어져 있어도 보이는 겹침
필요한 것은 IoU 의 좋은 점(크기 불변, 0~1 의 깔끔한 눈금)은 지키면서, 겹치지 않을 때도 "얼마나 떨어져 있는지"를 반영하는 값이다. Rezatofighi 등이 2019년 논문 "Generalized Intersection over Union: A Metric and A Loss for Bounding Box Regression"에서 제안한 GIoU(Generalized Intersection over Union, 일반화한 IoU, "지 아이 오 유")가 그 답이다.
둘러싸는 박스
GIoU 는 박스를 하나 더 끌어들인다. 두 박스 \(A\), \(B\) 를 모두 덮는 가장 작은 박스를 \(C\) 라고 한다. 이 장에서는 둘러싸는 박스(smallest enclosing box)라고 부른다. \(C\) 를 구하는 식은 교집합과 max·min 이 정확히 반대다. 두 박스를 다 덮으려면 왼쪽 위는 더 왼쪽·더 위(작은 값), 오른쪽 아래는 더 오른쪽·더 아래(큰 값)여야 하기 때문이다.
\(C = \big(\min(x_0^A, x_0^B),\ \ \min(y_0^A, y_0^B),\ \ \max(x_1^A, x_1^B),\ \ \max(y_1^A, y_1^B)\big)\)
\(C\) 안에는 \(A\) 와 \(B\) 말고도 어느 박스에도 속하지 않는 빈 곳이 있을 수 있다. 그 넓이는 \(|C| - |A \cup B|\) 다. 두 박스가 어긋나 있을수록, 멀리 떨어져 있을수록 이 빈 곳이 커진다. GIoU 는 이 빈 곳의 비율을 IoU 에서 뺀다.
원문 그림 2-4 는 그림 2-2 의 \(A\), \(B\) 위에 둘러싸는 박스 \(C = (1, 1, 7, 6)\) 을 점선으로 그리고, \(C\) 안에서 \(A\) 와 \(B\) 어디에도 속하지 않는 빈 곳을 옅게 칠한다. \(C\) 의 왼쪽 = \(\min(1, 3) = 1\), 위 = \(\min(1, 2) = 1\), 오른쪽 = \(\max(5, 7) = 7\), 아래 = \(\max(4, 6) = 6\) 이고, \(C\) 의 넓이는 \(6 \times 5 = 30\), 합집합은 24 이므로 빈 곳은 \(30 - 24 = 6\) 이다. 오른쪽 위에 2칸, 왼쪽 아래에 4칸, 모두 6칸이 어느 박스에도 속하지 않는다.
GIoU 의 정의와 손계산
\(\operatorname{GIoU}(A, B) = \operatorname{IoU}(A, B) - \frac{|C| - |A \cup B|}{|C|}\)
뒤의 항은 "\(C\) 가운데 빈 곳의 비율"이고, 0 과 1 사이의 벌점이다. 두 박스가 \(C\) 를 빈틈없이 채우면 벌점이 0 이라 GIoU 는 IoU 와 같고, 빈 곳이 많을수록 GIoU 가 IoU 보다 작아진다. 그림 2-4 의 예를 손으로 계산한다.
- \(A = (1, 1, 5, 4)\), \(B = (3, 2, 7, 6)\) 의 GIoU
- \(|A \cap B| = 4, \qquad |A \cup B| = 24, \qquad \operatorname{IoU} = \frac{4}{24} = \frac{1}{6}\). 앞에서 구한 값이다.
- \(C = \big(\min(1, 3),\ \min(1, 2),\ \max(5, 7),\ \max(4, 6)\big) = (1, 1, 7, 6)\). 둘러싸는 박스. 왼쪽 위는 작은 값끼리, 오른쪽 아래는 큰 값끼리.
- \(|C| = (7 - 1)(6 - 1) = 6 \times 5 = 30\). \(C\) 의 넓이.
- \(\frac{|C| - |A \cup B|}{|C|} = \frac{30 - 24}{30} = \frac{6}{30} = 0.2\). 빈 곳은 6칸이고, \(C\) 의 20% 다. 이것이 벌점이다.
- \(\operatorname{GIoU}(A, B) = \frac{1}{6} - \frac{6}{30} = 0.1667 - 0.2 = -0.0333\). IoU 에서 벌점을 뺀다. 음수가 나왔다. 앞의 코드 출력 "GIoU = -0.0333"과 같다.
def generalized_box_iou(boxes1: torch.Tensor, boxes2: torch.Tensor) -> torch.Tensor:
    """모든 쌍의 GIoU (N, M). GIoU = IoU − (C 의 넓이 − 합집합) / C 의 넓이. C 는 두 박스를 모두 덮는 가장 작은 박스."""
    iou, union = box_iou(boxes1, boxes2)
    # 둘러싸는 박스 C: 왼쪽 위는 작은 값, 오른쪽 아래는 큰 값 (교집합과 max · min 이 정확히 반대)
    left_top = torch.min(boxes1[:, None, :2], boxes2[None, :, :2])
    right_bottom = torch.max(boxes1[:, None, 2:], boxes2[None, :, 2:])
    wh = (right_bottom - left_top).clamp(min=0)
    enclosing = wh[..., 0] * wh[..., 1]
    return iou - (enclosing - union) / enclosing
코드는 box_iou 가 돌려준 IoU 와 합집합을 받아, 둘러싸는 박스의 넓이 enclosing 만 더 구한다. min 과 max 의 자리가 box_iou 와 반대다. 브로드캐스팅은 똑같이 (N, 1, 2) 대 (1, M, 2) → (N, M, 2) 다. 앞의 "모든 쌍" 출력에서 GIoU 표의 [2, 0] = −0.5952 도 손으로 확인된다. 예측 \((8, 8, 9, 9)\) 와 정답 \((3, 2, 7, 6)\) 은 겹치지 않으므로 IoU 0, 합집합 \(1 + 16 = 17\), \(C = (3, 2, 9, 9)\) 의 넓이 \(6 \times 7 = 42\), 따라서 \(\operatorname{GIoU} = 0 - \frac{42 - 17}{42} = -0.5952\).
GIoU 의 성질
정의를 조금만 고쳐 쓰면 성질이 한눈에 보인다. 벌점 항을 나누어 적으면 \(\frac{|C| - |A \cup B|}{|C|} = 1 - \frac{|A \cup B|}{|C|}\) 이므로
\(\operatorname{GIoU}(A, B) = \underbrace{\frac{|A \cap B|}{|A \cup B|}}_{\operatorname{IoU}:\ 0 \text{ 이상 } 1 \text{ 이하}} + \underbrace{\frac{|A \cup B|}{|C|}}_{0 \text{ 초과 } 1 \text{ 이하}} - 1\)
둘째 항은 "\(C\) 가운데 두 박스가 채운 비율"이다. 이 꼴에서 다음 성질들이 나온다.
- GIoU 의 성질 네 가지
- \(|A \cup B| \le |C| \quad\Longrightarrow\quad \frac{|C| - |A \cup B|}{|C|} \ge 0 \quad\Longrightarrow\quad \operatorname{GIoU}(A, B) \le \operatorname{IoU}(A, B)\). GIoU 는 IoU 보다 클 수 없다. \(C\) 는 두 박스를 모두 덮으므로 합집합보다 작을 수 없고, 그래서 벌점은 0 이상이다. IoU 에서 0 이상을 뺐으니 IoU 이하다.
- \(\operatorname{GIoU} = \operatorname{IoU} + \frac{|A \cup B|}{|C|} - 1 \ \gt\ 0 + 0 - 1 = -1, \qquad \operatorname{GIoU} \le \operatorname{IoU} \le 1\). 범위는 \(-1 \lt \operatorname{GIoU} \le 1\) 이다. IoU 는 0 이상이고, 넓이가 있는 박스라면 \(\frac{|A \cup B|}{|C|}\) 는 0 보다 크다. 그래서 \(-1\) 보다 크다. 위쪽은 바로 앞의 성질에서 나온다. IoU 의 범위 0~1 과 달리 0 을 가운데 둔 대칭인 범위다.
- \(A = B \quad\Longrightarrow\quad C = A,\ \ |A \cup B| = |C| \quad\Longrightarrow\quad \operatorname{GIoU} = 1 + 1 - 1 = 1\). 두 박스가 같으면 1 이다. 거꾸로 GIoU 가 1 이면 \(\operatorname{IoU} \ge \operatorname{GIoU} = 1\) 이므로 IoU 도 1, 곧 두 박스가 같다. IoU 와 마찬가지로 "같을 때만 1"이다.
- \(A \cap B = \varnothing \quad\Longrightarrow\quad \operatorname{GIoU} = \frac{|A| + |B|}{|C|} - 1 \ \longrightarrow\ -1 \quad (\text{두 박스가 한없이 멀어질 때})\). 겹치지 않을 때(\(\varnothing\) 는 "공집합", 곧 겹친 부분이 없다는 기호)는 IoU 가 0 이고 합집합이 \(|A| + |B|\) 다. 두 박스가 멀어질수록 \(C\) 가 커져 첫 항이 0 으로 가고, GIoU 는 \(-1\) 로 다가간다. 멀수록 더 낮은 값, IoU 에는 없던 정보다.
여기에 하나 더, GIoU 도 IoU 처럼 크기 불변이다. 좌표에 \(k\) 를 곱하면 \(|C|\) 도 \(k^2\) 배가 되어 벌점의 분자·분모에서 약분된다. 이 성질들은 GIoU 논문이 꼽은 성질들과 같다(논문은 범위를 \(-1 \le \operatorname{GIoU} \le 1\) 로 적고, \(-1\) 은 \(|A \cup B| / |C|\) 가 0 으로 갈 때의 극한이라고 설명한다). 앞의 무작위 박스 검사에서도 GIoU 의 범위는 \([-0.9810,\ 0.6196]\), GIoU ≤ IoU 는 1000쌍 모두 참이었다.
주의: GIoU 가 음수라고 떨어져 있는 것은 아니다. 우리의 \(A\), \(B\) 는 분명히 겹치는데(IoU 0.1667) GIoU 는 −0.0333 으로 음수다. 겹친 부분보다 빈 곳의 비율이 더 컸기 때문이다. "겹치지 않으면 GIoU ≤ 0"은 맞지만, 그 반대("GIoU 가 음수이면 겹치지 않는다")는 틀리다. 겹치는지 아닌지는 IoU 가 0 인지로 봐야 한다.
GIoU 를 손실로 쓸 때는 IoU 손실처럼 1 에서 뺀다. 이것이 GIoU 손실(GIoU loss)이다.
\(\mathcal{L}_{\operatorname{GIoU}}(b, \hat{b}) = 1 - \operatorname{GIoU}(b, \hat{b}), \qquad 0 \le \mathcal{L}_{\operatorname{GIoU}} \lt 2\)
완전히 일치하면 0, 겹치지 않기 시작하면 1 을 넘고, 한없이 멀어지면 2 에 다가간다.
겹치지 않아도 기울기가 살아 있다
IoU 손실을 평지에 가둔 바로 그 예, "같은 크기의 박스를 가로로 \(d\) 만큼 밀기"에서 GIoU 를 계산해 본다.
- 가로로 민 거리 \(d\) 에 대한 GIoU 와 그 기울기
- \(C = [0,\ w + d] \times [0,\ h], \qquad |C| = (w + d)\,h \qquad (d \ge 0 \text{ 인 모든 경우})\). 정답 \([0, w]\) 와 예측 \([d, w + d]\) 를 모두 덮는 가장 작은 가로 구간은 \([0, w + d]\) 다. 겹치든 떨어지든 같다.
- \(0 \le d \lt w: \quad |A \cup B| = (w + d)\,h = |C| \quad\Longrightarrow\quad \operatorname{GIoU} = \operatorname{IoU} = \frac{w - d}{w + d}\). 겹치는 동안에는 합집합이 \(C\) 를 빈틈없이 채운다(높이가 같고 가로로만 밀었으므로). 벌점이 0 이라 GIoU 는 IoU 와 같다.
- \(d \ge w: \quad \operatorname{IoU} = 0, \quad |A \cup B| = 2wh \quad\Longrightarrow\quad \operatorname{GIoU} = 0 - \frac{(w + d)h - 2wh}{(w + d)h} = -\frac{d - w}{w + d}\). 떨어진 뒤에는 교집합이 0 이므로 합집합은 두 넓이의 합 \(2wh\) 다. 빈 곳은 두 박스 사이의 틈, 가로 \(d - w\)·세로 \(h\) 인 직사각형이다. \(h\) 는 약분된다.
- \(-\frac{d - w}{w + d} = \frac{w - d}{w + d}\). 분자의 부호를 정리하면 겹칠 때의 식과 글자 하나 다르지 않은 같은 식이다. 이 배치에서 GIoU 는 \(d \ge 0\) 전체에서 하나의 식 \(\frac{w - d}{w + d}\) 로 적힌다. IoU 가 0 에서 멈춘 자리를 GIoU 는 같은 곡선으로 그대로 지나 음수로 내려간다.
- \(\frac{d\,\mathcal{L}_{\operatorname{GIoU}}}{dd} = -\frac{d}{dd}\,\frac{w - d}{w + d} = \frac{2w}{(w + d)^2} \ \gt\ 0 \qquad (d \gt 0 \text{ 인 모든 경우})\). 미분은 IoU 손실에서 한 것과 같은 계산이다. 다른 점은 \(d \gt w\) 에서도 이 식이 그대로 살아 있다는 것이다. 아무리 멀어도 기울기는 0 이 아니고, 늘 "\(d\) 를 줄여라"를 가리킨다.
숫자를 넣는다. \(w = 2\), \(d = 3\) (틈 1)이면 \(\operatorname{GIoU} = \frac{2 - 3}{2 + 3} = -0.2\), 손실은 \(1.2\), 기울기는 \(\frac{2 \cdot 2}{(2 + 3)^2} = \frac{4}{25} = 0.16\) 이다. 정의대로 계산해도 같다: 합집합 \(4 + 4 = 8\), \(|C| = 5 \times 2 = 10\), \(\operatorname{GIoU} = 0 - \frac{10 - 8}{10} = -0.2\). 다만 식의 생김새에서 보이듯 기울기는 멀어질수록 \(1/(w + d)^2\) 로 작아진다. 살아는 있지만 멀리서는 약하다. 이 점은 실험에서 다시 본다.
이 손계산을 PyTorch 의 자동 미분(autograd)에 맡겨 확인한다. autograd 는 텐서에 한 계산을 기록해 두었다가 backward() 를 부르면 미분을 대신 계산해 주는 기능이다(원리는 4장). 정답은 \((x_0, y_0, x_1, y_1) = (3, 0, 5, 2)\), 예측은 같은 크기로 왼쪽에 둔다. 예측이 정답의 왼쪽에 있으므로, 예측의 중심 \(\hat{c}_x\) 를 키우면 \(d\) 가 줄어든다. 그래서 \(\hat{c}_x\) 에 대한 기울기는 위에서 구한 값에 음의 부호가 붙는다.
def box_l1(pred: torch.Tensor, target: torch.Tensor) -> torch.Tensor:
    """L1 거리. pred, target: (K, 4) (cx, cy, w, h) → (K,). 네 숫자의 차의 절댓값을 더한다."""
    return (pred - target).abs().sum(dim=-1)


def iou_loss(pred: torch.Tensor, target: torch.Tensor) -> torch.Tensor:
    """IoU 손실 1 − IoU. pred, target: (K, 4) (cx, cy, w, h) → (K,)."""
    return 1 - paired_box_iou(box_cxcywh_to_xyxy(pred), box_cxcywh_to_xyxy(target))


def giou_loss(pred: torch.Tensor, target: torch.Tensor) -> torch.Tensor:
    """GIoU 손실 1 − GIoU. 값의 범위는 0 (완전히 일치) – 2 (한없이 멀리)."""
    return 1 - paired_generalized_box_iou(box_cxcywh_to_xyxy(pred), box_cxcywh_to_xyxy(target))


def detr_box_loss(pred: torch.Tensor, target: torch.Tensor, l1_coef: float = 5.0, giou_coef: float = 2.0):
    """DETR 계열의 박스 손실 = 5 · L1 + 2 · (1 − GIoU). 계수 5 와 2 는 DETR · LW-DETR · RF-DETR 이 모두 쓰는 값."""
    return l1_coef * box_l1(pred, target) + giou_coef * giou_loss(pred, target)


LOSSES = {  # 이름 → 손실 함수. 실험 · 그림에서 이 순서로 쓴다
    "1 - IoU": iou_loss,
    "1 - GIoU": giou_loss,
    "L1": box_l1,
    "5 L1 + 2 (1 - GIoU)": detr_box_loss,
}
def box_gradient(loss_fn, pred: torch.Tensor, target: torch.Tensor) -> torch.Tensor:
    """손실을 예측 박스 (cx, cy, w, h) 로 미분한 기울기 (4,). autograd 가 계산한다."""
    pred = pred.clone().requires_grad_(True)  # 이 텐서로 미분하겠다고 표시
    loss_fn(pred[None], target[None]).sum().backward()  # 손실 → 역전파
    return pred.grad


def gradient_example() -> None:
    """본문의 손계산과 맞춰 보는 기울기. 정답 T = (3, 0, 5, 2), 예측은 같은 크기(2 × 2)로 왼쪽에 있다."""
    target = box_xyxy_to_cxcywh(torch.tensor([3.0, 0.0, 5.0, 2.0]))  # (cx, cy, w, h) = (4, 1, 2, 2)
    print("[6] autograd 로 본 기울기: 정답 (x0, y0, x1, y1) = (3, 0, 5, 2), 예측은 너비 · 높이 2")
    print("    손실을 예측의 (cx, cy, w, h) 로 미분한 값")
    for name, x0 in [("겹치지 않음 (예측 x0 = 0, d = 3)", 0.0), ("겹침       (예측 x0 = 2, d = 1)", 2.0)]:
        pred = box_xyxy_to_cxcywh(torch.tensor([x0, 0.0, x0 + 2.0, 2.0]))
        print(f"  {name}")
        for loss_name, loss_fn in LOSSES.items():
            value = loss_fn(pred[None], target[None]).item()
            grad = box_gradient(loss_fn, pred, target)
            print(f"    {loss_name:<20} 값 = {value:8.4f}   기울기 = {fmt(grad)}")
[6] autograd 로 본 기울기: 정답 (x0, y0, x1, y1) = (3, 0, 5, 2), 예측은 너비 · 높이 2
    손실을 예측의 (cx, cy, w, h) 로 미분한 값
  겹치지 않음 (예측 x0 = 0, d = 3)
    1 - IoU              값 =   1.0000   기울기 = [0.0000, 0.0000, 0.0000, 0.0000]
    1 - GIoU             값 =   1.2000   기울기 = [-0.1600, 0.0000, -0.1200, 0.0000]
    L1                   값 =   3.0000   기울기 = [-1.0000, 0.0000, 0.0000, 0.0000]
    5 L1 + 2 (1 - GIoU)  값 =  17.4000   기울기 = [-5.3200, 0.0000, -0.2400, 0.0000]
  겹침       (예측 x0 = 2, d = 1)
    1 - IoU              값 =   0.6667   기울기 = [-0.4444, 0.0000, -0.1111, 0.0000]
    1 - GIoU             값 =   0.6667   기울기 = [-0.4444, 0.0000, -0.1111, 0.0000]
    L1                   값 =   1.0000   기울기 = [-1.0000, 0.0000, 0.0000, 0.0000]
    5 L1 + 2 (1 - GIoU)  값 =   6.3333   기울기 = [-5.8889, 0.0000, -0.2222, 0.0000]
기울기의 네 숫자는 차례로 예측의 \((\hat{c}_x, \hat{c}_y, \hat{w}, \hat{h})\) 에 대한 미분이다.
- 겹치지 않을 때 IoU 손실: 값 1.0000, 기울기는 네 성분 모두 0. 유도한 그대로, 움직일 방향을 전혀 알려 주지 않는다.
- 겹치지 않을 때 GIoU 손실: 값 1.2000, \(\hat{c}_x\) 성분 −0.1600. 손계산의 \(1.2\) 와 \(0.16\) 에 부호(오른쪽으로 가면 손실이 준다)가 붙은 값이다. 경사 하강법은 기울기의 반대 방향으로 가므로 \(\hat{c}_x\) 를 키운다. 정답 쪽이다.
- \(\hat{w}\) 성분 −0.1200도 눈여겨볼 만하다. 너비를 키워도 GIoU 손실이 줄어든다는 뜻이다. 손으로도 확인된다. 예측의 너비를 \(\hat{w}\) 로 두면(중심은 1 에 고정) 합집합은 \(2\hat{w} + 4\), \(|C| = 2\,(4 + \hat{w}/2) = 8 + \hat{w}\) 이므로 \(\operatorname{GIoU} = \frac{2\hat{w} + 4}{8 + \hat{w}} - 1\) 이고, \(\hat{w}\) 로 미분하면 \(\frac{2(8 + \hat{w}) - (2\hat{w} + 4)}{(8 + \hat{w})^2} = \frac{12}{100} = 0.12\) (\(\hat{w} = 2\) 일 때)다. 겹치지 않는 동안 GIoU 손실은 박스를 정답 쪽으로 옮기는 동시에 키우려고 한다. 박스를 키우면 빈 곳의 비율이 줄기 때문이다.
- 겹칠 때: IoU 손실과 GIoU 손실의 값(0.6667)도 기울기도 같다. 이 배치에서는 겹치는 동안 벌점이 0 이기 때문이다. \(\hat{c}_x\) 성분 −0.4444 는 손계산의 \(4/9\) 다.
- L1: 겹치든 말든 \(\hat{c}_x\) 성분이 −1.0000 으로 같다. 크기가 늘 1 인 기울기다. 너비·높이는 이미 정답과 같으므로 그 성분은 0 이다.
- 마지막 줄
5 L1 + 2 (1 - GIoU)는 이 장 끝에서 설명할 DETR 계열의 박스 손실이다. 값 \(17.4 = 5 \times 3 + 2 \times 1.2\), 기울기 \(-5.32 = 5 \times (-1) + 2 \times (-0.16)\) 으로, 두 손실을 계수만큼 곱해 더한 것이다.
참고: \(\hat{c}_y\) 와 \(\hat{h}\) 성분이 0 인 이유. 이 예에서는 두 박스의 위아래가 정확히 맞춰져 있다. \(\hat{c}_y\) 는 위로 가든 아래로 가든 똑같이 나빠지는 한가운데라서 0 이다. \(\hat{h}\) 는 max·min 의 두 인자가 정확히 같은 특수한 자리다. 이런 자리에서 PyTorch 는 기울기를 두 인자에 절반씩 나누어 주는데, 이 예에서는 그 결과가 마침 서로 지워져 0 이 된다. 두 박스의 높이가 조금이라도 다르면 0 이 아닌 값이 나온다. 일반적인 현상이 아니라 이 예의 대칭 때문이라는 것만 알아 두면 된다.
실험: 밀어 보고, 내려가 보기
유도한 것들을 실험으로 확인한다. 네 가지를 한다. ① 예측을 가로로 밀며 세 값의 곡선 그리기, ② 손실 표면 그리기, ③ 경사 하강법으로 박스 하나를 정답에 맞추기, ④ 도형 세상의 박스를 흐트러뜨려 보기. 모두 python ch02_boxes.py 한 번으로 돌아가고, CPU 로 8~15초 걸린다(GPU 는 쓰지 않는다).
가로로 밀며 세 값 보기
정규화 좌표에서 너비·높이 \(w = 0.2\) 인 정답 박스를 두고, 같은 크기의 예측을 \(d = 0\) 부터 \(3w\) 까지 가로로 밀어 간다. 점마다 L1·IoU·GIoU 의 값과, 각 손실을 \(\hat{c}_x\) 로 미분한 기울기의 크기를 잰다.
def slide_curves(points: int):
    """예측 박스(정답과 같은 크기)를 정답에서 가로로 d 만큼 밀어 가며 L1 · IoU · GIoU 와 손실의 기울기를 잰다.

    돌려주는 값: d (points,), 값 사전, 기울기 사전(손실을 cx 로 미분한 값의 절댓값).
    """
    width, height = 0.2, 0.2
    target = torch.tensor([0.3, 0.5, width, height])  # 정규화 (cx, cy, w, h)
    shifts = torch.linspace(0.0, 3 * width, points)  # d = 0 … 3w
    pred = target.repeat(points, 1)  # (points, 4)
    pred[:, 0] += shifts  # 중심만 오른쪽으로
    pred.requires_grad_(True)
    targets = target.repeat(points, 1)
    values, grads = {}, {}
    for name, loss_fn in list(LOSSES.items())[:3]:
        loss = loss_fn(pred, targets)  # (points,)
        (grad,) = torch.autograd.grad(loss.sum(), pred)  # (points, 4): 점마다 따로 미분된다
        values[name] = loss.detach()
        grads[name] = grad[:, 0].abs()  # cx 방향 성분의 크기
    print("[7] 가로로 밀기 (w = 0.2): 값과 |d손실/dcx|")
    print("    d/w    L1     IoU     GIoU   | 기울기 1−IoU  1−GIoU    L1   | 공식 2w/(w+d)²")
    for ratio in (0.0, 0.1, 0.25, 0.5, 0.9, 1.1, 1.5, 2.0, 3.0):
        k = int(torch.argmin((shifts / width - ratio).abs()))
        d = shifts[k].item()
        print(f"    {d / width:4.2f}  {values['L1'][k].item():.4f}  {1 - values['1 - IoU'][k].item():7.4f} {1 - values['1 - GIoU'][k].item():7.4f}"
              f"  |   {grads['1 - IoU'][k].item():7.4f}  {grads['1 - GIoU'][k].item():7.4f}  {grads['L1'][k].item():.4f} |   {2 * width / (width + d) ** 2:7.4f}")
    return shifts, values, grads
[7] 가로로 밀기 (w = 0.2): 값과 |d손실/dcx|
    d/w    L1     IoU     GIoU   | 기울기 1−IoU  1−GIoU    L1   | 공식 2w/(w+d)²
    0.00  0.0000   1.0000  1.0000  |    0.0000   0.0000  0.0000 |   10.0000
    0.10  0.0200   0.8182  0.8182  |    8.2645   8.2645  1.0000 |    8.2645
    0.25  0.0500   0.6000  0.6000  |    6.4000   6.4000  1.0000 |    6.4000
    0.50  0.1000   0.3333  0.3333  |    4.4444   4.4444  1.0000 |    4.4444
    0.90  0.1800   0.0526  0.0526  |    2.7701   2.7701  1.0000 |    2.7701
    1.10  0.2200   0.0000 -0.0476  |    0.0000   2.2676  1.0000 |    2.2676
    1.50  0.3000   0.0000 -0.2000  |    0.0000   1.6000  1.0000 |    1.6000
    2.00  0.4000   0.0000 -0.3333  |    0.0000   1.1111  1.0000 |    1.1111
    3.00  0.6000   0.0000 -0.5000  |    0.0000   0.6250  1.0000 |    0.6250
- 그림: 그림 2-5. 예측을 가로로 밀 때의 값과 손실의 기울기 크기 — 왼쪽은 민 거리에 따른 IoU, GIoU, L1 거리의 값, 오른쪽은 세 손실의 기울기 크기다. 가로축은 민 거리를 박스 너비로 나눈 \(d/w\) 이고, 세로 점선(\(d = w\))에서 두 박스가 떨어진다.
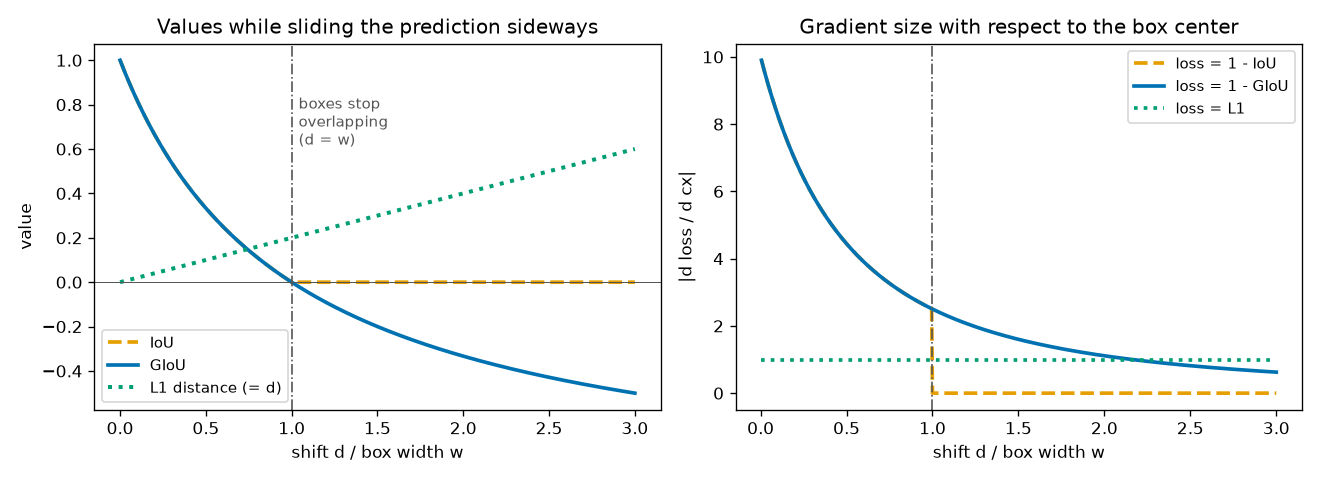
표와 그림 2-5 에서 읽을 것이다.
- 왼쪽, IoU 와 GIoU. \(d \lt w\) 에서는 두 곡선이 완전히 겹친다(표의 \(d/w = 0.10\)~\(0.90\) 줄에서 두 값이 같다). \(d = w\) 에서 IoU 는 0 에 닿은 뒤 그대로 바닥에 붙고, GIoU 는 꺾임 없이 같은 곡선으로 내려간다: \(d/w = 1.1\) 에서 −0.0476, 2 에서 −0.3333, 3 에서 −0.5000. 공식 \(\frac{w - d}{w + d}\) 에 \(d = 3w\) 를 넣으면 \(\frac{-2w}{4w} = -0.5\) 다.
- 왼쪽, L1. 민 거리 그대로인 직선이다(\(d = 0.2\) 이면 0.2). 겹치는지와 아무 상관이 없다.
- 오른쪽, IoU 손실의 기울기. \(d = w\) 를 넘는 순간 \(\frac{2w}{(2w)^2} = \frac{1}{2w} = 2.5\) 에서 0 으로 뚝 떨어진다. 표에서 \(d/w = 0.90\) 일 때 2.7701, \(1.10\) 일 때 0.0000 이다. 평지의 시작이다.
- 오른쪽, GIoU 손실의 기울기. 같은 자리를 2.7701 → 2.2676 으로 매끄럽게 지나간다. autograd 가 계산한 값이 마지막 칸의 공식 \(\frac{2w}{(w + d)^2}\) 과 소수 넷째 자리까지 모두 같다. 다만 멀어질수록 줄어든다. \(d = 3w\) 에서는 0.6250 으로, 늘 1 인 L1 보다도 작다. 두 곡선은 \(d \approx 2.2\,w\) 에서 엇갈린다(\(\frac{2w}{(w+d)^2} = 1\) 을 \(w = 0.2\) 로 풀면 \(d = 0.432\)).
- 가까이에서는 GIoU 손실의 기울기가 훨씬 크다. \(d/w = 0.1\) 에서 8.2645 로 L1 의 8배다. 그리고 이 크기는 박스의 크기에 달려 있다. \(d = r\,w\) 로 적으면 \(\frac{2w}{(w + rw)^2} = \frac{2}{w\,(1 + r)^2}\) 이므로, 같은 비율 \(r\) 만큼 어긋났을 때 작은 박스일수록 기울기가 크다(\(1/w\) 에 비례). 작은 박스의 작은 오차를 크게 꾸짖는 것, L1 에 없던 바로 그 성질이다.
- \(d = 0\) 의 줄. 공식은 10 인데 autograd 는 0 을 돌려준다. 틀린 것이 아니다. \(d = 0\) 은 손실이 가장 낮은 뾰족한 꼭짓점이라, 왼쪽으로 가도 오른쪽으로 가도 손실이 늘어난다. 미분이 하나로 정해지지 않는 점이고, PyTorch 는 이런 자리에서 0 을 준다. 공식의 10 은 "오른쪽에서 다가올 때의 기울기"다.
손실 표면
이번에는 예측 박스의 크기를 정답과 같게 고정하고, 중심 \((\hat{c}_x, \hat{c}_y)\) 를 그림 전체에서 움직여 본다. 중심의 위치마다 손실 값을 색으로 칠하면 손실 표면이 된다. 경사 하강법은 이 표면 위에 놓인 구슬처럼, 지금 있는 자리에서 가장 가파르게 내려가는 쪽으로 굴러간다.
- 그림: 그림 2-6. 예측 박스의 중심을 움직일 때의 손실 표면 — 왼쪽부터 \(1 - \operatorname{IoU}\), \(1 - \operatorname{GIoU}\), L1. 흰 점선이 정답 박스, 흰 십자가 그 중심, 흰 실선은 등고선(손실이 같은 점들)이다. 어두울수록 손실이 낮다.
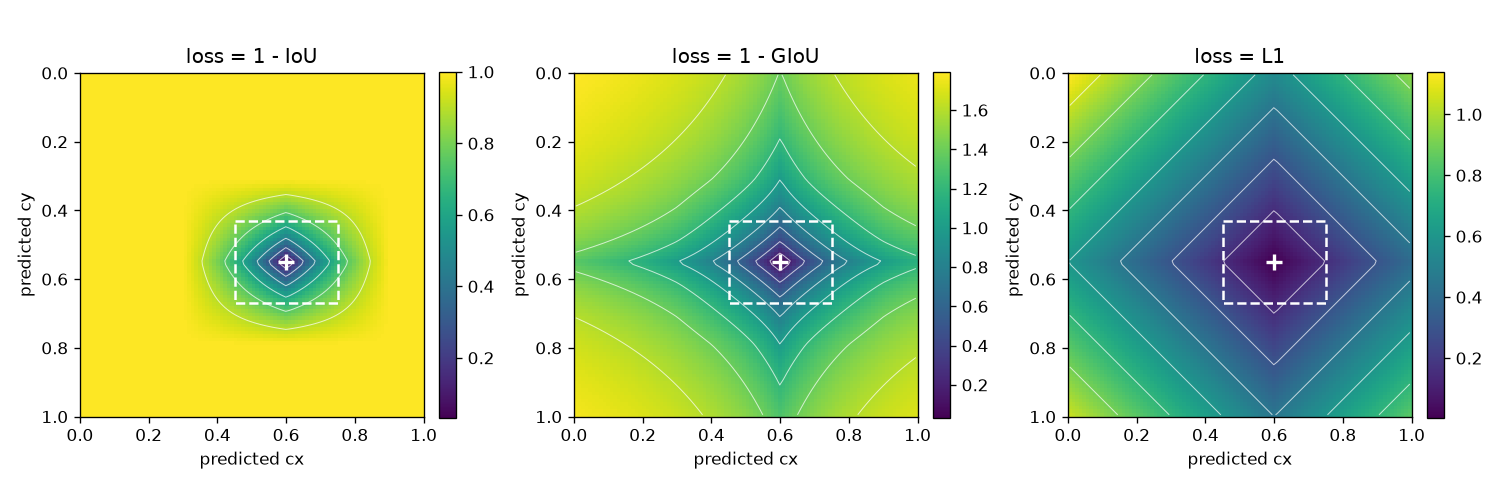
- \(1 - \operatorname{IoU}\) (왼쪽): 정답 둘레의 좁은 구역만 움푹 패어 있고, 나머지는 모두 손실 1 인 노란 평지다. 등고선이 정답 가까이에만 있다. 평지에 놓인 구슬은 굴러가지 않는다. 예측의 중심이 정답에서 가로로 \(w\) 이상, 또는 세로로 \(h\) 이상 떨어지면 이 평지다.
- \(1 - \operatorname{GIoU}\) (가운데): 평지가 없다. 그림의 어느 구석에서도 등고선이 정답을 둘러싸고 있어, 어디에 놓아도 정답 쪽으로 굴러간다. 십자 모양의 골이 보이는데, 가로나 세로 가운데 한쪽이라도 정답과 나란히 맞으면 빈 곳이 줄어 손실이 낮아지기 때문이다. 색 눈금이 1 을 넘어 1.7 근처까지 올라간다(GIoU 손실의 범위는 0~2).
- L1 (오른쪽): 등고선이 마름모꼴이고 간격이 고르다. \(|\Delta x| + |\Delta y|\) 가 같은 점들이 마름모를 이루기 때문이다. 어디서나 같은 가파르기의 비탈이다. 박스의 크기와 무관하게 표면의 생김새가 똑같다는 것이 L1 의 특징이자 약점이다.
경사 하강법으로 박스 맞추기
이제 실제로 굴려 본다. 신경망은 없다. 박스의 숫자 네 개 \((\hat{c}_x, \hat{c}_y, \hat{w}, \hat{h})\) 가 곧 우리가 고칠 값이고, 매 스텝마다
\(\hat{b} \ \leftarrow\ \hat{b} - \eta\,\nabla_{\hat{b}}\,\mathcal{L}(b, \hat{b})\)
를 되풀이한다. \(\nabla_{\hat{b}}\,\mathcal{L}\) ("나블라")는 손실을 \(\hat{b}\) 의 네 성분으로 각각 미분해 모은 기울기이고, \(\eta\)("에타")는 한 번에 얼마나 움직일지를 정하는 학습률이다. 시작 박스는 그림 왼쪽 위의 작은 박스 \((0.20, 0.24, 0.16, 0.20)\), 정답은 오른쪽 아래의 \((0.68, 0.64, 0.30, 0.24)\) 다. 둘은 겹치지 않는다. 같은 시작점·같은 학습률 0.002·같은 2000 스텝으로, 손실만 네 가지로 바꾼다.
def descend(loss_fn, start: torch.Tensor, target: torch.Tensor, lr: float, steps: int, decay: bool = False):
    """경사 하강법으로 박스 하나를 정답에 맞춘다. start, target: (4,) 정규화 (cx, cy, w, h).

    매 스텝: 손실 → 기울기 → 박스 ← 박스 − lr · 기울기. 신경망은 없고, 박스의 숫자 네 개가 곧 매개변수다.
    decay=True 이면 학습률을 처음 값에서 0 까지 스텝에 따라 곧게 줄인다.
    돌려주는 값: 궤적 (steps + 1, 4), 스텝마다의 IoU (steps + 1,).
    """
    box = start.clone().requires_grad_(True)
    path, ious = [box.detach().clone()], []
    for k in range(steps):
        step_lr = lr * (1 - k / steps) if decay else lr
        loss = loss_fn(box[None], target[None]).sum()
        (grad,) = torch.autograd.grad(loss, box)
        with torch.no_grad():
            ious.append(1 - iou_loss(box[None], target[None]).item())
            box -= step_lr * grad  # 경사 하강법 한 스텝
            box[2:].clamp_(min=1e-3)  # 너비 · 높이가 0 이하로 내려가지 않게 (박스로서 뜻이 없어진다)
        path.append(box.detach().clone())
    ious.append(1 - iou_loss(box.detach()[None], target[None]).item())
    return torch.stack(path), torch.tensor(ious)


def descent_experiment(steps: int, lr: float):
    """멀리 떨어진 시작점에서 네 가지 손실로 각각 경사 하강법을 돌린다."""
    start = torch.tensor([0.20, 0.24, 0.16, 0.20])  # 왼쪽 위의 작은 박스
    target = torch.tensor([0.68, 0.64, 0.30, 0.24])  # 오른쪽 아래의 정답. 둘은 겹치지 않는다
    start_iou = 1 - iou_loss(start[None], target[None]).item()
    start_giou = 1 - giou_loss(start[None], target[None]).item()
    print(f"[8] 경사 하강법으로 박스 맞추기 (학습률 {lr}, {steps} 스텝)")
    print(f"  시작 {fmt(start, 2)} → 정답 {fmt(target, 2)},  시작 IoU = {start_iou:.4f}, GIoU = {start_giou:.4f}")
    results = {}
    for name, loss_fn in LOSSES.items():
        path, ious = descend(loss_fn, start, target, lr, steps)
        results[name] = (path, ious)
        reached = [next((k for k, v in enumerate(ious.tolist()) if v >= level), None) for level in (1e-9, 0.5, 0.9)]
        tail = ious[-max(steps // 10, 1):]  # 마지막 10% 구간
        print(f"  {name:<20} 마지막 박스 {fmt(path[-1], 3)}  마지막 IoU = {ious[-1].item():.4f}"
              f"  (마지막 10% 구간 최소 {tail.min().item():.4f} – 최대 {tail.max().item():.4f})")
        print(f"  {'':<20} 겹치기 시작한 스텝: {reached[0]},  IoU 0.5 에 처음 닿은 스텝: {reached[1]},  0.9: {reached[2]}"
              f"\n  {'':<20} 가는 길의 가장 큰 넓이 = {(path[:, 2] * path[:, 3]).max().item():.4f} (정답 {target[2].item() * target[3].item():.4f})")
    print(f"  학습률을 {lr} 에서 0 까지 곧게 줄이며 같은 {steps} 스텝")
    decayed = {}
    for name, loss_fn in LOSSES.items():
        path, ious = descend(loss_fn, start, target, lr, steps, decay=True)
        decayed[name] = (path, ious)
        print(f"  {name:<20} 마지막 박스 {fmt(path[-1], 3)}  마지막 IoU = {ious[-1].item():.4f}")
    return start, target, results, decayed
[8] 경사 하강법으로 박스 맞추기 (학습률 0.002, 2000 스텝)
  시작 [0.20, 0.24, 0.16, 0.20] → 정답 [0.68, 0.64, 0.30, 0.24],  시작 IoU = 0.0000, GIoU = -0.7637
  1 - IoU              마지막 박스 [0.200, 0.240, 0.160, 0.200]  마지막 IoU = 0.0000  (마지막 10% 구간 최소 0.0000 – 최대 0.0000)
                       겹치기 시작한 스텝: None,  IoU 0.5 에 처음 닿은 스텝: None,  0.9: None
                       가는 길의 가장 큰 넓이 = 0.0320 (정답 0.0720)
  1 - GIoU             마지막 박스 [0.680, 0.640, 0.300, 0.242]  마지막 IoU = 0.9926  (마지막 10% 구간 최소 0.8167 – 최대 0.9941)
                       겹치기 시작한 스텝: 169,  IoU 0.5 에 처음 닿은 스텝: 221,  0.9: 244
                       가는 길의 가장 큰 넓이 = 0.1150 (정답 0.0720)
  L1                   마지막 박스 [0.680, 0.640, 0.300, 0.240]  마지막 IoU = 1.0000  (마지막 10% 구간 최소 0.9704 – 최대 1.0000)
                       겹치기 시작한 스텝: 90,  IoU 0.5 에 처음 닿은 스텝: 195,  0.9: 234
                       가는 길의 가장 큰 넓이 = 0.0720 (정답 0.0720)
  5 L1 + 2 (1 - GIoU)  마지막 박스 [0.707, 0.636, 0.295, 0.252]  마지막 IoU = 0.7986  (마지막 10% 구간 최소 0.5881 – 최대 0.9775)
                       겹치기 시작한 스텝: 16,  IoU 0.5 에 처음 닿은 스텝: 28,  0.9: 45
                       가는 길의 가장 큰 넓이 = 0.0857 (정답 0.0720)
  학습률을 0.002 에서 0 까지 곧게 줄이며 같은 2000 스텝
  1 - IoU              마지막 박스 [0.200, 0.240, 0.160, 0.200]  마지막 IoU = 0.0000
  1 - GIoU             마지막 박스 [0.680, 0.640, 0.300, 0.240]  마지막 IoU = 0.9999
  L1                   마지막 박스 [0.680, 0.640, 0.300, 0.240]  마지막 IoU = 1.0000
  5 L1 + 2 (1 - GIoU)  마지막 박스 [0.680, 0.640, 0.300, 0.240]  마지막 IoU = 0.9999
- 그림: 그림 2-7. 경사 하강법으로 박스 하나를 정답에 맞추기 — (a) 네 손실에서 박스 중심이 지나간 길(회색 칸이 정답, 점선 박스가 시작), (b) \(1 - \operatorname{GIoU}\) 로 갈 때 0, 50, 100, 150, 200 스텝과 마지막의 박스 모습, (c) 학습률이 일정할 때 스텝마다의 IoU, (d) 학습률을 0 까지 곧게 줄였을 때의 IoU. (c)·(d) 의 가로축은 10 스텝 이후 로그 눈금이다.
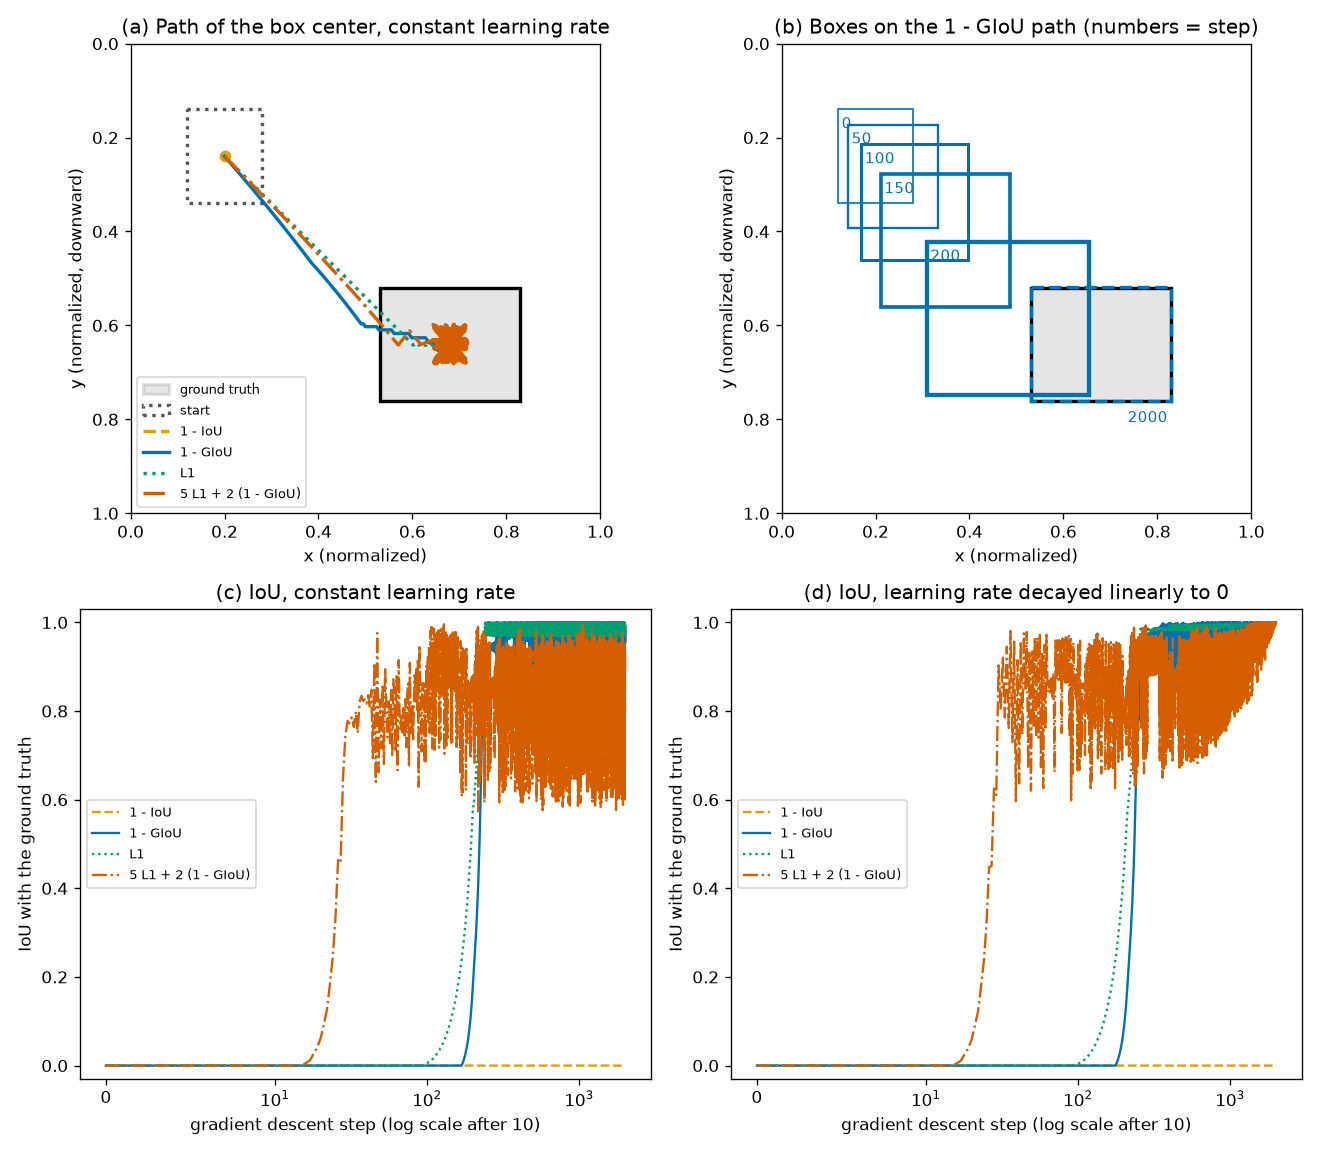
결과를 손실별로, 있는 그대로 읽는다.
- \(1 - \operatorname{IoU}\): 한 발짝도 움직이지 못했다. 2000 스텝 뒤의 박스가 시작 박스 \((0.200, 0.240, 0.160, 0.200)\) 그대로이고 IoU 는 0 이다. 기울기가 정확히 0 이므로 몇 스텝을 돌려도 같다. 그림 2-7 (c) 의 바닥에 붙은 주황 점선이다. 유도와 그림 2-6 의 평지가 예고한 그대로다.
- \(1 - \operatorname{GIoU}\): 도착하지만, 가는 길이 특이하다. 221 스텝에 IoU 0.5, 244 스텝에 0.9 에 닿았다. 그런데 (b) 를 보면 박스가 정답 쪽으로 옮겨 가면서 점점 커진다. 가는 길의 가장 큰 넓이가 0.1150 으로, 정답 넓이 0.0720 의 약 1.6배, 시작 넓이(\(0.16 \times 0.20 = 0.032\))의 약 3.6배다. 앞에서 본 \(\hat{w}\) 성분의 기울기, 곧 "겹치지 않는 동안에는 박스를 키워도 손실이 준다"는 성질이 그대로 나타난 것이다. 정답에 닿은 뒤에야 다시 줄어든다. 또 처음 169 스텝 동안은 IoU 가 0 인 채로(IoU 로만 보면 아무 진전 없이) 다가가다가, 겹치기 시작한 뒤에는 75 스텝 만에 0.9 까지 올라간다. 가까울수록 기울기가 커지기 때문이다(그림 2-5 오른쪽).
- L1: 일정한 속도로 간다. 90 스텝에 겹치기 시작해 195 스텝에 0.5, 234 스텝에 0.9 다. 기울기의 크기가 성분마다 늘 1 이므로 네 숫자가 각각 한 스텝에 정확히 0.002 씩 정답 쪽으로 간다. \(\hat{c}_x\) 는 0.48 을 가야 하니 240 스텝, \(\hat{c}_y\) 는 0.40 이니 200 스텝이 걸린다. 그래서 (a) 의 초록 점선은 정답을 향한 직선이 아니라, 45° 대각선으로 가다가 \(\hat{c}_y\) 가 먼저 도착한 뒤 가로로 꺾인다. 박스의 넓이는 가는 내내 정답 넓이를 넘지 않았다.
- \(5 \cdot \text{L1} + 2 \cdot (1 - \operatorname{GIoU})\): 가장 빨리 닿지만 가장 크게 흔들린다. 28 스텝에 0.5, 45 스텝에 0.9 다. 그런데 이 빠르기는 "두 손실을 합친 효과"가 아니다. 손실에 5 를 곱하면 기울기도 5배가 되고, 이것은 학습률을 5배로 키운 것과 똑같다. 그 대가로 정답 둘레에서의 흔들림도 커져, 마지막 200 스텝 동안 IoU 가 0.5881~0.9775 사이를 오가고 마지막 값은 0.7986 이다. (a) 의 정답 한가운데에 보이는 빨간 뭉치가 그 흔들림이다.
흔들림은 왜 생길까. L1 의 기울기는 정답 바로 옆에서도 크기가 1 이다. 그래서 정답까지 0.0005 가 남았어도 0.002 를 움직여 반대편으로 넘어가고, 다음 스텝에 다시 되돌아온다. L1 만 쓸 때 마지막 구간의 IoU 가 0.9704~1.0000 사이에서 떨리는 까닭이다. 계수 5 가 붙으면 한 스텝이 0.01 이 되어 떨림이 5배가 된다. GIoU 손실도 정답에서 뾰족하다(그림 2-5 왼쪽에서 \(d = 0\) 이 꺾인 꼭짓점이었다). 그래서 \(1 - \operatorname{GIoU}\) 만 쓴 경우에도 마지막 구간에서 0.8167~0.9941 로 흔들린다.
해법은 학습률을 줄여 가는 것이다. 출력의 아래쪽 네 줄과 그림 2-7 (d) 는 학습률을 0.002 에서 0 까지 곧게 줄이며 같은 2000 스텝을 돌린 결과다. 겹치지 않는 평지에 갇힌 \(1 - \operatorname{IoU}\) 만 빼고, 나머지 셋은 모두 IoU 0.9999~1.0000 으로 정답에 내려앉았다. 실제 탐지기 학습에서는 기울기의 크기를 스스로 조절하는 옵티마이저(AdamW, 4장)와 작은 학습률을 쓰고, 박스 숫자를 직접 고치는 것이 아니라 신경망의 가중치를 고치므로 사정이 조금 다르다. 그래도 "L1 의 기울기는 줄어들지 않는다"는 성질은 그대로다.
- 이 실험이 보여 준 것
- IoU 손실은 겹치지 않는 박스를 움직이지 못한다. GIoU 손실은 움직이지만 멀리서는 느리고 박스를 부풀린다. L1 은 거리와 무관하게 일정한 속도로 좌표를 당기지만, 줄어들지 않는 기울기 때문에 학습률을 줄여 주어야 가라앉는다.
- 이 실험이 보여 주지 못한 것
- 박스 하나를 맞추는 이 실험에서는 두 손실을 합친 것이 따로 쓴 것보다 낫다는 증거가 나오지 않았다. 합친 손실이 빨랐던 것은 계수 때문이었다. 둘을 함께 쓰는 이득은 크기가 제각각인 객체가 수없이 나오는 실제 탐지 학습에서 드러나는 것이고, 그 근거는 다음 절에서 DETR 논문의 표로 본다.
도형 세상에서 보기
마지막으로 도형 세상의 그림 위에서 IoU 와 GIoU 를 본다. 객체가 4개인 그림 하나를 골라 정답 박스의 네 숫자에 잡음을 더한다. 흐트러뜨리는 방향은 고정하고 세기 \(\sigma\)("시그마")만 0.01, 0.03, 0.06, 0.10 으로 키운다. \(\sigma\) 는 그림 한 변에 대한 비율이므로 96 픽셀 그림에서는 약 1, 3, 6, 10 픽셀이다.
def jitter_example(seed: int):
    """도형 세상 그림의 정답 박스를 여러 세기로 흐트러뜨리고 IoU · GIoU 를 잰다.

    같은 방향의 흐트러짐(표준 정규 난수 한 벌)에 세기 σ 만 곱해, 같은 픽셀 오차가 큰 박스와 작은 박스에 주는 영향을 본다.
    """
    from rf_shapes import CLASS_NAMES_KO, ShapesDataset

    dataset = ShapesDataset(16, size=96, seed=0)
    index = next(i for i, t in enumerate(dataset.targets) if len(t["labels"]) == 4)  # 객체가 4개인 첫 그림
    image, target = dataset[index]
    boxes = target["boxes"]  # (4, 4) 정규화 (cx, cy, w, h)
    generator = torch.Generator().manual_seed(seed)
    direction = torch.randn(boxes.shape, generator=generator)  # 흐트러뜨릴 방향 (4, 4)
    levels = (0.01, 0.03, 0.06, 0.10)
    print(f"[9] 도형 세상 그림 {index}번의 정답 박스를 흐트러뜨리기 (σ 는 그림 한 변에 대한 비율, 96 픽셀이면 σ × 96 픽셀)")
    print("  객체      너비 × 높이(픽셀)  " + "  ".join(f"σ={s:.2f} IoU / GIoU " for s in levels))
    rows = []
    for sigma in levels:
        noisy = boxes + sigma * direction
        noisy[:, 2:].clamp_(min=0.02)
        iou = paired_box_iou(box_cxcywh_to_xyxy(noisy), box_cxcywh_to_xyxy(boxes))
        giou = paired_generalized_box_iou(box_cxcywh_to_xyxy(noisy), box_cxcywh_to_xyxy(boxes))
        rows.append((sigma, noisy, iou, giou))
    for k in range(len(boxes)):
        cells = "  ".join(f"     {iou[k].item():.3f} / {giou[k].item():6.3f}" for _, _, iou, giou in rows)
        print(f"  {CLASS_NAMES_KO[int(target['labels'][k])]:<5}    {boxes[k, 2].item() * 96:5.1f} × {boxes[k, 3].item() * 96:5.1f}    {cells}")
    return image, target, rows
[9] 도형 세상 그림 0번의 정답 박스를 흐트러뜨리기 (σ 는 그림 한 변에 대한 비율, 96 픽셀이면 σ × 96 픽셀)
  객체      너비 × 높이(픽셀)  σ=0.01 IoU / GIoU   σ=0.03 IoU / GIoU   σ=0.06 IoU / GIoU   σ=0.10 IoU / GIoU
  사각형       20.7 ×  14.5         0.777 /  0.770       0.470 /  0.418       0.203 /  0.043       0.025 / -0.303
  삼각형       29.7 ×  33.0         0.889 /  0.888       0.698 /  0.687       0.469 /  0.425       0.240 /  0.128
  삼각형       36.6 ×  28.0         0.903 /  0.902       0.739 /  0.734       0.551 /  0.533       0.370 /  0.329
  원         23.8 ×  23.8         0.867 /  0.865       0.659 /  0.642       0.439 /  0.384       0.242 /  0.124
그림 5장을 figures/ch02-*.png 로 저장. 걸린 시간 8.3초
- 그림: 그림 2-8. 도형 세상의 정답 박스와 흐트러뜨린 박스 — 정답 박스(초록 실선)와 흐트러뜨린 박스(주황 점선)를 그리고 객체마다 위에 IoU, 아래에 GIoU 를 적은 네 장의 그림이다. 왼쪽부터 잡음 약 1, 3, 6, 10 픽셀이다.
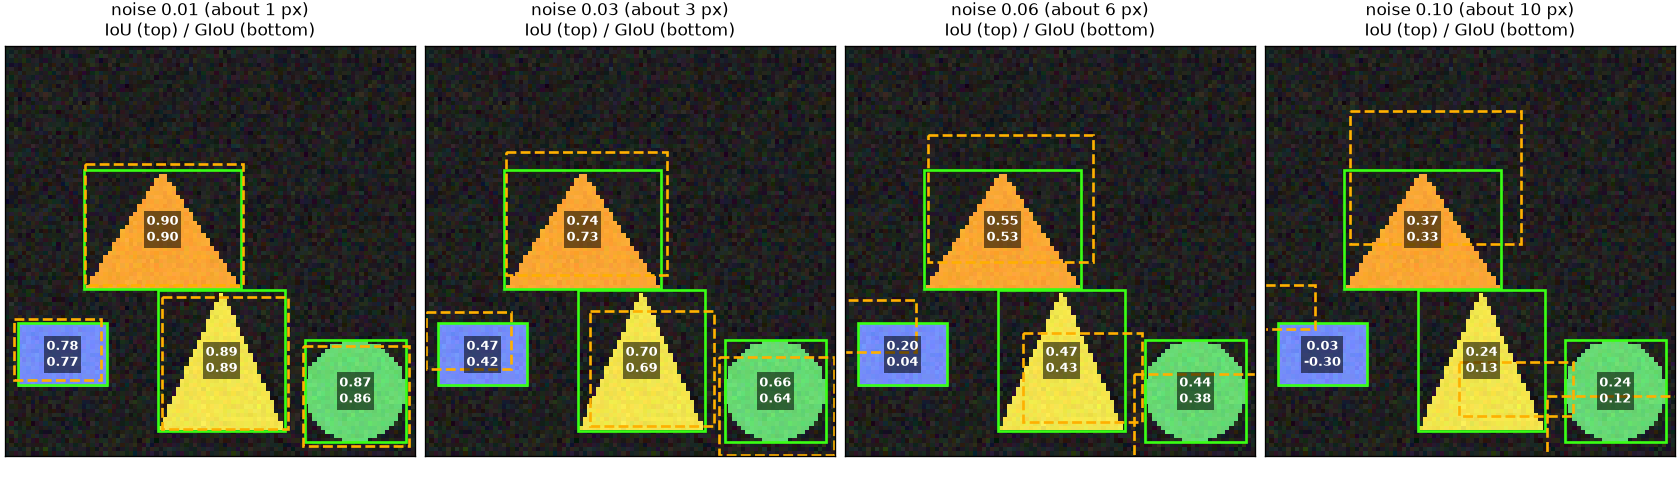
- 1 픽셀 남짓의 잡음(맨 왼쪽): 눈으로는 두 박스가 거의 포개져 보이는데 IoU 는 0.777~0.903 이다. IoU 0.9 가 얼마나 엄격한 기준인지 다시 확인된다.
- 작은 객체가 가장 빨리 무너진다. 가장 작은 사각형(20.7 × 14.5 픽셀)은 3 픽셀 잡음에서 벌써 IoU 0.470 으로 0.5 아래다. 같은 잡음에서 가장 큰 삼각형(36.6 × 28.0 픽셀)은 0.739 다. (객체마다 잡음의 방향이 달라 엄밀한 비교는 아니지만, 앞의 표에서 본 경향과 같다.)
- IoU 와 GIoU 의 차이는 어긋날수록 벌어진다. 잡음 0.01 에서는 둘이 거의 같다(0.777 과 0.770). 잡음 0.10 의 사각형은 IoU 0.025, GIoU −0.303 이다. IoU 는 "거의 안 겹쳤다"까지만 말하고, GIoU 는 거기서 더 내려가 "게다가 빈 곳이 이만큼 있다"를 말한다.
DETR 계열의 박스 손실
지금까지의 내용을 한 줄로 모으면 DETR 과 그 후손들(Deformable DETR, LW-DETR, RF-DETR)이 쓰는 박스 손실이 된다. 매칭된 예측 박스 \(\hat{b}\) 와 정답 박스 \(b\) 한 쌍에 대해
\(\mathcal{L}_{\text{box}}(b, \hat{b}) = \lambda_{\text{L1}}\,\|b - \hat{b}\|_1 + \lambda_{\operatorname{GIoU}}\,\big(1 - \operatorname{GIoU}(b, \hat{b})\big), \qquad \lambda_{\text{L1}} = 5, \quad \lambda_{\operatorname{GIoU}} = 2\)
\(\lambda\)("람다")는 두 손실을 섞는 비율을 정하는 계수(하이퍼파라미터)다. 5 와 2 는 DETR 논문이 정한 값이고, LW-DETR 논문과 RF-DETR 의 공개 코드(bbox_loss_coef=5.0, giou_loss_coef=2.0)도 같은 값을 쓴다. L1 은 정규화 중심 표현 \((c_x, c_y, w, h)\) 로 계산하고, GIoU 는 그것을 모서리 표현으로 바꿔 계산한다. 코드의 detr_box_loss 가 이 식이다.
왜 둘을 함께 쓰는지는 이 장에서 본 것들로 설명된다.
| L1 | \(1 - \operatorname{GIoU}\) | |
| 무엇을 재나 | 네 숫자 각각의 차이 | 겹침과 빈 곳의 비율 |
| 박스 크기에 대해 | 크기를 모른다: 큰 박스와 작은 박스의 같은 오차에 같은 값 | 크기 불변: 같은 비율의 어긋남에 같은 값 |
| 멀리 떨어졌을 때 | 기울기 크기가 늘 1, 꾸준히 당긴다 | 기울기가 살아 있지만 약해지고, 박스를 부풀린다 |
| 정답 가까이에서 | 기울기가 줄지 않는다 | 작은 박스일수록 기울기가 크다 |
| 채점 잣대(IoU)와의 관계 | 간접적 | 직접적(IoU 에서 빈 곳의 벌점만 뺀 값) |
L1 은 좌표를 직접, 거리와 무관하게 당기고, GIoU 는 크기에 무관하게 "채점 잣대로 본 겹침"을 올린다. 서로의 빈자리를 메운다. DETR 논문은 L1 손실이 박스 크기에 따라 달라지는 문제를 줄이려고 크기 불변인 GIoU 손실을 선형 결합했다고 설명하고, 손실 항을 하나씩 뺀 실험(표 4)을 싣고 있다.
| 박스 손실 (DETR 논문 표 4, COCO) | AP | AP50 |
| L1 만 | 35.8 | 57.3 |
| GIoU 만 | 39.9 | 61.6 |
| L1 + GIoU | 40.6 | 61.6 |
AP 는 3장에서 배울 탐지기의 종합 점수다(높을수록 좋다). 이것은 우리의 미니 실험이 아니라 논문이 COCO 데이터셋에서 보고한 값이다. GIoU 손실만으로도 성능의 대부분이 나오고, L1 만 쓰면 크게 떨어지며, 둘을 합치면 가장 좋다.
이 장의 부품들은 뒤에서 다음과 같이 다시 나온다.
- 3장: 예측이 정답을 "맞혔다"고 치는 기준이 IoU 문턱값이다. NMS 도 IoU 로 겹친 예측을 걸러 낸다.
- 7장: 어느 예측을 어느 정답과 짝지을지 정하는 매칭 비용에 L1 거리와 \(-\operatorname{GIoU}\) 가 모든 쌍으로 들어가고, 짝이 정해진 뒤의 손실에 위의 \(\mathcal{L}_{\text{box}}\) 가 짝끼리로 들어간다.
- 9장~11장: 분류 점수의 목표값을 예측 박스와 정답 박스의 IoU 로 정하는 IoU 인지 손실에 짝끼리 IoU 가 쓰인다.
참고: GIoU 뒤에 나온 변형들. GIoU 에도 빈틈이 있다. 그림 2-3 의 아랫줄에서 "가운데는 같고 크기만 다른" 두 경우는 GIoU 가 IoU 와 똑같이 0.50 이다. 한 박스가 다른 박스를 통째로 품으면 둘러싸는 박스 \(C\) 가 큰 박스 자신이 되어 빈 곳이 0 이고, GIoU 는 IoU 에 아무것도 보태지 못한다. 멀리서 기울기가 약해지는 것도 이 장의 실험에서 보았다. 이런 점을 고치려는 변형으로 DIoU 와 CIoU 가 있다(Zheng 등, "Distance-IoU Loss: Faster and Better Learning for Bounding Box Regression", AAAI 2020). 논문 초록에 따르면 DIoU 는 예측 박스와 정답 박스 사이의 정규화한 거리를 손실에 넣고, CIoU 는 겹친 넓이·중심점 거리·가로세로 비라는 세 기하 요소를 함께 고려한다. DETR 계열은 GIoU 를 쓰므로 이 튜토리얼에서는 이름만 소개하고 수식은 다루지 않는다.
정리
- 박스는 숫자 네 개다. 모서리 표현 \((x_0, y_0, x_1, y_1)\) 은 넓이·겹침 계산에, 중심 표현 \((c_x, c_y, w, h)\) 는 예측과 L1 거리에 쓴다. 원점은 왼쪽 위, \(y\) 는 아래로 커진다.
- 이 튜토리얼의 박스는 0~1 의 정규화 좌표다. 해상도가 바뀌어도 같은 숫자다. 픽셀 \(j\) 의 중심은 \((j + 0.5)/\text{size}\) 다.
- 교집합 사각형은 "왼쪽 위는 max, 오른쪽 아래는 min", 겹치지 않으면 0 으로 자른다. 합집합은 \(|A| + |B| - |A \cap B|\).
- \(\operatorname{IoU} = |A \cap B| / |A \cup B|\). 0~1, 대칭, 같을 때만 1, 크기 불변. 너비의 1/3 만 어긋나도 0.5 이고, 작은 박스일수록 같은 픽셀 오차에 더 크게 떨어진다.
- 모든 쌍은
(N, 1, 2)대(1, M, 2)의 브로드캐스팅으로(N, M)표를, 짝끼리는(K,)를 낸다. 매칭에는 앞의 것, 손실에는 뒤의 것. - L1 손실은 어디서나 일정한 기울기로 당기지만 박스 크기를 모른다. IoU 손실은 크기 불변이지만 겹치지 않으면 기울기가 0 이다.
- \(\operatorname{GIoU} = \operatorname{IoU} - (|C| - |A \cup B|)/|C|\). \(-1 \lt \operatorname{GIoU} \le \operatorname{IoU} \le 1\) 이고, 겹치지 않아도 멀수록 낮아져 기울기가 살아 있다.
- DETR 계열의 박스 손실은 \(5 \cdot \text{L1} + 2 \cdot (1 - \operatorname{GIoU})\) 다.
이제 박스 두 개가 얼마나 비슷한지 숫자로 말할 수 있다. 하지만 탐지기는 그림 한 장에 박스를 수십 개 내놓고, 그 가운데에는 맞힌 것도, 엉뚱한 것도, 같은 객체를 두 번 가리킨 것도 섞여 있다. 이 예측 더미 전체에 점수 하나를 매기려면 IoU 위에 한 층이 더 필요하다. 다음 장에서는 IoU 문턱값으로 예측을 맞힘과 틀림으로 나누고, 정밀도와 재현율, 그리고 탐지기의 성적표인 AP 와 mAP 를 손으로 계산해 본다.
확인 문제
- 1. 표현 바꾸기 — 정규화 중심 표현 \((c_x, c_y, w, h) = (0.5, 0.4, 0.2, 0.6)\) 인 박스를 모서리 표현으로 바꾸고, 96×96 그림에서의 픽셀 좌표를 구하라. 이 박스는 가로로 몇 번 픽셀부터 몇 번 픽셀까지를 덮는가(픽셀 중심 규약으로)?
- \((0.5 - 0.1,\ 0.4 - 0.3,\ 0.5 + 0.1,\ 0.4 + 0.3) = (0.4, 0.1, 0.6, 0.7)\). 96 을 곱하면 \((38.4,\ 9.6,\ 57.6,\ 67.2)\). 가로로는 중심 \(j + 0.5\) 가 \(38.4\) 이상 \(57.6\) 이하인 픽셀이므로 \(j = 38\) (중심 38.5)부터 \(j = 57\) (중심 57.5)까지, 20개다.
- 2. IoU 와 GIoU 손계산 — \(A = (0, 0, 4, 4)\), \(B = (2, 2, 6, 6)\) (모서리 표현)의 교집합, 합집합, IoU, 둘러싸는 박스 \(C\), GIoU 를 구하라.
- 넓이는 둘 다 16. 교집합: 가로 \(\min(4, 6) - \max(0, 2) = 2\), 세로도 2, 넓이 4. 합집합 \(16 + 16 - 4 = 28\). \(\operatorname{IoU} = 4/28 = 1/7 \approx 0.1429\). \(C = (0, 0, 6, 6)\), 넓이 36, 빈 곳 \(36 - 28 = 8\). \(\operatorname{GIoU} = 1/7 - 8/36 \approx 0.1429 - 0.2222 = -0.0794\). 겹치는데도 GIoU 는 음수다.
- 3. 떨어진 박스 — \(A = (0, 0, 2, 2)\), \(B = (4, 0, 6, 2)\) 의 IoU 와 GIoU 를 구하라. 가로 겹침을 0 으로 자르지 않으면 어떤 값이 나오는가? 공식 \(\frac{w - d}{w + d}\) 로도 GIoU 를 확인하라.
- 가로 겹침 \(\min(2, 6) - \max(0, 4) = -2\) → 0 으로 자르면 교집합 0, IoU 0. 자르지 않으면 \((-2) \times 2 = -4\) 라는 음수 넓이가 되어 합집합이 \(4 + 4 + 4 = 12\) 로 커지고 IoU 가 \(-1/3\) 이라는 말이 안 되는 값이 된다. 제대로 계산하면 합집합 8, \(C = (0, 0, 6, 2)\) 의 넓이 12, \(\operatorname{GIoU} = 0 - (12 - 8)/12 = -0.3333\). 공식으로는 \(w = 2\), \(d = 4\) 이므로 \((2 - 4)/(2 + 4) = -1/3\). 같다.
- 4. 얼마나 정확해야 하나 — 너비 20 픽셀인 박스를 크기는 정확히 맞히고 가로 위치만 틀렸다. IoU 0.9 이상이 되려면 오차가 몇 픽셀 이하여야 하는가? IoU 0.5 는? 너비가 100 픽셀이라면?
- \(d = w\,\frac{1 - \operatorname{IoU}}{1 + \operatorname{IoU}}\). IoU 0.9: \(d = 20/19 \approx 1.05\) 픽셀. IoU 0.5: \(d = 20/3 \approx 6.67\) 픽셀. 너비 100 이면 각각 \(100/19 \approx 5.26\), \(100/3 \approx 33.3\) 픽셀. 허용되는 오차가 너비에 비례한다. 작은 박스는 1 픽셀 싸움이다.
- 5. 모양 따라가기 —
boxes1의 모양이(300, 4),boxes2가(7, 4)일 때box_iou안의left_top,wh,inter,union의 모양을 차례로 적어라.paired_box_iou(boxes1, boxes2)를 부르면 어떻게 되는가? -
left_top:(300, 1, 2)대(1, 7, 2)→(300, 7, 2).wh:(300, 7, 2).inter:(300, 7).union:(300, 1) + (1, 7) − (300, 7)→(300, 7). 짝끼리 함수는(300, 2)와(7, 2)를 그대로 비교하려 하므로, 맨 앞 축의 길이 300 과 7 이 같지도 않고 어느 쪽도 1 이 아니어서 브로드캐스팅 오류가 난다. 짝끼리 함수에는 같은 개수의, 이미 짝지어진 박스를 넣어야 한다. - 6. 박스 손실 계산 — 정답 \(b = (0.5, 0.5, 0.2, 0.2)\), 예측 \(\hat{b} = (0.6, 0.5, 0.2, 0.2)\) (정규화 중심 표현)의 박스 손실 \(5 \cdot \text{L1} + 2 \cdot (1 - \operatorname{GIoU})\) 를 구하라. 박스의 너비·높이가 둘 다 0.4 였다면(중심은 그대로) 손실은 얼마인가? 두 결과의 차이는 어느 항에서 나오는가?
- L1 은 \(|0.5 - 0.6| = 0.1\) (나머지 성분은 같음). 크기가 같고 가로로만 \(d = 0.1\) 밀린 배치이므로 \(\operatorname{GIoU} = \operatorname{IoU} = \frac{w - d}{w + d} = \frac{0.1}{0.3} = 0.3333\). 손실 \(= 5 \times 0.1 + 2 \times (1 - 0.3333) = 0.5 + 1.3333 = 1.8333\).
- 너비 0.4 이면 L1 은 그대로 0.1, \(\operatorname{GIoU} = \frac{0.4 - 0.1}{0.4 + 0.1} = 0.6\), 손실 \(= 0.5 + 2 \times 0.4 = 1.3\). L1 항은 두 경우가 똑같고(크기를 모른다), 차이 0.5333 은 모두 GIoU 항에서 나온다. 같은 0.1 의 오차를 작은 박스에서 더 크게 꾸짖는 것은 GIoU 항이다.
- 직접 바꿔 보기
-
descent_experiment의 시작 박스를 정답과 조금 겹치게(예:[0.50, 0.50, 0.16, 0.20]) 바꿔 돌려 본다. 이번에는 \(1 - \operatorname{IoU}\) 도 움직일 것이다. 또main의lr=0.002를 0.0004 로 줄이고5 L1 + 2 (1 - GIoU)의 수렴 스텝과 마지막 구간의 흔들림이 어떻게 바뀌는지, L1 만 썼을 때의 원래 결과와 견주어 본다.
See also
- RF-DETR:Tutorial
- RF-DETR
- Object detection
- Bounding box
- Intersection over Union
- Gradient descent
- PyTorch