RF-DETR:Tutorial:09-RT-DETR-LW-DETR
lastmod 2026-11-18created 2026-11-185 edits
실시간 DETR: RT-DETR 과 LW-DETR은 RF-DETR 튜토리얼의 9장이다. 8장까지의 DETR 계열은 정확하고 깔끔했지만 느렸다. 이 장은 그 계보를 실시간 으로 끌어온 두 모델을 본다. RT-DETR(Zhao 외, 2023)은 개념만 짚고, RF-DETR 의 직접적인 바탕인 LW-DETR(Chen 외, 2024)은 부품을 하나씩 뜯어 식 · 손계산 · 구현으로 익힌다. 윈도 어텐션과 윈도 우선 배치, C2f 프로젝터, IoU 인지 BCE 손실, Group DETR, 박스 재매개변수화가 그 부품이고, 10장에서 RF-DETR 을 조립할 때 쓰는 재료가 모두 여기서 나온다.
- 원문: 09. 실시간 DETR: RT-DETR 과 LW-DETR (원문 기준 읽는 시간 약 110분, 난이도 ★★★★☆)
- 실습 코드:
code/ch09_lwdetr_parts.py. 학습은 하지 않고, 부품(윈도 어텐션 · 윈도 우선 배치 · C2f 프로젝터 · IA-BCE 손실 · Group DETR · 박스 재매개변수화)마다 손계산 예를 출력하고 PyTorch 내장 연산과 값을 대조하며 그림 다섯 장을 그린다. 노트북 GPU 에서 약 32초,--quick은 CPU 에서 약 7초다. 이 파일의 부품들은 10장의 미니 RF-DETR 이 그대로 가져다 쓴다. - 이전: 08. Deformable DETR: 필요한 곳만 보기 / 다음: 10. RF-DETR 의 구조
이 장에서 배우는 것
- DETR 계열이 실시간이 되지 못했던 이유와, YOLO 계열의 NMS 시간이 왜 비교에서 문제가 되는지
- RT-DETR 이 내놓은 세 가지 생각(하이브리드 인코더, 질의 선택, 디코더 층 수 조절)을 논문이 밝힌 범위에서
- LW-DETR 의 전체 구조: ViT 인코더 → 프로젝터 → 얕은 디코더, 그리고 다섯 가지 크기
- 윈도 어텐션의 연산 수를 유도하고, 전역 층을 사이에 끼워야 하는 이유를 실험으로 확인하기
- 윈도 우선 배치: 토큰을 윈도 단위로 늘어놓으면 왜 순서 바꾸기가 사라지는지, 논문의 4×4 예를 손으로 따라가기
- 다층 특징 집계와 C2f 프로젝터: 채널 수와 매개변수 수를 손으로 세기
- IoU 인지 BCE 손실(IA-BCE): 논문의 식, 공식 구현과의 대응, "점수가 IoU 로 끌려간다" 는 고정점의 유도와 손계산
- Group DETR: 질의를 묶음으로 복제해 감독 신호를 늘리는 방법과, 묶음끼리 서로 보지 못하게 하는 이유
- 박스 재매개변수화: 8장의 로짓 공간 덧셈과 무엇이 다른지, 같은 변화량이 박스 크기와 무관하게 같은 뜻이 되는 이유
- 논문이 보고한 수치와 이 튜토리얼이 잰 수치를 구별해 읽기(이 장의 측정에서는 재현되지 않은 것이 있다)
- 이 장의 표기
-
- \(N\): 인코더가 다루는 토큰(패치)의 수(5장 · 6장과 같다). 7 · 8장에서 \(N\) 은 객체 질의의 수였지만, 이 장에서는 질의의 수를 \(N_q\) 로 적는다. 코드의 독스트링은 질의 수를
N으로 적는다((B, G·N, D)). - \(W_n\): 한 변의 윈도 수. 토큰 격자를 가로 \(W_n\) 등분, 세로 \(W_n\) 등분해 윈도 \(W_n^2\) 개를 만든다. 코드의
num_windows와 로그의W_n이 이것이다. LW-DETR 논문이 "윈도 16개" 라고 할 때는 \(W_n = 4\) 이다. - \(p\): 시그모이드를 거친 분류 점수(4장의 표기). LW-DETR 논문은 이것을 \(s\) 로 쓴다. \(z\) 는 로짓, \(t\) 는 분류의 목표값, \(u\) 는 예측 박스와 정답 박스의 IoU 이다.
- \(\alpha\): 이 장에서는 IA-BCE 의 지수(\(t = p^{\alpha} u^{1-\alpha}\), 값 0.25)이다. 4장 포컬 손실의 균형 가중치 \(\alpha\) 와 글자도 값도 같지만 다른 것 이다. 포컬 손실의 것을 가리킬 때는 "포컬 손실의 \(\alpha\)" 라고 밝혀 적는다. \(\gamma\) 는 두 손실 모두에서 조절 인자의 지수(값 2)이다.
- \(G\): 질의 묶음의 수(Group DETR 논문의 \(K\)). \(T\): 그림 한 장의 정답 수(7장).
- 기준 박스는 \((x_r, y_r, w_r, h_r)\), 머리가 낸 변화량은 \((\delta_x, \delta_y, \delta_w, \delta_h)\), 그 결과인 예측 박스는 \((\hat{x}, \hat{y}, \hat{w}, \hat{h})\) 로 적는다. \(x, y\) 는 박스 중심 의 좌표이고, 모두 2장의 정규화 좌표이다. LW-DETR 논문은 기준 박스(제안)를 글자 p 로, 예측 박스를 글자 b 로 쓰지만 이 장에서 \(p\) 는 점수이다.
- \(c\): C2f 블록 안의 가지 하나의 채널 수(출력 채널의 절반). \(n\): C2f 안의 병목 수.
- "손으로 따라가는 4×4 예" 에서만 쓰는 번호 글자가 있다. \(r, c\) 는 칸의 행 · 열 번호, \(a, b\) 는 윈도의 행 · 열 번호, \(i, j\) 는 윈도 안에서의 행 · 열 번호, \(k\) 는 윈도 우선 배치에서의 자리이다. 이 절 밖에서 \(c\) 는 위의 채널 수이고, \(i, j\) 는 손실의 식에서 양성 칸 · 음성 칸을 세는 번호, \(k\) 는 그때그때 밝히는 번호나 배율이다.
- \(N\): 인코더가 다루는 토큰(패치)의 수(5장 · 6장과 같다). 7 · 8장에서 \(N\) 은 객체 질의의 수였지만, 이 장에서는 질의의 수를 \(N_q\) 로 적는다. 코드의 독스트링은 질의 수를
실시간이라는 목표
1장에서 실시간을 "쓰는 곳이 요구하는 시간 안에 답을 낸다" 로 정했다. 초당 30장짜리 카메라라면 한 장에 33밀리초이다. 8장의 끝에서 본 대로 Deformable DETR 은 논문 기준으로 초당 19장이었다. 한 장에 약 53밀리초이니 이 기준에 닿지 못한다. 그 사이 실시간 탐지의 자리는 합성곱으로 만든 YOLO 계열이 차지하고 있었다. 이 장의 두 논문은 제목부터 그 자리를 겨눈다. RT-DETR 의 제목은 "DETRs Beat YOLOs on Real-time Object Detection" 이고, LW-DETR 의 제목은 "A Transformer Replacement to YOLO for Real-Time Detection" 이다.
DETR 계열은 어디가 무거웠나
앞의 세 장에서 본 것을 속도의 눈으로 다시 모으면 무거운 곳이 셋이다.
- 인코더의 어텐션. 자기 어텐션은 토큰 \(N\) 개가 서로를 모두 보므로 쌍의 수가 \(N^2\) 이다(5장). 해상도를 두 배로 올리면 토큰은 4배, 쌍은 16배가 된다.
- 다중 스케일. 작은 객체를 찾으려고 해상도가 다른 특징 맵을 여러 장 쓰면 토큰이 크게 늘어난다. 640×640 그림에서 스트라이드 32 인 맵 한 장은 \(20 \times 20 = 400\) 칸이지만, 스트라이드 8 · 16 · 32 의 세 장을 함께 쓰면 \(80^2 + 40^2 + 20^2 = 6400 + 1600 + 400 = 8400\) 칸으로 21배이다. Deformable DETR 은 변형 어텐션으로 칸 하나가 읽는 자리의 수를 줄였지만, 칸의 수 자체는 그대로이다. RT-DETR 논문은 이 점을 짚어, 다중 스케일 특징 때문에 길어진 토큰 열이 인코더를 계산의 병목으로 만든다고 적는다. 다른 연구(Lin 외)를 인용해 Deformable DETR 에서 인코더가 GFLOPs 의 49% 를 쓰면서 AP 에는 11% 만 이바지한다는 수치도 든다.
- 여섯 층 디코더. DETR 과 그 뒤의 모델들은 보통 디코더를 6층 쌓는다. 층마다 자기 어텐션, 교차 어텐션, FFN 이 한 번씩 돈다.
결과는 숫자로 남아 있다. RT-DETR 논문은 당시 정확도가 높던 DETR 계열 모델(DINO-Deformable-DETR-R50)의 속도를 초당 5장으로 적는다(자기 모델의 초당 108장과 견주는 대목). 정확도는 YOLO 를 넘어섰지만 속도는 한참 모자랐다.
YOLO 와 NMS 의 시간
YOLO 계열은 신경망 자체가 가볍고 빠르다. 그런데 3장에서 본 것처럼 이 계열은 같은 객체에 박스를 여러 개 내므로 뒤에 NMS(비최대 억제)를 붙여야 한다. 두 논문은 이 NMS 의 시간을 따진다. 논문에 실린 속도가 대개 신경망의 시간만이고 NMS 의 시간은 빠져 있다는 것이다.
- RT-DETR 논문(3절) 은 NMS 의 시간이 박스의 수와 두 문턱값(점수 문턱값, IoU 문턱값)에 달려 있음을 YOLOv8 로 잰다. 논문 표 1 에서 IoU 문턱값 0.7 일 때 점수 문턱값이 0.001 이면 AP 52.9 에 NMS 2.36 ms, 0.05 로 올리면 NMS 는 1.06 ms 로 줄지만 AP 가 51.2 로 내려간다(T4, TensorRT FP16, NMS 커널의 실행 시간만 잰 값). 점수 문턱값을 낮추면 NMS 에 들어가는 박스가 많아져 느려지고, 높이면 빨라지는 대신 정확도를 잃는다.
- LW-DETR 논문(표 3) 은 신경망 시간과 NMS 까지 포함한 전체 시간을 나란히 적는다. YOLOv8n 은 신경망만 1.5 ms 인데, 공식 설정의 NMS 를 포함하면 6.2 ms 이다. 논문은 모델이 작을수록 전체 시간을 NMS 가 좌우한다고 적는다. 점수 문턱값을 잘 고르면 1.6 ms 까지 줄어들지만(mAP 는 37.4 → 37.3), 그 값은 사람이 데이터에 맞춰 찾아야 한다.
DETR 계열은 7장의 일대일 매칭 덕분에 NMS 가 필요 없다. 신경망의 출력이 곧 최종 답이므로 "신경망 시간 = 전체 시간" 이다. 그래서 물음은 이렇게 바뀐다. 신경망 자체를 YOLO 만큼 가볍게 만들 수 있다면, NMS 가 없는 만큼 DETR 계열이 유리하지 않겠는가. 두 논문은 이 물음에 서로 다른 길로 답한다.
- 속도 숫자를 읽을 때
- 이 장에 나오는 지연 시간은 논문마다 잰 장비와 방법이 다르다. RT-DETR 과 LW-DETR 은 둘 다 T4 GPU 와 TensorRT FP16 을 쓰지만 TensorRT 판과 재는 절차가 같지 않고, RF-DETR 논문은 다시 자기 기준으로 모든 모델을 새로 쟀다(1장). 예를 들어 LW-DETR 논문은 자기 모델 tiny 를 2.0 ms · 42.6 mAP 로 적고, RF-DETR 논문의 표 2 는 같은 모델을 1.9 ms · 42.9 AP 로 적는다. 한 표 안의 숫자끼리만 견주는 것이 안전하다.
RT-DETR: DETR 이 YOLO 를 이긴다는 주장
RT-DETR(Real-Time DEtection TRansformer)(Zhao 외, arXiv 2304.08069)은 논문 초록에서 스스로를 "저자들이 아는 한 첫 실시간 종단 간 객체 탐지기" 라고 부른다. COCO 에서 RT-DETR-R50 이 AP 53.1 에 T4 기준 초당 108장, R101 이 AP 54.3 에 초당 74장이라고 보고하고, 같은 크기의 YOLO 들을 속도와 정확도 양쪽에서 앞선다고 주장한다. 이 튜토리얼은 RT-DETR 을 구현하지 않는다. RF-DETR 의 바탕은 LW-DETR 이기 때문이다. 다만 RT-DETR 이 내놓은 생각 가운데 뒤에서 다시 만나는 것이 있어, 논문이 밝힌 범위에서 세 가지만 짚는다.
효율적인 하이브리드 인코더
RT-DETR 은 CNN 백본(ResNet 등)이 낸 세 해상도의 특징 맵을 받는다. Deformable DETR 은 이 세 장의 칸을 모두 한 줄로 이어 Transformer 인코더에 넣었다. 앞에서 센 8,400칸짜리 토큰 열이다. RT-DETR 은 인코더가 하던 일을 둘로 나눠 본다.
- 같은 해상도 안에서의 상호작용(intra-scale interaction): 한 특징 맵의 칸들이 서로를 보는 일
- 해상도 사이의 융합(cross-scale fusion): 서로 다른 해상도의 특징 맵을 섞는 일
그리고 두 일을 한꺼번에 하지 않고 떼어 놓는다. 자기 어텐션은 가장 거친 특징 맵(스트라이드 32, 논문의 \(S_5\)) 한 장에만 Transformer 인코더 층 하나로 적용하고, 해상도 사이의 융합은 어텐션이 아니라 합성곱으로 만든 블록에 맡긴다. 어텐션(Transformer)과 합성곱(CNN)을 섞어 쓴다고 해서 논문은 이것을 "하이브리드 인코더" 라고 부른다. 가장 거친 맵에만 어텐션을 쓰는 이유로 논문은, 의미 정보가 풍부한 높은 수준의 특징에 자기 어텐션을 적용하는 것이 객체 사이의 관계를 잡는 데 도움이 되고, 낮은 수준의 특징끼리의 상호작용은 필요하지 않다고 설명한다. 640×640 그림이라면 어텐션이 다루는 토큰이 8,400개에서 400개로 줄고, 쌍의 수는 \(8400^2 / 400^2 = 441\) 분의 1 이 된다(이 나눗셈은 논문의 수치가 아니라 앞의 칸 수로 한 계산이다).
질의 선택과 디코더 층 수 조절
둘째는 디코더에 넣을 처음 질의를 고르는 방법이다. 8장의 2단계 방식은 인코더 출력의 칸마다 분류 점수를 내고 점수가 높은 칸을 골랐다. RT-DETR 논문은 여기에 문제가 있다고 본다. 분류 점수만으로 고르면, 클래스는 맞지만 위치가 부정확한 칸도 뽑힌다는 것이다. 그래서 분류와 위치의 예측이 얼마나 어긋나는지를 "불확실성" 으로 정의해 손실에 넣는 방법(논문의 이름으로 uncertainty-minimal query selection)을 제안하고, 이것으로 AP 가 47.9 에서 48.7 로 올랐다고 보고한다. 식의 세부는 이 튜토리얼의 범위 밖이다. 기억해 둘 것은 문제의식이다. 분류 점수가 박스의 품질을 말해 주지 않는다 는 것으로, 이 장 뒤쪽의 IoU 인지 BCE 손실이 겨누는 바로 그 문제이다.
셋째는 디코더 층 수로 속도를 조절 할 수 있다는 관찰이다. DETR 계열은 디코더의 모든 층에 보조 손실을 걸어 학습하므로(7장), 어느 층의 출력이든 그대로 예측으로 쓸 수 있다. RT-DETR 논문 표 5 에서 6층으로 학습한 RT-DETR-R50 은 마지막 층을 떼고 5층까지만 써도 AP 가 53.1 에서 53.0 으로 0.1 만 내려가고, 지연 시간은 9.3 ms 에서 8.8 ms 로 줄어든다. 재학습은 필요 없다. RF-DETR 은 이 생각을 훨씬 넓혀, 디코더 층 수를 포함한 다섯 손잡이를 재학습 없이 돌린다(12장).
다른 길: 평범한 ViT
RT-DETR 의 답은 "CNN 백본을 그대로 두고, 그 뒤의 인코더를 가볍게 다시 설계한다" 이다. LW-DETR 은 같은 때에 나온 연구로, 논문 스스로 RT-DETR 을 "CNN 백본에 초점을 둔" 동시대의 작업이라고 부르고 자기 쪽은 평범한 ViT(plain ViT) 백본으로 실시간 탐지가 되는지를 본다고 적는다. 여기서 "평범한" 은 6장에서 만든 그 ViT 를 뜻한다. 처음부터 끝까지 해상도가 하나이고, 블록마다 똑같은 구조를 쌓은 것이다.
이 선택이 RF-DETR 로 이어지는 갈림길이다. 인코더가 평범한 ViT 이면 사전 학습된 ViT 의 가중치를 그대로 실어 올 수 있다. LW-DETR 은 CAEv2 로 사전 학습한 ViT 를 썼고, RF-DETR 은 그 자리에 DINOv2 를 넣는다(10장). 대신 ViT 의 전역 자기 어텐션이 가진 제곱 비용을 어떻게든 줄여야 하고, 한 해상도뿐인 특징 맵을 탐지에 맞게 다듬어야 한다. 이 장의 나머지가 그 이야기이다.
LW-DETR 의 전체 구조
LW-DETR(Light-Weight DETR)(Chen 외, arXiv 2406.03459, 2024)은 논문 초록의 말로 "ViT 인코더, 프로젝터, 얕은 DETR 디코더를 단순히 쌓은 것" 이다. 새 연산을 발명하기보다 이미 나와 있던 기법을 골라 묶고, 속도를 위한 구현 하나(윈도 우선 배치)와 인코더의 개선 하나(다층 특징 집계)를 보탰다.
원문 그림 9-1(도식): LW-DETR 의 구조. 그림이 ViT 인코더에 들어가고, 인코더의 여러 층에서 꺼낸 특징 맵이 프로젝터를 거쳐 3층 디코더로 간다. 프로젝터 출력에서 고른 상위 칸이 디코더의 기준 박스가 된다. LW-DETR 의 구조(개념도). 파란 테두리는 윈도 어텐션 블록, 주황 테두리는 전역 어텐션 블록이다. 블록의 수와 어느 층에서 특징 맵을 꺼내는지는 모델 크기마다 다르다.
그림 9-1 을 왼쪽에서 오른쪽으로 읽는다.
- ViT 인코더. 그림을 패치로 잘라 토큰으로 만들고 Transformer 블록을 통과시킨다. 블록 가운데 일부는 윈도 어텐션, 나머지는 전역 어텐션이다.
- 다층 특징 집계. 마지막 블록의 출력만 쓰지 않고, 중간 블록 몇 개의 출력도 함께 꺼내 모은다.
- 프로젝터. 모은 특징 맵을 합성곱 블록(C2f)으로 섞어 디코더가 읽을 특징 맵으로 만든다.
- 섞은 질의 선택. 프로젝터 출력의 칸마다 점수와 박스를 내고, 점수가 높은 칸의 박스를 디코더의 기준 박스로 삼는다(8장의 2단계 방식).
- 디코더 3층. 층마다 자기 어텐션 → 변형 교차 어텐션(8장) → FFN. 층마다 분류 머리와 박스 머리가 예측을 낸다.
세 덩어리: 인코더 · 프로젝터 · 디코더
이 구조를 부르는 이름을 정리해 둔다. 앞 장들에서 이미 써 온 말이지만, 10장부터는 이 이름으로 부품을 가리키므로 여기서 한 번 못 박는다.
- 백본(backbone): 그림에서 특징을 뽑아내는 신경망의 몸통이다. 7 · 8장에서는 작은 CNN 이었고, LW-DETR 과 RF-DETR 에서는 ViT 이다. LW-DETR 논문은 이 ViT 를 "인코더" 라고 부른다. 7장의 DETR 에서는 CNN 백본 뒤에 Transformer 인코더가 따로 있었지만, 여기서는 ViT 하나가 두 역할을 한다. 그래서 이 계열에서 백본과 인코더는 같은 것 을 가리킨다.
- 특징 맵(feature map): 그림을 격자로 나눈 칸마다 벡터가 하나씩 놓인 텐서이다. 모양은
(B, C, H, W)로, 칸이 \(H \times W\) 개이고 칸마다 길이 \(C\) 의 벡터(채널)가 있다. ViT 의 패치 토큰(B, H·W, C)를 격자 모양으로 되접은 것도 특징 맵이다. 두 모양은 같은 값을 다르게 늘어놓았을 뿐이다. - 프로젝터(projector): 백본과 디코더 사이를 잇는 합성곱 블록이다. 백본이 낸 특징 맵(들)을 받아 디코더가 읽을 채널 수와 해상도의 특징 맵으로 바꾼다.
- 예측 머리(prediction head), 줄여서 머리: 디코더가 낸 질의 벡터를 최종 예측으로 바꾸는 작은 신경망이다. 클래스 로짓을 내는 분류 머리(선형 층 하나)와 박스의 변화량 네 개를 내는 박스 머리(3층 MLP)가 있다. 몸통(백본)이 뽑은 특징 위에 얹혀 답을 낸다고 해서 머리라고 부른다.
다섯 가지 크기
LW-DETR 논문 표 1 은 같은 구조를 다섯 크기로 만든다. 뒤의 세 열은 논문 표 3 의 COCO 결과이다(Objects365 사전 학습 포함, T4 · TensorRT FP16).
| 크기 | 인코더 층 | 차원 | 전역 / 윈도 층 | 프로젝터 차원 · 스케일 | 디코더 층 | 질의 | 매개변수 | 지연 | mAP |
| tiny | 6 | 192 | 3 / 3 | 256 · 1/16 | 3 | 100 | 12.1M | 2.0 ms | 42.6 |
| small | 10 | 192 | 4 / 6 | 256 · 1/16 | 3 | 300 | 14.6M | 2.9 ms | 48.0 |
| medium | 10 | 384 | 4 / 6 | 256 · 1/16 | 3 | 300 | 28.2M | 5.6 ms | 52.5 |
| large | 10 | 384 | 4 / 6 | 384 · 1/8, 1/32 | 3 | 300 | 46.8M | 8.8 ms | 56.1 |
| xlarge | 10 | 768 | 4 / 6 | 384 · 1/8, 1/32 | 3 | 300 | 118.0M | 19.1 ms | 58.3 |
표에서 읽을 것:
- 인코더는 얕고 좁다. 6장에서 본 ViT-S 가 12층 · 384차원이었는데, small 은 10층 · 192차원이다. 크기를 키울 때 바뀌는 것은 주로 인코더의 차원이다(192 → 384 → 768).
- 절반 넘는 층이 윈도 어텐션이다. small 부터는 10층 가운데 6층이 윈도, 4층이 전역이다.
- 디코더는 어느 크기든 3층이다.
- 스케일. tiny · small · medium 은 그림의 1/16 해상도 특징 맵 한 장만 쓰고, large · xlarge 는 1/8 과 1/32 의 두 장을 쓴다.
얕은 디코더
디코더를 6층에서 3층으로 줄인 것은 논문이 수치로 밝힌 결정이다. 3.1절은 이렇게 적는다. DETR 과 그 변형들은 보통 디코더 6층을 쓰지만 LW-DETR 은 3층을 쓰고, 이것으로 디코더의 시간이 1.4 ms 에서 0.7 ms 로 줄어든다. tiny 모델의 나머지 부분이 1.3 ms 이므로 이 0.7 ms 는 작지 않은 몫이다.
숫자를 한 번 맞춰 본다. 나머지 1.3 ms 에 디코더 0.7 ms 를 더하면 2.0 ms 로, 위 표의 tiny 지연 시간과 같다. 디코더가 6층이었다면 \(1.3 + 1.4 = 2.7\) ms 였을 것이다. 층 수가 절반이 되니 시간도 절반이 된 것은, 디코더 층이 모두 같은 구조이고 차례로 실행되기 때문이다.
층을 줄이면 정확도는 어떻게 될까? 논문은 이 대목에서 정확도의 변화를 따로 적지 않는다. 대신 뒤에서 볼 학습 기법들(IA-BCE, Group DETR, 사전 학습)로 얕은 디코더의 정확도를 끌어올린다. 층마다의 변형 교차 어텐션은 8장에서 만든 그대로이고, 질의가 프로젝터의 특징 맵에서 기준 박스 둘레의 표본점 몇 개만 읽는다.
논문이 보고한 속도와 정확도
위 표의 마지막 세 열이 LW-DETR 의 성적이다. 논문 표 3 은 같은 자리에서 잰 YOLO 계열과 나란히 놓는다. small 크기에서 견주면 이렇다(모두 Objects365 사전 학습을 쓴 값, 전체 지연은 공식 설정의 NMS 포함).
| 모델 | 매개변수 | 신경망 지연 | 전체 지연 | mAP |
| YOLOv8s | 11.2M | 2.6 ms | 7.0 ms | 45.2 |
| RTMDet-s | 8.9M | 2.8 ms | 7.9 ms | 44.9 |
| YOLO-NAS-s | 19.0M | 2.8 ms | 4.7 ms | 47.6 |
| LW-DETR-small | 14.6M | 2.9 ms | 2.9 ms | 48.0 |
신경망만의 시간은 넷이 비슷하다(2.6 – 2.9 ms). 차이는 NMS 에서 난다. LW-DETR 은 NMS 가 없으므로 전체 지연이 그대로 2.9 ms 이다. 논문은 YOLO 쪽의 점수 문턱값을 손봐 NMS 시간을 줄인 값도 함께 싣는데, 그렇게 해도 LW-DETR 이 앞선다고 보고한다(예: YOLO-NAS-s 는 2.9 ms · 47.3 mAP). 같은 때의 RT-DETR 과도 견주어, LW-DETR-large(8.8 ms · 56.1)가 RT-DETR-R50(55.3)보다 0.8 mAP 높고 더 빠르다고 적는다(RT-DETR-R50 의 지연은 논문 표 4 에 9.3 ms, 본문에 9.9 ms 로 적혀 있다. 표의 값은 RT-DETR 논문의 보고값과 LW-DETR 저자들이 잰 값 가운데 좋은 쪽이다).
여기까지가 겉모습이다. 이제 부품을 하나씩 연다. 순서는 데이터가 흐르는 순서 그대로이다. 인코더 안의 윈도 어텐션과 윈도 우선 배치, 다층 특징 집계, 프로젝터를 먼저 보고, 이어서 학습을 돕는 세 가지(IA-BCE, Group DETR, 박스 재매개변수화)를 본다.
윈도 어텐션
평범한 ViT 를 탐지에 쓰려면 먼저 넘어야 할 것이 자기 어텐션의 제곱 비용이다. LW-DETR 은 640×640 그림을 16×16 패치로 자른다. 한 변에 \(640 / 16 = 40\) 개, 모두 \(N = 1600\) 개의 토큰이다. 전역 자기 어텐션 한 번이 계산하는 (질의, 열쇠) 쌍은 \(1600^2 = 2{,}560{,}000\) 개이고, 이것을 층마다 되풀이한다. 6장에서 예고한 대로, 해법은 토큰을 몇 구역으로 나눠 구역 안에서만 어텐션을 하는 것이다.
윈도 안에서만 보기
토큰 격자를 겹치지 않는 네모 구역으로 나눈다. 이 구역 하나가 윈도(window)이다. 윈도 어텐션(window attention) 은 자기 어텐션을 윈도마다 따로 하는 것이다. 토큰은 자기와 같은 윈도에 있는 토큰만 본다. 이와 구별해, 모든 토큰이 모든 토큰을 보는 보통의 자기 어텐션을 전역 어텐션(global attention) 이라고 부른다.
백 명이 한 강당에서 회의를 하면 누구나 누구의 말이든 들을 수 있지만, 한 사람이 챙겨 들어야 할 상대가 아흔아홉 명이다. 스물다섯 명씩 네 방으로 나눠 조별 토론을 하면 챙길 상대가 스물네 명으로 줄어든다. 대신 옆방에서 무슨 말이 오갔는지는 모른다. 그래서 조별 토론 사이사이에 전체 회의를 한 번씩 끼워, 방마다의 이야기를 서로 전한다. 조별 토론이 윈도 어텐션, 전체 회의가 전역 어텐션이다.
이 방식은 LW-DETR 이 처음 만든 것이 아니다. 논문은 ViTDet(Li 외, 2022, "Exploring Plain Vision Transformer Backbones for Object Detection")을 따랐다고 밝힌다. ViTDet 은 사전 학습된 평범한 ViT 를 탐지 백본으로 쓰면서, 블록 대부분을 겹치지 않는 윈도 어텐션으로 돌리고 몇 개의 블록(기본 4개)만 윈도를 넘어 정보를 전하게 했다. 윈도를 층마다 반 칸씩 옮기는 방식(Swin 의 shifted window)을 쓰지 않고도, 정보가 윈도 사이로 잘 전해지기만 하면 충분하다는 것이 그 논문의 관찰이다.
구현은 뜻밖에 간단하다. 윈도 어텐션을 위한 특별한 어텐션 코드는 없다. 5장에서 본 대로 어텐션은 배치의 한 줄 안에서만 일어난다. 그림 1번의 토큰이 그림 2번의 토큰을 보는 일은 없다. 그러니 윈도를 배치 축에 올리면 된다. 토큰 (B, N, D) 를 윈도별로 잘라 (B·W_n², N/W_n², D) 로 만들어 보통의 자기 어텐션에 넣으면, 어텐션은 저절로 윈도 안에서만 일어난다. 미니 모델의 숫자로는 (2, 144, 96) 이 (8, 36, 96) 이 된다. 그림 2장 × 윈도 4개 = 8줄, 한 줄에 토큰 36개이다.
쌍의 수 세기
얼마나 줄어드는지 센다. 토큰이 \(N\) 개이고, 격자를 한 변 \(W_n\) 등분해 윈도 \(W_n^2\) 개를 만든다고 하자.
- 어텐션 한 번의 (질의, 열쇠) 쌍의 수: 전역과 윈도
- \(\text{전역 어텐션의 쌍} = N \times N = N^2\)
- 질의 \(N\) 개가 저마다 열쇠 \(N\) 개를 본다(자기 자신 포함).
- 토큰 \(N\) 개를 윈도 \(W_n^2\) 개가 똑같이 나눠 갖는다. 그러려면 격자의 한 변이 \(W_n\) 의 배수여야 한다.
- 윈도 안에서는 전역 어텐션과 똑같이 모두가 모두를 본다. 토큰 수만 \(N / W_n^2\) 로 줄었다.
- 윈도가 \(W_n^2\) 개 있으므로 윈도 하나의 쌍에 윈도 수를 곱한다.
- \(W_n^2\) 하나가 약분된다. 쌍의 수가 윈도 수만큼 나뉜다. 한 변을 2등분(\(W_n = 2\), 윈도 4개)하면 4분의 1, 4등분(\(W_n = 4\), 윈도 16개)하면 16분의 1 이다.
미니 모델의 격자(12×12, \(N = 144\))에 넣어 본다. 전역은 \(144^2 = 20{,}736\) 쌍이다. \(W_n = 2\) 이면 윈도 하나에 \(144 / 4 = 36\) 토큰, 윈도 하나의 쌍이 \(36^2 = 1{,}296\), 윈도 4개를 합쳐 \(4 \times 1{,}296 = 5{,}184\) 쌍이다. \(20{,}736 / 4 = 5{,}184\) 로 식과 맞는다. 실습 코드가 세 격자 크기에 대해 찍은 표이다.
  어텐션 한 번이 계산하는 (질의, 열쇠) 쌍의 수 — 전역 N² 과 윈도 W_n²·(N/W_n²)² = N²/W_n²
  토큰 격자 |    N |    전역 N² | 윈도 2×2 | 윈도 3×3 | 윈도 4×4
    12×12  |  144 |     20,736 |    5,184 |    2,304 |    1,296
    24×24  |  576 |    331,776 |   82,944 |   36,864 |   20,736
    48×48  | 2304 |  5,308,416 | 1,327,104 |  589,824 |  331,776
LW-DETR 의 설정도 계산해 본다. 논문은 640×640 입력에서 윈도 하나를 10×10 토큰으로 잡는다. 40×40 격자를 한 변 4등분한 것이니 윈도는 16개이다(논문 부록의 "window numbers 16"). 전역 어텐션의 \(2{,}560{,}000\) 쌍이 윈도 어텐션에서는 \(16 \times 100^2 = 160{,}000\) 쌍, 16분의 1 이 된다.
- 줄어드는 것은 제곱 항뿐이다
- 6장에서 ViT 블록 하나의 곱셈 수를 \(12ND^2 + 2N^2D\) 로 어림했다. 앞 항은 선형 층들(질의 · 열쇠 · 값 투영, 출력 투영, MLP)이고 토큰 수에 비례 한다. 뒤 항이 어텐션의 쌍에서 나오는 제곱 항이다. 윈도 어텐션이 줄이는 것은 뒤 항뿐이다. 선형 층은 토큰마다 따로 계산되므로 토큰을 어떻게 나누든 그대로이다. 그래서 윈도 어텐션의 이득은 제곱 항이 얼마나 큰 몫을 차지하느냐, 곧 두 항의 비 \(2N^2D / 12ND^2 = N / 6D\) 에 달려 있다. 토큰이 많을수록 이득이 크다. 이 장 뒤쪽에서 잰 시간이 정확히 이 모양으로 나온다.
전역 층을 사이에 끼우기
모든 블록을 윈도 어텐션으로 바꾸면 가장 싸지만, 그러면 윈도 경계를 넘는 정보가 영영 전해지지 않는다. 윈도 둘에 걸친 큰 객체가 있어도, 한쪽 윈도의 토큰은 다른 쪽 절반을 끝까지 보지 못한다. 그래서 일부 블록은 전역 어텐션으로 남긴다. LW-DETR 논문은 이것을 "윈도 어텐션과 전역 어텐션을 번갈아(interleaved)" 놓는다고 표현하고, 6층 ViT 라면 첫째 · 셋째 · 다섯째 층을 윈도 어텐션으로 한다고 예를 든다. 앞의 표에서 본 대로 tiny 는 윈도 3 · 전역 3, small 부터는 윈도 6 · 전역 4 이다.
인코더 전체에서 어텐션의 쌍이 얼마나 줄어드는지도 어림할 수 있다. 전역 블록 하나의 쌍을 1 로 놓으면 윈도 블록 하나는 \(1 / W_n^2\) 이다.
- 인코더 전체의 어텐션 쌍: 모두 전역일 때와의 비
- \(\text{비} = \frac{(\text{전역 블록 수}) \times 1 + (\text{윈도 블록 수}) \times \dfrac{1}{W_n^2}}{\text{전체 블록 수}}\)
- 분모는 모든 블록이 전역일 때의 쌍(블록마다 1), 분자는 섞었을 때의 쌍이다.
- 전역 4층, 윈도 6층, 윈도 16개(\(W_n = 4\)). 윈도 6층을 다 합쳐도 전역 한 층의 \(6/16 = 0.375\) 배밖에 되지 않는다. 남은 쌍의 대부분은 전역 4층의 것이다.
- 전역 2층, 윈도 4층, 윈도 4개(\(W_n = 2\)). 어텐션의 쌍만 세면 절반이다.
이 비는 어텐션의 쌍만 센 것이다. 탐지기 전체의 연산량은 이만큼 줄지 않는다. 논문 표 2 에서 윈도 어텐션을 넣었을 때 전체 연산량은 23.0 에서 16.6 GFLOPs 로, 약 0.72배가 된다. 선형 층과 MLP, 프로젝터, 디코더는 그대로이기 때문이다.
윈도 사이로 정보가 흐르는지 확인하기
"전역 층이 없으면 윈도 사이로 정보가 흐르지 않는다" 는 말을 실험으로 확인한다. 이 장의 윈도 ViT 인코더(WindowedViT, 구현은 뒤에서 읽는다)에 그림을 넣고, 왼쪽 위 윈도에 해당하는 픽셀만 다른 값으로 바꿔 다시 넣는다. 그리고 마지막 특징 맵에서 다른 세 윈도의 칸 이 얼마나 달라졌는지 본다. 모델은 학습하지 않은 초기 가중치 그대로이다.
  왼쪽 위 윈도의 픽셀만 바꿨을 때, 마지막 특징 맵에서 **다른 윈도** 칸의 최대 변화
    check 윈도 블록만 6개: 0.00e+00 (0 이어야 한다),  바꾼 윈도 안: 5.236
    윈도 + 전역 (기본): 0.039  ← 전역 블록이 윈도 사이로 정보를 나른다
- 윈도 블록만 6개 인 모델에서는 다른 윈도의 출력이 정확히 0 만큼 변한다. 작은 값이 아니라 0 이다. 윈도가 배치의 다른 줄이므로, 계산의 어느 단계에서도 값이 섞일 길이 없다.
- 윈도 4개 + 전역 2개(기본 설정)에서는 다른 윈도의 출력이 0.039 만큼 변한다. 전역 블록이 길을 열었다. 바꾼 윈도 안의 변화(5.236)에 견주면 작은데, 이 수치는 학습 전 가중치의 것이라 크기 자체에는 뜻을 두지 않는다. 0 이냐 아니냐가 요점이다.
- 그림: 그림 9-2 출력 특징 맵의 한 칸(빨간 별, 행 2 · 열 3)이 입력의 어느 패치에 영향을 받는가. 색은 그 칸의 출력을 입력으로 미분한 크기의 몫(로그 눈금)이고, 회색은 정확히 0 이다. 흰 점선은 윈도 경계. 학습하지 않은 가중치이다.
- 출력 특징 맵의 한 칸이 입력의 어느 패치에 영향을 받는지를 12×12 격자에 색으로 나타낸 세 그림. 왼쪽은 윈도 블록만, 가운데는 윈도와 전역을 섞은 미니 모델, 오른쪽은 전역 블록만.
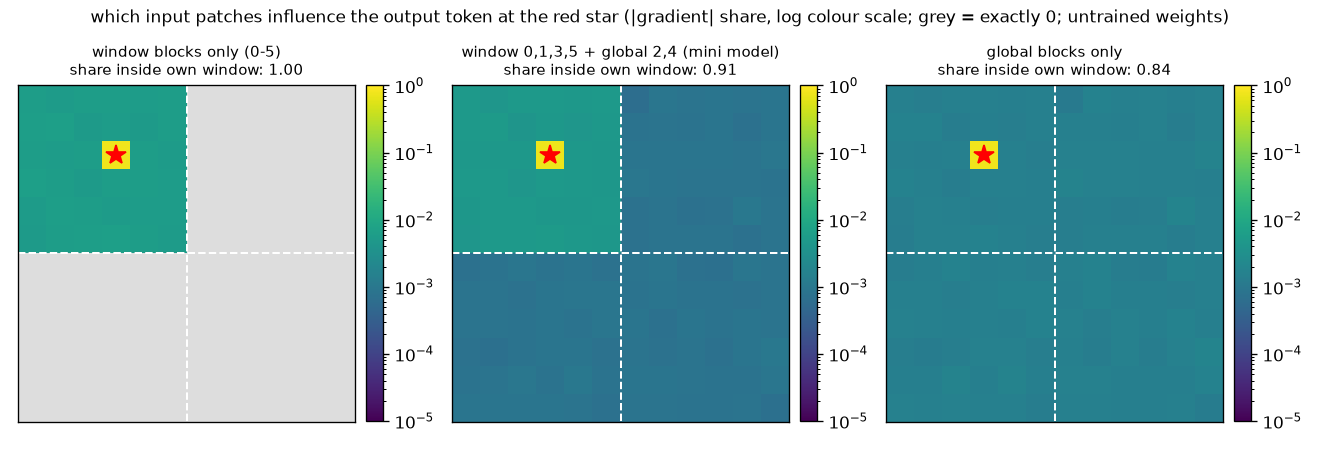
그림 9-2 는 같은 사실을 거꾸로 본다. 출력의 한 칸을 정하고, 그 칸이 입력의 어느 패치에 달려 있는지를 기울기로 잰다.
- 왼쪽(윈도 블록만). 별이 있는 왼쪽 위 윈도(6×6 칸) 밖은 전부 회색이다. 이 칸의 출력은 다른 윈도의 픽셀이 무엇이든 달라지지 않는다.
- 가운데(미니 모델: 윈도 0, 1, 3, 5 + 전역 2, 4). 윈도 밖에도 색이 있다. 다만 윈도 안이 한 단계 진하다. 자기 윈도 안 패치의 몫이 0.91 이다.
- 오른쪽(전역 블록만). 윈도 경계가 보이지 않는다. 자기 윈도 안의 몫은 0.84 이다.
- 이 그림을 읽는 한계
- 세 그림 모두 별이 있는 칸 하나만 노랗게 두드러진다. 학습하지 않은 모델에서는 잔차 연결 때문에 출력 칸이 거의 자기 자신의 패치에만 달려 있기 때문이다. 전역 블록만 쓴 오른쪽에서도 자기 윈도의 몫이 0.84 나 되는 까닭이다. 이 그림은 학습된 모델이 실제로 어디를 보는지가 아니라, 구조가 어떤 정보 흐름을 허용하는지(회색 = 불가능)를 보여 준다. 0.91 · 0.84 같은 수치는 학습 뒤에 달라진다.
그러면 윈도 어텐션으로 정확도는 얼마나 잃을까? 논문 표 2 에서는 윈도 어텐션을 넣은 줄에서 mAP 가 36.0 에서 34.7 로 1.3 내려간다(12 에폭 학습 기준). 연산량을 0.72배로 줄인 값이다. 이 튜토리얼의 도형 세상 실험(11장)에서는 윈도 2×2 모델과 모두 전역인 모델의 AP 차이가 시드 셋에서 −0.0014, +0.0041, −0.0009 로(전역 − 윈도), 부호가 섞이는 크기였다. 그림 한 장에 도형이 1 – 4개뿐인 작은 과제여서, 이것으로 COCO 에서의 손실을 말할 수는 없다.
윈도 우선 배치
윈도 어텐션으로 연산량은 줄었다. 그런데 LW-DETR 논문은 연산량이 줄었는데 지연 시간은 오히려 늘었다 고 보고한다. 까닭은 토큰을 늘어놓는 순서에 있었고, 그 해법이 이 논문이 직접 내놓은 구현 기법인 윈도 우선 배치(window-major feature map organization) 이다.
행 우선 배치의 문제
토큰 격자를 한 줄로 펼 때 보통은 한 행씩 읽는다. 첫 행의 왼쪽부터 오른쪽으로, 다음 행의 왼쪽부터 오른쪽으로. 이것이 행 우선 배치(row-major)이고, 6장의 ViT 도 이렇게 폈다. 전역 어텐션에는 아무 문제가 없다. 그런데 윈도 어텐션을 하려면 한 윈도의 토큰들을 한데 모아야 하는데, 행 우선 배치에서는 한 윈도의 토큰이 수열 여기저기에 흩어져 있다. 그래서 ViTDet 방식의 구현은 윈도 블록을 만날 때마다 다음을 한다.
- 토큰의 순서를 바꿔 윈도별로 모은다.
- 윈도 어텐션 블록을 계산한다.
- 토큰의 순서를 원래(행 우선)로 되돌린다.
1번과 3번은 계산이 아니라 메모리 안에서 값을 옮기는 일 이다. PyTorch 로 말하면 permute 뒤의 reshape 로, 텐서 전체를 새 순서로 복사한다. 윈도 블록이 6개면 이 복사가 12번 일어난다.
윈도 단위로 늘어놓기
윈도 우선 배치는 순서를 처음에 한 번만 바꾼다. 토큰을 윈도 단위로 늘어놓는다. 첫 윈도의 토큰을 모두 적고, 다음 윈도의 토큰을 모두 적는 식이다. 이렇게 해 두면 한 윈도의 토큰이 수열의 연속 구간 이 되므로, 윈도로 자르는 일이 값을 옮기지 않는 모양 바꾸기(view)만으로 된다.
- 그림: 그림 9-3 칸 안의 숫자는 그 토큰이 수열에서 놓이는 자리, 색은 윈도이다. 왼쪽: 4×4 격자의 행 우선 배치. 가운데: 같은 격자의 윈도 우선 배치. 오른쪽: 미니 모델의 12×12 격자를 2×2 윈도로 나눈 윈도 우선 배치.
- 4×4 격자의 행 우선 자리 번호, 같은 격자의 윈도 우선 자리 번호, 12×12 격자를 2×2 윈도로 나눈 윈도 우선 자리 번호. 칸의 색은 윈도를 나타낸다.
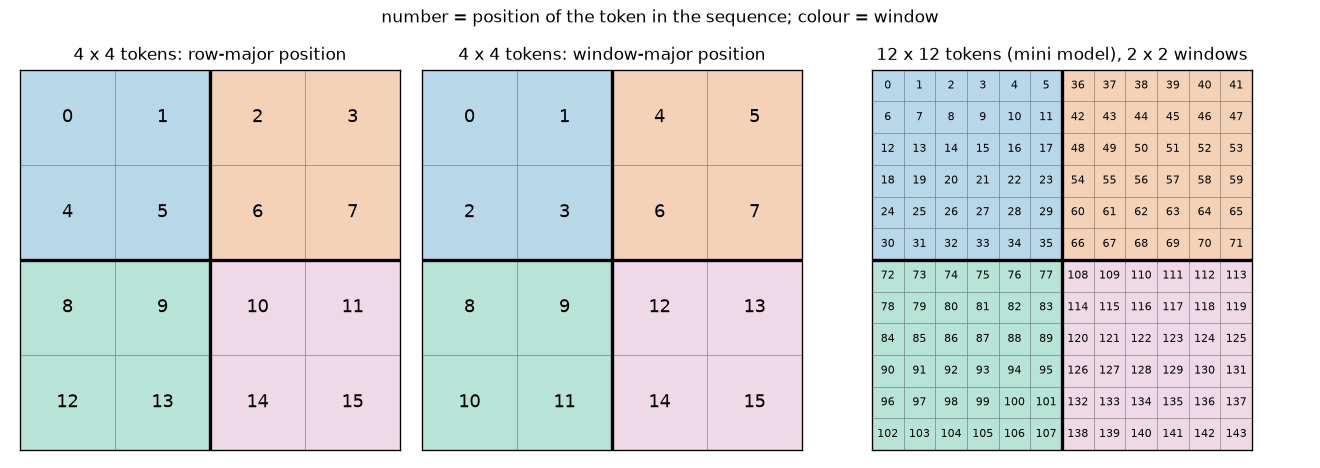
그림 9-3 에서 읽을 것:
- 왼쪽(행 우선). 번호가 한 행씩 0 – 3, 4 – 7, … 로 간다. 파란 윈도의 네 칸은 자리 0, 1, 4, 5 이다. 수열에서 떨어져 있다.
- 가운데(윈도 우선). 파란 윈도가 자리 0 – 3, 주황 윈도가 4 – 7, 초록이 8 – 11, 분홍이 12 – 15 이다. 한 윈도 = 수열의 연속 구간 이다. 수열을 네 토막으로 자르기만 하면 윈도가 된다.
- 오른쪽. 미니 모델에서도 같다. 윈도마다 36칸이 연속한 번호(0 – 35, 36 – 71, 72 – 107, 108 – 143)를 갖는다. 윈도의 순서도, 윈도 안의 순서도 행 우선이다.
손으로 따라가는 4×4 예
LW-DETR 논문 3.4절은 4×4 특징 맵으로 이 배치를 설명한다(논문 식 3 – 5). 칸의 이름을 \(f_{\text{행}\,\text{열}}\) 로 붙인다.
\(\begin{bmatrix} f_{11} & f_{12} & f_{13} & f_{14} \\ f_{21} & f_{22} & f_{23} & f_{24} \\ f_{31} & f_{32} & f_{33} & f_{34} \\ f_{41} & f_{42} & f_{43} & f_{44} \end{bmatrix}\)
윈도의 크기가 2×2 이면(한 변의 윈도 수 \(W_n = 2\)) 두 배치는 다음과 같다. 세미콜론은 네 개씩 끊어 읽기 좋게 넣은 것이다.
\(\begin{aligned} \text{행 우선:}\quad & f_{11}, f_{12}, f_{13}, f_{14};\; f_{21}, f_{22}, f_{23}, f_{24};\; f_{31}, f_{32}, f_{33}, f_{34};\; f_{41}, f_{42}, f_{43}, f_{44} \\ \text{윈도 우선:}\quad & f_{11}, f_{12}, f_{21}, f_{22};\; f_{13}, f_{14}, f_{23}, f_{24};\; f_{31}, f_{32}, f_{41}, f_{42};\; f_{33}, f_{34}, f_{43}, f_{44} \end{aligned}\)
윈도 우선의 첫 토막 \(f_{11}, f_{12}, f_{21}, f_{22}\) 가 왼쪽 위 2×2 윈도이다. 이 순서를 만드는 함수가 to_window_major 이다.
def to_window_major(tokens: torch.Tensor, grid_h: int, grid_w: int, num_windows: int) -> torch.Tensor:
    """행 우선으로 늘어선 토큰을 윈도 우선으로 다시 늘어놓고, 윈도를 배치 축으로 올린다.

    tokens: (B, H·W, C) — 토큰 격자 H×W 를 한 행씩 읽은 순서 (행 우선, row-major).
    num_windows: 한 변의 윈도 수 W_n. 격자를 W_n × W_n 개 윈도로 나눈다 (H, W 는 W_n 의 배수).
    돌려주는 값: (B·W_n², (H/W_n)·(W/W_n), C) — 윈도 하나가 배치의 한 줄. 윈도 순서도, 윈도 안 순서도 행 우선.
    """
    batch, _, channels = tokens.shape
    win_h, win_w = grid_h // num_windows, grid_w // num_windows  # 윈도 하나의 높이 · 너비 (토큰 수)
    x = tokens.view(batch, num_windows, win_h, num_windows, win_w, channels)  # (B, 윈도 행, 안쪽 행, 윈도 열, 안쪽 열, C)
    x = x.permute(0, 1, 3, 2, 4, 5)  # (B, 윈도 행, 윈도 열, 안쪽 행, 안쪽 열, C) — 여기서 순서가 바뀐다 (복사가 일어난다)
    return x.reshape(batch * num_windows**2, win_h * win_w, channels)

def from_window_major(tokens: torch.Tensor, grid_h: int, grid_w: int, num_windows: int) -> torch.Tensor:
    """to_window_major 의 역연산. (B·W_n², (H/W_n)·(W/W_n), C) → (B, H·W, C) 행 우선."""
    channels = tokens.shape[-1]
    win_h, win_w = grid_h // num_windows, grid_w // num_windows
    x = tokens.view(-1, num_windows, num_windows, win_h, win_w, channels)
    x = x.permute(0, 1, 3, 2, 4, 5)  # (B, 윈도 행, 안쪽 행, 윈도 열, 안쪽 열, C)
    return x.reshape(-1, grid_h * grid_w, channels)

def window_major_order(grid_h: int, grid_w: int, num_windows: int) -> torch.Tensor:
    """윈도 우선 배치에서 k 번째 자리에 오는 토큰의 행 우선 번호. (H·W,) LongTensor."""
    index = torch.arange(grid_h * grid_w, dtype=torch.float32).view(1, -1, 1)
    return to_window_major(index, grid_h, grid_w, num_windows).flatten().long()
함수의 본체는 세 줄이다. view 로 축을 넷으로 쪼개고, permute 로 가운데 두 축을 맞바꾸고, reshape 로 다시 편다. 이 세 줄이 어떻게 윈도 우선 순서를 만드는지 4×4 예로 따라간다. 행과 열을 0 부터 세어 \(r, c \in \{0, 1, 2, 3\}\) 이라 하면 \(f_{(r+1)(c+1)}\) 의 행 우선 번호는 \(4r + c\) 이다.
- view → permute → reshape 가 만드는 순서 (4×4 격자, 윈도 2×2)
- \(r = 2a + i, \qquad c = 2b + j \qquad (a, b, i, j \in \{0, 1\})\)
- 행 번호 \(r\) 을 "몇 번째 윈도 행인가(\(a\))" 와 "그 윈도 안에서 몇 번째 행인가(\(i\))" 로 쪼갠다. 열도 같은 식으로 윈도 열 \(b\) 와 안쪽 열 \(j\) 로 쪼갠다. 예: \(r = 3\) 은 아래쪽 윈도 행(\(a = 1\))의 둘째 행(\(i = 1\))이다.
- 위 식을 넣고 풀었다. 이것은 크기 \((2, 2, 2, 2)\) 인 4차원 배열에서 칸 \((a, i, b, j)\) 의 순번과 같다. 그래서
view(B, 2, 2, 2, 2, C)는 값을 옮기지 않고 축의 이름만 (윈도 행, 안쪽 행, 윈도 열, 안쪽 열)로 붙인다.
-
permute(0, 1, 3, 2, 4, 5)가 가운데 두 축(안쪽 행 \(i\) 와 윈도 열 \(b\))을 맞바꾼다. 이제 앞의 두 축 \((a, b)\) 가 "어느 윈도인가", 뒤의 두 축 \((i, j)\) 가 "윈도 안의 어느 칸인가" 이다.
-
reshape로 다시 한 줄로 펴면, 칸 \((a, b, i, j)\) 는 이 순번에 놓인다. 윈도 번호 \(2a + b\) 가 같은 네 칸이 연속한 자리 \(4(2a + b),\ \dots,\ 4(2a + b) + 3\) 을 차지한다.
- 윈도 우선의 다섯째 자리(\(k = 4\))를 풀어 보면 \(4 = 8 \cdot 0 + 4 \cdot 1 + 2 \cdot 0 + 0\) 이므로 오른쪽 위 윈도(\(b = 1\))의 첫 칸이다. 그 칸의 행 우선 번호는 2, 곧 \(r = 0, c = 2\) 의 \(f_{13}\) 이다. 논문의 식 (4)에서 다섯째가 \(f_{13}\) 인 것과 맞는다. 같은 식으로 \(k = 2\) 는 \((0, 0, 1, 0)\) 이라 행 우선 번호 4, 곧 \(f_{21}\) 이다.
실습 코드가 같은 예를 출력한 것이다. 논문의 식 (4) · (5) 와 한 글자씩 대조해 보라.
[윈도 우선 배치] LW-DETR 논문의 4×4 예, 윈도 크기 2×2 (한 변의 윈도 수 2)
  행 우선  : f11, f12, f13, f14; f21, f22, f23, f24; f31, f32, f33, f34; f41, f42, f43, f44
  윈도 우선: f11, f12, f21, f22; f13, f14, f23, f24; f31, f32, f41, f42; f33, f34, f43, f44
  윈도 우선 자리 → 행 우선 번호: [0, 1, 4, 5, 2, 3, 6, 7, 8, 9, 12, 13, 10, 11, 14, 15]
  to_window_major: (1, 16, 1) → (4, 4, 1)  (윈도 4개가 배치 축으로)
  check from_window_major(to_window_major(x)) = x: True
셋째 줄의 목록이 손계산과 같다. 자리 4 에 행 우선 번호 2, 자리 2 에 행 우선 번호 4 가 있다. 넷째 줄은 토큰 16개짜리 수열 하나 (1, 16, 1) 이 윈도 4개 × 토큰 4개 (4, 4, 1) 로 바뀌었음을 보인다. 윈도가 배치 축에 올라간 것이다.
전역 어텐션은 왜 그대로 되는가
윈도 블록은 이제 그대로 계산하면 된다. 남은 물음은 전역 블록이다. 토큰이 윈도 우선으로 섞여 있는데 전역 어텐션을 해도 될까? 된다. 이유는 둘이다.
- 모양 바꾸기만으로 한 줄이 된다.
(B·W_n², N/W_n², D)에서 그림 한 장의 윈도 \(W_n^2\) 개는 배치 축에서 이웃한 줄 이다. 메모리에 이미 차례로 놓여 있으므로view(B, N, D)가 값을 옮기지 않고 그림 한 장의 토큰 전체를 한 줄로 만든다. 미니 모델에서는(8, 36, 96)을(2, 144, 96)으로 보는 것이다. - 자기 어텐션은 토큰의 순서를 가리지 않는다. 5장의 순열 등변성이다. 입력 토큰의 순서를 섞으면 출력도 똑같이 섞일 뿐, 토큰 하나하나가 받는 값은 같다. 위치 정보는 순서가 아니라 토큰에 더해 둔 위치 임베딩에 들어 있고, 위치 임베딩은 순서를 바꾸기 전에 더한다. 그러니 윈도 우선으로 늘어선 토큰에 전역 어텐션을 해도, 행 우선으로 늘어놓고 한 것과 토큰마다 같은 결과가 나온다.
정리하면 윈도 우선 배치에서는 윈도 블록도 전역 블록도 순서 바꾸기 없이 돈다. 순서를 바꾸는 일은 인코더에 들어갈 때 한 번, 특징 맵을 꺼낼 때 한 번뿐이다. 논문의 말로 이 배치는 "특징을 다시 늘어놓지 않고도 윈도 어텐션과 전역 어텐션 양쪽에 쓸 수 있다". 두 방식을 나란히 구현한 코드이다.
def run_blocks_row_major(blocks, tokens, grid_h, grid_w, num_windows, window_blocks):
    """(a) 행 우선 배치: 토큰은 늘 (B, H·W, C) 로 두고, 윈도 블록을 만날 때마다 순서를 바꿨다가 되돌린다 (ViTDet 방식)."""
    for i, block in enumerate(blocks):
        if i in window_blocks:
            windows = to_window_major(tokens, grid_h, grid_w, num_windows)  # 순서 바꾸기 (복사)
            tokens = from_window_major(block(windows), grid_h, grid_w, num_windows)  # 되돌리기 (복사)
        else:
            tokens = block(tokens)  # 전역 어텐션은 그대로
    return tokens

def run_blocks_window_major(blocks, tokens, grid_h, grid_w, num_windows, window_blocks):
    """(b) 윈도 우선 배치: 들어갈 때 한 번, 나올 때 한 번만 순서를 바꾼다 (LW-DETR · RF-DETR 방식).

    그 사이의 윈도 블록은 그대로, 전역 블록은 view 로 윈도 W_n² 개를 한 줄로 붙여서 계산한다.
    """
    windows = to_window_major(tokens, grid_h, grid_w, num_windows)  # (B·W_n², T_w, C)
    for i, block in enumerate(blocks):
        windows = block(windows, merge=1 if i in window_blocks else num_windows**2)
    return from_window_major(windows, grid_h, grid_w, num_windows)
(b) 에서 전역 블록은 merge=num_windows**2 를 받는다. 블록 안에서 배치의 이웃한 \(W_n^2\) 줄을 view 로 한 줄로 붙여 어텐션을 하고, 끝나면 다시 view 로 되돌린다(블록의 코드는 "구현 따라 읽기" 에서 본다). 두 방식이 같은 값을 내는지 확인한다.
[윈도 어텐션] 블록 6개 (윈도 0, 1, 3, 5 / 전역 2, 4), 12×12 토큰, 윈도 2×2
  check (a) 행 우선 + 매번 순서 바꾸기 vs (b) 윈도 우선: 최대 차이 7.15e-07 (출력 평균 절댓값 0.908)
  참고: 모든 블록을 전역으로 돌린 출력과의 차이 5.19e-01 (다른 계산이다)
(a) 와 (b) 의 차이는 \(7 \times 10^{-7}\) 로, 32비트 실수의 반올림 수준이다. 두 방식은 같은 함수를 계산한다. 달라지는 것은 값이 아니라 그 값을 얻는 데 드는 메모리 이동의 횟수뿐이다. 셋째 줄은 대조를 위한 것으로, 윈도 블록을 모두 전역으로 바꾸면 출력이 0.52 나 달라진다. 윈도 어텐션은 전역 어텐션의 근사가 아니라 다른 계산 이다.
논문의 수치와 이 튜토리얼의 측정
먼저 논문이 보고한 것이다. LW-DETR 논문 표 2 의 해당 세 줄이다(small 모델, T4 · TensorRT).
| 설정 | 연산량 | 지연 | mAP |
| 전역 어텐션만 (+ 다층 특징 집계) | 23.0 GFLOPs | 3.7 ms | 36.0 |
| + 윈도 · 전역 번갈아 (ViTDet 방식 구현, 행 우선) | 16.6 GFLOPs | 3.9 ms | 34.7 |
| + 윈도 우선 배치 | 16.6 GFLOPs | 2.9 ms | 34.7 |
연산량이 23.0 에서 16.6 GFLOPs 로 줄었는데 지연은 3.7 에서 3.9 ms 로 0.2 ms 늘었다. 논문은 그 까닭을 행 우선 배치에서 필요한 순서 바꾸기 연산의 비용으로 설명한다. 윈도 우선 배치로 바꾸면 연산량과 mAP 는 그대로이고 지연만 2.9 ms 로 내려간다. 처음의 3.7 ms 와 견주어 0.8 ms 가 줄었다. 이 대목의 교훈은 윈도 어텐션보다 넓다. 연산량(FLOPs)이 줄었다고 시간이 줄어드는 것은 아니다. FLOPs 는 곱셈과 덧셈만 세고, 메모리에서 값을 옮기는 일은 세지 않는다.
이제 이 튜토리얼이 잰 것이다. 블록 6개(윈도 4 + 전역 2, 차원 96)에 배치 8 을 넣고 세 가지 방식의 시간을 쟀다. 모든 블록을 전역으로 돌린 것, (a) 행 우선 + 순서 바꾸기, (b) 윈도 우선이다. GPU 의 상태가 흔들리는 것을 고르게 받도록 세 방식을 번갈아 40바퀴 재고, 앞의 8바퀴를 버린 뒤 가장 짧은 시간을 적었다.
  시간 (장치 cuda, 배치 8, 블록 6개, 차원 96, ms) — 세 방식을 번갈아 40바퀴 재고, 앞 8바퀴를 버린 최솟값
  토큰 격자 | 전부 전역 | (a) 행 우선 + 순서 바꾸기 | (b) 윈도 우선 | (a) − (b)
    12×12  |      1.01 |                     0.97 |          0.96 |    +0.01
    24×24  |      5.05 |                     4.10 |          4.06 |    +0.04
    48×48  |     48.88 |                    28.96 |         29.29 |    -0.33
- 그림: 그림 9-4 왼쪽: 어텐션 한 번의 (질의, 열쇠) 쌍의 수(세로축은 로그 눈금). 오른쪽: 블록 6개 · 배치 8 의 실제 시간. 파랑은 모든 블록이 전역, 주황 빗금은 (a) 행 우선 + 순서 바꾸기, 초록 점무늬는 (b) 윈도 우선. 막대 위의 숫자는 ms 이다.
- 왼쪽: 토큰 격자 크기에 따른 어텐션 쌍의 수를 전역과 윈도 2×2, 3×3, 4×4 로 그린 로그 축 그래프. 오른쪽: 세 격자 크기에서 블록 6개의 실제 시간을 세 방식으로 잰 막대 그래프.
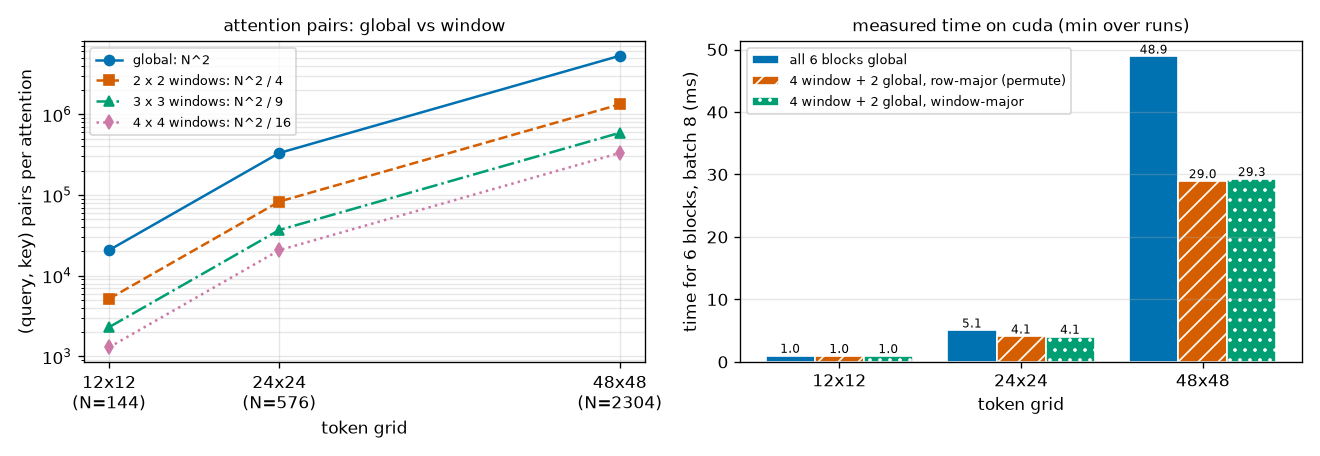
표와 그림 9-4 에서 읽을 것은 둘이다. 둘 다 기대와 조금 다르다.
- 윈도 어텐션의 속도 이득은 격자가 클 때만 나타났다. 그림 9-4 왼쪽의 쌍의 수는 어느 격자에서나 이론대로 4분의 1(주황 파선)이다. 그런데 오른쪽의 시간은 12×12 격자에서 1.01 → 0.97 ms 로 사실상 그대로이고, 24×24 에서 0.81배, 48×48 에서 0.59배이다. 미니 모델의 12×12 격자에서는 윈도 어텐션이 속도 이득을 주지 않는다.
- (a) 와 (b) 의 시간 차이는 재지지 않았다. 주황 막대와 초록 막대의 높이가 같다. (a) − (b) 는 +0.01, +0.04, −0.33 ms 로 부호마저 섞여 있고, 측정이 흔들리는 폭 안이다. 논문 표 2 의 "순서 바꾸기 때문에 3.9 ms, 윈도 우선 배치로 2.9 ms" 는 이 측정에서 재현되지 않았다.
1번은 앞의 "줄어드는 것은 제곱 항뿐" 으로 설명된다. 손으로 어림해 본다.
- 곱셈 수로 어림한 시간의 비 (차원 96, 윈도 2×2, 윈도 4 + 전역 2)
- \(\text{전역 블록} \;\propto\; 12ND^2 + 2N^2D \;=\; 12ND^2\left(1 + \frac{N}{6D}\right)\)
- 6장의 어림식에서 \(12ND^2\) 를 묶어 냈다. 괄호 안의 1 이 선형 층의 몫, \(N/6D\) 가 어텐션 쌍의 몫이다.
- 쌍의 몫만 \(1/W_n^2 = 1/4\) 로 줄어든다. 선형 층의 몫 1 은 그대로이다.
- 분자는 전역 2 + 윈도 4, 분모는 전역 6. 공통인 \(12ND^2\) 는 약분된다.
- 12×12 격자. 어텐션 쌍의 몫이 선형 층의 4분의 1 뿐이라, 그것을 4분의 1 로 줄여도 전체는 10% 만 줄어든다.
- 24×24 격자. 두 몫이 같아지는 크기이다.
- 48×48 격자. 어텐션 쌍이 블록의 80% 를 차지하므로 이득이 크다. 잰 값은 차례로 \(0.97/1.01 = 0.96\), \(4.10/5.05 = 0.81\), \(28.96/48.88 = 0.59\) 이다. 어림 0.90 · 0.75 · 0.60 과 같은 흐름이고, 큰 격자에서는 거의 일치한다.
작은 격자에서 잰 값(0.96, 0.81)이 어림(0.90, 0.75)보다 덜 줄어든 것은, 이만큼 작은 계산에서는 시간이 곱셈의 수보다 층과 함수 호출의 수에 좌우되기 때문으로 보인다. 12×12 격자의 블록 6개는 1 ms 면 끝난다. 실제 RF-DETR 의 격자는 24×24(Nano)에서 시작해 훨씬 커지므로(6장의 표), 윈도 어텐션의 이득이 나타나는 쪽에 있다.
2번, 두 배치 방식의 차이가 재지지 않은 데에는 그럴 만한 이유가 있다.
- 잰 대상이 다르다. 논문의 수치는 T4 GPU 에서 TensorRT 로 변환한 탐지기 전체의 지연 시간이고, 여기서 잰 것은 PyTorch 를 그대로 돌린 블록 6개이다.
- PyTorch 와 GPU 에서는 복사가 싸다.
permute+reshape의 복사(윈도 블록 4개에 왕복 8번)는 어텐션과 MLP 의 행렬 곱에 견주어 아주 가벼운 연산이다. - 측정이 그만큼 정밀하지 않다. 노트북 GPU 에서 잰 값이라 0.1 ms 단위의 차이는 읽을 수 없다. GPU 를 다른 작업과 나눠 쓰는 동안 시험 삼아 쟀을 때는 (b) 가 더 느리게 나온 적도 있다. 부하에 따라 뒤집히는 크기의 차이이다.
- 핵심 · 확인한 것과 확인하지 못한 것
-
- 확인한 것(코드). 윈도 우선 배치에서는 블록마다의 순서 바꾸기가 구조적으로 사라진다. (a) 는 윈도 블록마다
permute를 두 번 부르고, (b) 는 전체에서 두 번만 부른다. 두 방식의 출력은 같다(최대 차이 7.15e-07). - 확인하지 못한 것(시간). 그 이득이 이 PC 의 측정에서는 드러나지 않았다. 논문이 보고한 3.9 → 2.9 ms 는 T4 · TensorRT 에서의 값이고, 이 튜토리얼은 그 환경에서 재 보지 않았다.
- 덤으로 본 것. 윈도 어텐션 자체의 속도 이득도 토큰이 적으면 없다. 연산량이 줄었다는 말과 빨라졌다는 말은 따로 확인해야 한다.
- 확인한 것(코드). 윈도 우선 배치에서는 블록마다의 순서 바꾸기가 구조적으로 사라진다. (a) 는 윈도 블록마다
다층 특징 집계
인코더를 나오기 전에 하나가 더 있다. 보통은 ViT 의 마지막 블록의 출력 만 다음 단계로 넘긴다. LW-DETR 은 중간 블록 몇 개의 출력도 함께 꺼내 한데 모은다. 이것이 다층 특징 집계(multi-level feature aggregation) 이고, 논문이 초록에서 자기 기여로 꼽는 인코더의 개선이다. 논문의 표현으로는 "중간 층과 마지막 층의 특징 맵을 모아 더 풍부한 특징 맵을 만든다" 이다.
왜 도움이 될까? 신경망의 얕은 층과 깊은 층은 담는 정보가 다르다. 얕은 층의 토큰은 패치의 모서리나 질감 같은 자잘한 정보를 아직 많이 지니고 있고, 깊은 층으로 갈수록 "이 근처에 무엇이 있다" 는 뜻 쪽으로 정리된다. 박스의 경계를 정확히 그으려면 앞쪽의 정보도 쓸모가 있다. CNN 백본에서는 해상도가 다른 여러 단계의 특징 맵을 모아 썼다(8장의 다중 스케일). ViT 는 모든 블록의 출력이 같은 해상도 이므로, 모으는 일이 더 간단하다. 크기를 맞출 필요 없이 채널 방향으로 이어 붙이면 된다.
이 장의 미니 모델은 블록 6개 가운데 2개, 4개, 6개를 지난 뒤의 토큰을 꺼낸다. 각각 격자 모양으로 되접으면 (B, 96, 12, 12) 의 특징 맵이고, 셋을 채널로 이으면 (B, 288, 12, 12) 이다. 이것이 프로젝터의 입력이다. 인코더 쪽에 새로 생기는 매개변수는 없고, 넓어진 입력을 받는 프로젝터의 첫 합성곱만 커진다.
효과는 논문 표 2 의 둘째 줄에 있다. 마지막 층의 특징 맵만 쓰던 처음 탐지기에 다층 특징 집계를 더하면 mAP 가 35.3 에서 36.0 으로 0.7 오른다. 매개변수는 10.8M 에서 11.0M, 연산량은 22.8 에서 23.0 GFLOPs, 지연은 3.6 에서 3.7 ms 로 거의 늘지 않는다. 어느 층에서 꺼내는지는 논문 부록의 설정 표에 크기별로 적혀 있다.
- CLS 토큰은 어떻게 되나
- 6장의 ViT 에는 패치 토큰 앞에 CLS 토큰이 하나 있었다. 특징 맵을 만들 때는 CLS 토큰을 떼고 패치 토큰만 격자로 되접는다. RF-DETR 논문(부록 L)에 따르면 LW-DETR 이 쓰는 CAEv2 백본은 CLS 토큰이 없고, RF-DETR 이 쓰는 DINOv2 는 CLS 토큰이 있다. 그래서 RF-DETR 은 윈도 어텐션을 할 때 CLS 토큰을 윈도마다 복제 해 붙인다. 이 장의 실습 코드는 RF-DETR 의 공개 구현을 따라 그렇게 만들었다. 모양 추적은 "구현 따라 읽기" 에서 보고, 이 처리가 윈도 수의 선택에 미치는 영향은 10장에서 다룬다.
프로젝터와 C2f
프로젝터가 하는 일
인코더가 낸 특징 맵을 디코더가 바로 읽지 못하는 이유가 셋 있다. 프로젝터는 이 셋을 한 번에 푼다.
- 채널 수가 다르다. 인코더의 차원(LW-DETR small 은 192)과 디코더의 차원(256)이 다르고, 여러 층을 이어 붙이면 채널이 그 배수로 늘어난다. 디코더가 쓰는 채널 수로 바꿔야 한다.
- 여러 층의 특징을 섞어야 한다. 이어 붙이기는 나란히 놓았을 뿐이다. 얕은 층과 깊은 층의 정보를 칸마다 하나의 벡터로 버무리는 계산이 필요하다.
- 이웃 칸을 함께 봐야 한다. ViT 의 토큰은 패치 하나에 대응한다. 3×3 합성곱으로 둘레 칸의 정보를 모으면 탐지에 쓰기 좋은 특징이 된다. 필요하면 해상도도 여기서 바꾼다.
LW-DETR 은 이 일에 C2f(C2f block) 블록을 쓴다. 논문은 이것을 "YOLOv8 에 구현된, CSP(cross-stage partial) 구조의 확장" 이라고 소개한다. YOLO 계열이 다듬어 온 합성곱 블록을 DETR 의 인코더와 디코더 사이에 그대로 가져다 놓은 것이다.
C2f 블록의 구조
C2f 를 이루는 기본 단위는 "합성곱 → 정규화 → 활성 함수" 묶음이다. 코드의 ConvX 가 이것으로, 합성곱에는 편향이 없고(바로 뒤의 정규화가 편향 노릇을 한다), 활성 함수는 4장의 SiLU 이다. 출력 채널 수를 \(C_{\text{out}}\), 그 절반을 \(c = C_{\text{out}} / 2\), 병목의 수를 \(n\) 이라 하면 C2f 는 네 단계이다.
- 1×1 합성곱(cv1)으로 입력을 \(2c\) 채널로 만든다. 1×1 합성곱은 칸마다 같은 선형 층을 적용하는 것이었다(4장). 해상도는 그대로이고 채널 수만 바뀐다.
- 그 결과를 채널 방향으로 반씩 둘로 나눈다. 앞의 \(c\) 채널을 \(y_0\), 뒤의 \(c\) 채널을 \(y_1\) 이라고 하자.
- 병목 \(n\) 개를 차례로 통과시킨다. \(y_2 = m_1(y_1)\), \(y_3 = m_2(y_2)\), …, \(y_{n+1} = m_n(y_n)\). 병목 하나(\(m_k\))는 3×3
ConvX두 번이고, 채널 수는 \(c\) 로 유지된다. \(y_0\) 은 병목을 거치지 않고 그대로 건너간다. - \(y_0, y_1, \dots, y_{n+1}\) 을 전부 이어 붙여 \((2 + n)c\) 채널을 만들고, 1×1 합성곱(cv2)으로 \(C_{\text{out}}\) 채널로 줄인다.
원문 그림 9-5(도식): C2f 블록. 입력이 1×1 합성곱 cv1 을 거쳐 두 갈래 y0 과 y1 로 나뉘고, y1 이 병목 세 개를 차례로 지나 y2, y3, y4 를 만든다. 다섯 갈래를 모두 이어 붙여 1×1 합성곱 cv2 로 보낸다. C2f 블록. cv1 의 출력을 둘로 나눠 한쪽(\(y_1\))만 병목을 차례로 지나게 하고, 중간 결과 \(y_0 \dots y_4\) 를 모두 모아 cv2 로 합친다.
그림 9-5 에서 볼 것은 화살표가 모이는 방식이다.
- 중간 결과를 버리지 않는다. 병목 1 의 출력 \(y_2\) 는 병목 2 의 입력이 되는 동시에 마지막 이어 붙이기에도 들어간다. 병목을 0번 지난 것(\(y_0\), \(y_1\)), 1번(\(y_2\)), 2번(\(y_3\)), 3번(\(y_4\)) 지난 것이 모두 cv2 에 닿는다.
- 얕은 길과 깊은 길이 함께 있다. 3×3 합성곱을 지날 때마다 한 칸이 보는 둘레가 넓어진다. \(y_0\) 은 자기 칸만 본 특징이고, \(y_4\) 는 3×3 합성곱을 여섯 번 지나 둘레 13×13 칸을 본 특징이다. cv2 는 이 다섯 가지를 칸마다 섞는다.
- 기울기의 지름길이 생긴다. cv2 에서 cv1 까지 병목을 하나도 거치지 않는 길(\(y_0\), \(y_1\))이 있어서, 4장의 잔차 연결처럼 기울기가 얕은 길로도 흐른다.
- 병목 안에는 잔차 연결이 없다
- 코드의
Bottleneck은 "입력을 더하는" 잔차 연결을 켤 수 있게 되어 있지만, C2f 는 이것을 끈 채로(shortcut=False) 부른다. RF-DETR 의 공개 코드가 그렇다. 그래서 병목 하나는 정말로 3×3 합성곱 두 번일 뿐이다. 지름길 노릇은 병목 안의 덧셈이 아니라 바깥의 이어 붙이기가 한다.
채널 수와 매개변수 수 세기
이 장의 설정으로 채널 수를 따라간다. 입력은 인코더의 세 층을 이은 288 채널, 출력은 \(C_{\text{out}} = 128\), 병목은 \(n = 3\) 개이다. 그러면 \(c = 128 / 2 = 64\) 이다.
[프로젝터] 입력: WindowedViT 의 특징 맵 3개, 각각 (2, 96, 12, 12)
  P4 한 단계의 모양 추적 (out_channels = 128, 병목 3개)
    세 층을 채널로 이어 붙임         (2, 288, 12, 12)
    cv1 (1×1) → 2c = 128 채널       (2, 128, 12, 12) → 둘로 나눔: 각각 (2, 64, 12, 12)
    병목 1 (3×3 두 번)              (2, 64, 12, 12)
    병목 2 (3×3 두 번)              (2, 64, 12, 12)
    병목 3 (3×3 두 번)              (2, 64, 12, 12)
    모두 이어 붙임 (2 + 3)·c         (2, 320, 12, 12)
    cv2 (1×1) → 층 정규화            (2, 128, 12, 12)
    check 단계별 계산 = projector(features): 최대 차이 0.00e+00
    매개변수 300,544개
채널이 \(288 \to 128 \to (64, 64) \to 64 \to 64 \to 64\) 로 흐르고, 다섯 갈래를 모아 \(5 \times 64 = 320\), 마지막에 128 이 된다. 해상도 12×12 는 한 번도 바뀌지 않는다. 마지막 줄의 매개변수 300,544개를 손으로 세어 본다. 4장에서 본 대로 편향 없는 합성곱의 매개변수는 (입력 채널) × (출력 채널) × (커널 높이) × (커널 너비)이고, 층 정규화는 채널마다 배율과 편향을 하나씩, 곧 채널 수의 2배를 갖는다.
- 프로젝터 한 단계의 매개변수 수 (입력 288, 출력 128, c = 64, 병목 3개)
- \(\text{cv1}:\quad \underbrace{288 \times 128 \times 1 \times 1}_{\text{1×1 합성곱}} + \underbrace{2 \times 128}_{\text{정규화}} = 36{,}864 + 256 = 37{,}120\)
- 입력 288 채널을 \(2c = 128\) 채널로. 1×1 커널이라 칸마다 \(288 \to 128\) 선형 층 하나와 같다.
- 병목 안의 합성곱은 64 채널에서 64 채널로 간다. 3×3 커널이라 가중치가 9배이다.
- 병목 하나에 3×3 ConvX 가 둘, 병목이 셋이다.
- 이어 붙인 \((2 + 3) \times 64 = 320\) 채널을 128 채널로.
- C2f 뒤에 층 정규화가 하나 더 있다(프로젝터 단계의 마지막).
- 코드가 센 값과 같다. 매개변수의 74% 가 병목의 3×3 합성곱에 있다(\(221{,}952 / 300{,}544 = 0.74\)).
견주어 보면, 이 장의 윈도 ViT 인코더 전체가 705,024개이다. 프로젝터 한 단계가 인코더의 43% 쯤 되는, 작지 않은 부품이다.
단일 스케일과 2스케일
지금까지 본 것은 인코더의 해상도를 그대로 내보내는 단일 스케일 프로젝터이다. LW-DETR 의 tiny · small · medium 이 이것으로, 그림의 1/16 해상도 특징 맵 한 장을 디코더에 준다. large 와 xlarge 는 프로젝터가 두 해상도(1/8 과 1/32)의 특징 맵을 내고, 디코더는 8장의 다중 스케일 변형 어텐션으로 두 장을 함께 읽는다. 논문의 설명은 이렇다.
- 1/8 맵: 입력을 전치 합성곱(deconvolution)으로 2배 키운 뒤 C2f 블록 하나를 지난다.
- 1/32 맵: 입력을 스트라이드 합성곱으로 절반으로 줄인 뒤 다른 C2f 블록 하나를 지난다.
ViT 는 해상도가 하나뿐이므로, 다른 해상도가 필요하면 프로젝터가 만들어 낸다. 키울 때는 4장의 전치 합성곱(커널 2, 스트라이드 2: 한 칸을 2×2 칸으로 펼친다), 줄일 때는 스트라이드 2 인 3×3 합성곱이다. RF-DETR 의 공개 코드는 이것을 배율의 목록으로 일반화해 두었고, 이 장의 MultiScaleProjector 가 그 구조를 따른다. 배율마다 한 단계씩, 단계마다 C2f 가 하나씩이다.
  P3 · P4: 출력 [(2, 128, 24, 24), (2, 128, 12, 12)], 매개변수 638,096개
  P3 · P4 · P5: 출력 [(2, 128, 24, 24), (2, 128, 12, 12), (2, 128, 6, 6)], 매개변수 1,188,048개
이름 P3 · P4 · P5 는 탐지기에서 스트라이드 8 · 16 · 32 의 특징 맵을 부르는 관습이다. 코드에서는 "ViT 의 특징 맵을 P4 로 놓았을 때의 배율" 로 쓴다. P3 은 2배, P4 는 그대로, P5 는 절반이다. 미니 모델은 패치가 8 이라 실제 스트라이드는 그 절반씩이지만(P4 가 12×12), 배율의 관계는 같다. 12×12 인 P4 에서 24×24 의 P3 과 6×6 의 P5 가 만들어졌다. 스케일이 하나 늘 때마다 C2f 가 하나씩 더 붙으므로 매개변수가 30만 – 55만 개씩 늘어난다.
P3 단계가 P4 단계보다 조금 큰(638,096 − 300,544 = 337,552개) 까닭도 셀 수 있다. 전치 합성곱은 입력 96 채널을 절반인 48 채널로 줄이면서 키운다. 세 층 각각에 하나씩이라 \(3 \times (96 \times 48 \times 2 \times 2 + 48) = 3 \times 18{,}480 = 55{,}440\) 개가 더해지고, 이어 붙인 채널이 \(3 \times 48 = 144\) 로 줄어 cv1 이 \(144 \times 128 + 256 = 18{,}688\) 개가 된다. 나머지(병목, cv2, 끝의 정규화)는 앞과 같은 \(221{,}952 + 41{,}216 + 256 = 263{,}424\) 개이므로 합이 \(55{,}440 + 18{,}688 + 263{,}424 = 337{,}552\) 이다.
RF-DETR 의 기본은 P4 한 단계뿐인 단일 스케일 이다(projector_scale=["P4"]). 이 장의 다중 스케일 경로는 순전파의 모양만 확인했고, 그것으로 학습해 보지는 않았다.
배치 정규화에서 층 정규화로
ConvX 의 가운데에 있는 정규화 층이 LW-DETR 과 RF-DETR 사이에서 바뀐다. LW-DETR 의 프로젝터는 배치 정규화 를 쓴다(RF-DETR 논문 3절이 그렇게 적는다). RF-DETR 은 이것을 층 정규화 로 바꿨다. 4장에서 실험으로 본 대로 배치 정규화는 배치가 작으면 통계가 흔들리고, 층 정규화는 다른 그림을 보지 않으므로 배치 크기와 무관하다. RF-DETR 논문은 이 교체의 이유를 "기울기 누적으로 소비자용 GPU 에서도 학습할 수 있게 하려고" 라고 적는다. 작은 배치의 기울기는 여러 번 모을 수 있지만 배치 정규화의 통계는 모을 수 없기 때문이다(4장).
이 장의 코드는 RF-DETR 의 공개 구조(층 정규화)를 따른다. 다만 nn.LayerNorm 은 텐서의 마지막 축을 정규화하는데 특징 맵은 채널이 둘째 축((B, C, H, W))이므로, 채널 축을 맨 뒤로 보냈다가 되돌리는 작은 모듈 ChannelLayerNorm 을 쓴다. 칸 하나하나에서 채널 \(C\) 개에 걸쳐 평균 0 · 분산 1 로 맞춘다.
내장 함수와 값이 같고, 정규화한 뒤 칸마다의 채널 평균이 0, 표준편차가 1 이다. ConvX 에는 layer_norm=False 로 배치 정규화(LW-DETR 방식)를 고르는 길도 남겨 두었지만, 이 튜토리얼에서는 그 설정으로 실험하지 않았다. 코드에서 정규화 층의 이름이 bn 인 것은 공개 구현의 매개변수 이름을 그대로 따랐기 때문이고, RF-DETR 에서 그 자리에 있는 것은 층 정규화이다.
IoU 인지 BCE 손실
여기부터는 구조가 아니라 학습 을 돕는 부품이다. 디코더를 3층으로 줄였으니, 그 얕은 디코더에서 정확도를 짜내야 한다. 첫째가 분류 손실이다. LW-DETR 과 RF-DETR 은 8장의 포컬 손실 대신 IoU 인지 BCE 손실(IoU-aware BCE loss, IA-BCE), 줄여서 IA-BCE 를 쓴다. 이름 그대로 분류 손실이 IoU 를 "알게" 만든 BCE 이다. 이 장에서 수학이 가장 많은 절이다.
분류와 위치가 따로 논다
3장의 실험 하나를 떠올린다. 박스는 한 치도 바꾸지 않고 점수만 다르게 매겼더니 AP 가 0.369 에서 0.480 까지 달라졌다. AP75 는 0.153 과 0.393 이었다. 점수가 박스의 IoU 순서와 같을 때가 가장 높고, 거꾸로일 때가 가장 낮았다. 그때의 결론은 이것이었다. 박스가 정확한 예측일수록 점수가 높아야 한다.
그런데 지금까지의 손실은 그렇게 가르치지 않는다. 7 · 8장의 집합 손실을 보면, 정답과 짝지어진 예측은 분류의 목표가 무조건 1 이다. 그 예측의 박스가 정답과 IoU 0.95 로 겹치든 0.55 로 겹치든 같다. 박스 손실(L1, GIoU)은 박스 머리만 고치고, 분류 손실은 박스가 얼마나 맞았는지 보지 않는다. 두 손실이 서로를 모르는 채 따로 학습된다. 그 결과 "클래스는 확신하는데 박스는 엉성한" 예측이 높은 점수를 받고, 정작 박스가 가장 잘 맞은 예측이 뒤로 밀릴 수 있다.
이 손실의 출처는 LW-DETR 논문의 참고문헌 [3], Align-DETR(Cai 외, 2023)이다. 그 논문은 이 현상을 "분류 점수와 위치 정확도의 어긋남(misalignment)" 이라고 부르고, mAP 처럼 순위에 바탕을 둔 지표에서 이 어긋남이 성능을 깎는다고 짚는다. 처방은 단순하다. 분류의 목표를 1 이 아니라 IoU 로 만든 값으로 바꾼다. 앞에서 본 RT-DETR 의 질의 선택도 같은 문제의식에서 나왔다.
- 이름의 출처
- LW-DETR 이 인용한 것은 Align-DETR 의 첫 판(arXiv 2304.07527v1, 2023년 4월)으로, 제목이 "Align-DETR: Improving DETR with Simple IoU-aware BCE loss" 이고 여기서 IA-BCE 라는 이름이 나온다. LW-DETR 논문의 식 (1) 은 이 첫 판의 식과 같다. Align-DETR 은 뒤에 고쳐 쓴 판에서 손실의 이름과 꼴을 바꿨는데(Align Loss), LW-DETR 과 RF-DETR 이 쓰는 것은 첫 판의 꼴이다. 비슷한 문제를 겨눈 이웃 손실로 그 논문은 Quality Focal Loss 와 Varifocal Loss 를 들지만, 이 튜토리얼은 그 식들을 다루지 않는다.
논문의 식
LW-DETR 논문의 식 (1) 을 이 튜토리얼의 표기로 옮기면 다음과 같다(논문의 점수 \(s\) 를 \(p\) 로 적었다).
\(\ell_{\text{cls}} = \sum_{i=1}^{N_{\text{pos}}} \operatorname{BCE}(p_i,\ t_i) \;+\; \sum_{j=1}^{N_{\text{neg}}} p_j^{2}\, \operatorname{BCE}(p_j,\ 0), \qquad t = p^{\alpha}\, u^{1-\alpha}\)
기호를 하나씩 읽는다.
- 칸. 분류 머리는 질의마다 클래스 수만큼의 로짓을 낸다(8장의 ∅ 없는 시그모이드 분류). (질의, 클래스) 쌍 하나를 칸 이라고 부르겠다. 질의 300개에 클래스 80개면 24,000칸이고, 칸마다 "이 질의가 이 클래스의 객체인가" 에 대한 확률 \(p\) 가 하나씩 있다.
- 양성 칸(\(N_{\text{pos}}\) 개): 헝가리안 매칭으로 정답과 짝지어진 질의의, 그 정답의 클래스 칸이다. 정답 하나에 양성 칸이 하나이다.
- 음성 칸(\(N_{\text{neg}}\) 개): 나머지 전부이다. 짝이 없는 질의의 모든 칸뿐 아니라, 짝지어진 질의의 다른 클래스 칸도 음성이다.
- \(\operatorname{BCE}(p, t) = -t \log p - (1 - t) \log(1 - p)\): 4장의 부드러운 목표 BCE 이다. 목표가 0 이면 \(\operatorname{BCE}(p, 0) = -\log(1 - p)\) 만 남는다.
- \(u\): 그 양성 칸의 질의가 낸 예측 박스 와 짝인 정답 박스 의 IoU 이다(2장의 짝끼리 IoU). 0 과 1 사이의 수이다.
- \(t\): 양성 칸의 목표이다. 지금의 점수 \(p\) 와 IoU \(u\) 로 만든다. \(\alpha\) 는 둘을 섞는 비율을 정하는 지수이고, 논문은 0.25 를 쓴다. 그러면 \(t = p^{0.25}\, u^{0.75}\) 이다.
8장의 손실과 달라진 곳은 둘이다. 양성 칸의 목표가 1 에서 \(t\) 로 바뀌었고, 음성 칸에는 \(p^2\) 이 곱해졌다. 차례로 본다.
목표 t 읽기
\(t = p^{\alpha} u^{1-\alpha}\) 는 \(p\) 와 \(u\) 의 가중 기하 평균 이다. 산술 평균 \(\alpha p + (1 - \alpha) u\) 가 더해서 섞는 것이라면, 기하 평균은 곱해서 섞는다. 먼저 \(t\) 가 어디쯤 놓이는지 확인한다.
- 목표 \(t\) 는 언제나 \(p\) 와 \(u\) 사이에 있다 (\(0 \lt \alpha \lt 1\))
- \(p = p^{\alpha} \cdot p^{1-\alpha}\)
- 지수의 합이 \(\alpha + (1 - \alpha) = 1\) 이므로 \(p\) 자신을 이렇게 쪼갤 수 있다. \(u = u^{\alpha} \cdot u^{1-\alpha}\) 도 마찬가지이다.
- 양수의 거듭제곱은 크기 순서를 지킨다(\(1 - \alpha \gt 0\)). 양변에 같은 양수 \(p^{\alpha}\) 를 곱했다. 그래서 \(p \lt t\) 이다.
- 같은 방법으로 이번에는 \(u^{1-\alpha}\) 를 곱했다. 그래서 \(t \lt u\) 이다.
- \(p \gt u\) 일 때는 부등호가 모두 뒤집힌다. \(p = u\) 이면 \(t = p^{\alpha} p^{1-\alpha} = p\) 이다. 목표는 늘 지금의 점수와 IoU 사이의 한 점이고, 둘이 같을 때만 그 둘과 일치한다.
숫자를 몇 개 넣어 본다(\(\alpha = 0.25\)).
| 점수 \(p\) | IoU \(u\) | \(p^{0.25}\) | \(u^{0.75}\) | 목표 \(t\) | 읽기 |
| 0.60 | 0.80 | 0.8801 | 0.8459 | 0.7445 | 점수가 IoU 보다 낮다 → 목표가 점수보다 높다(올려라) |
| 0.90 | 0.50 | 0.9740 | 0.5946 | 0.5791 | 점수가 IoU 보다 높다 → 목표가 점수보다 낮다(내려라) |
| 0.20 | 0.90 | 0.6687 | 0.9240 | 0.6179 | 박스는 아주 좋은데 점수가 낮다 → 크게 올려라 |
| 0.50 | 0.50 | 0.8409 | 0.5946 | 0.5000 | 점수 = IoU → 목표 = 점수(그대로) |
지수가 \(u\) 쪽에 0.75, \(p\) 쪽에 0.25 이므로 \(t\) 는 \(u\) 에 더 가깝게 끌려간다. 그래도 \(p\) 가 섞여 있어서, 점수가 아주 낮을 때는 목표도 한 번에 IoU 까지 올라가지 않는다(셋째 줄: IoU 0.90 인데 목표는 0.62). \(\alpha\) 의 두 끝을 보면 뜻이 분명해진다. Align-DETR 논문의 설명이다.
- \(\alpha = 0\) 이면 \(t = u\). 목표가 온전히 IoU 이다.
- \(\alpha = 1\) 이면 \(t = p\). 목표가 지금의 점수 자신이라, 학습 신호가 없다.
- 그 사이의 값은 "IoU 가 이끄는 정도" 와 "학습의 안정성" 사이의 절충이고, 0.25 가 좋았다고 그 논문은 보고한다. \(\alpha\) 는 작게 두어야 한다는 것이 그 논문의 결론이다.
한 가지 약속이 더 있다. \(t\) 는 \(p\) 로 만들지만, 손실을 미분할 때는 \(t\) 를 상수로 본다(8장의 기울기 차단). \(t\) 안의 \(p\) 로는 기울기가 흐르지 않는다. "목표" 는 맞혀야 할 과녁이지 스스로 움직여 손실을 줄이는 변수가 아니기 때문이다. 논문의 식에는 이 표시가 없지만 구현은 그렇게 되어 있다.
고정점: 점수가 IoU 로 끌려간다
이제 이 손실이 점수를 어디로 데려가는지 유도한다. 4장에서 두 가지를 보였다. 목표 \(t\) 가 고정된 BCE 는 \(p = t\) 에서 가장 작고, 로짓 \(z\) 에 대한 기울기는 \(p - t\) 이다. IA-BCE 에서는 그 \(t\) 가 \(p\) 에 따라 움직인다.
- 양성 칸의 기울기가 0 이 되는 곳은 \(p = u\)
- \(\frac{\partial\, \operatorname{BCE}(p, t)}{\partial z} = p - t\)
- 4장의 결과이다(\(p = \sigma(z)\)). \(t\) 를 상수로 보고 미분했다. \(p \lt t\) 이면 기울기가 음수이므로 경사 하강법이 \(z\) 를 키워 \(p\) 를 올리고, \(p \gt t\) 이면 내린다.
- 미분을 마친 뒤에 \(t\) 의 값 \(p^{\alpha} u^{1-\alpha}\) 를 넣었다. 순서가 중요하다. 먼저 넣고 미분하면 \(t\) 안의 \(p\) 까지 미분되어 다른 식이 된다.
- 기울기가 0 이 되어 점수가 더는 움직이지 않는 곳을 찾는다. "점수 = 목표" 인 곳이다.
- 양변을 \(p^{\alpha}\) 로 나눴다(\(p \gt 0\) 이므로 나눌 수 있다). 왼쪽은 \(p / p^{\alpha} = p^{1-\alpha}\).
- 양변을 \(1/(1 - \alpha)\) 제곱했다(\(\alpha \lt 1\)). 기울기가 0 인 곳은 점수가 IoU 와 같은 곳 하나뿐 이다.
- 앞 절에서 \(p \lt u\) 이면 \(p \lt t\) 임을 보였다. 그러니 점수가 IoU 보다 낮으면 올라가고 높으면 내려간다. 어느 쪽에서 출발하든 \(p = u\) 를 향한다.
이런 점을 고정점 이라고 부른다. 한 번 그곳에 놓이면 더는 움직이지 않는 점이다. 여기서는 양쪽에서 끌려 들어오는 고정점이다. 4장의 "최솟점은 \(p = t\)" 와 견주면 차이가 보인다. 그때는 과녁 \(t\) 가 고정이었고, 지금은 과녁이 점수를 따라 움직인다. 점수가 올라가면 목표도 조금 올라가고, 다시 점수가 따라간다. 이 쫓고 쫓기는 일이 멈추는 곳이 \(p = t\), 곧 \(p = u\) 이다.
과녁이 움직이는 모습을 숫자로 본다. IoU 가 \(u = 0.8\) 이고 점수가 \(p = 0.2\) 에서 출발한다고 하자. 갱신 한 번마다 점수가 그때의 목표까지 올라간다고 하면(실제 학습은 이보다 조금씩 움직인다), 점수는 \(0.2 \to 0.566 \to 0.734 \to 0.783 \to 0.796 \to 0.799 \to 0.800\) 으로 간다. 첫 목표는 \(0.2^{0.25} \times 0.8^{0.75} = 0.6687 \times 0.8459 = 0.566\) 이고, 그다음 목표는 \(0.566^{0.25} \times 0.8459 = 0.734\) 이다. 목표가 IoU 를 넘어가는 일 없이 0.8 로 다가간다.
실습 코드가 autograd 로 구한 기울기이다. 손실 함수에 양성 칸 하나만 넣고 로짓으로 미분했다.
  IoU = 0.5: p = 0.20: t = 0.3976, ∂손실/∂로짓 = -0.1976 | p = 0.50: t = 0.5000, ∂손실/∂로짓 = +0.0000 | p = 0.95: t = 0.5870, ∂손실/∂로짓 = +0.3630
  IoU = 0.9: p = 0.20: t = 0.6179, ∂손실/∂로짓 = -0.4179 | p = 0.90: t = 0.9000, ∂손실/∂로짓 = +0.0000 | p = 0.95: t = 0.9122, ∂손실/∂로짓 = +0.0378
  → 로짓에 대한 기울기는 p − t. p < IoU 면 음수(점수를 올린다), p > IoU 면 양수(내린다), p = IoU 에서 0.
첫 줄의 첫 칸을 손으로 확인한다. \(t = 0.2^{0.25} \times 0.5^{0.75} = 0.6687 \times 0.5946 = 0.3976\), 기울기는 \(p - t = 0.2 - 0.3976 = -0.1976\). 출력과 같다. 두 줄을 견주면 같은 점수 0.95 라도 IoU 가 0.5 인 박스에는 \(+0.3630\) 으로 세게 "내려라" 가 걸리고, IoU 가 0.9 인 박스에는 \(+0.0378\) 로 거의 걸리지 않는다. 보통의 BCE(목표 1)였다면 두 경우 모두 기울기가 \(0.95 - 1 = -0.05\) 로 "더 올려라" 였을 것이다.
- 핵심 · IA-BCE 가 가르치는 것
- 보통의 분류 손실은 짝지어진 예측의 점수를 1 로 민다. IA-BCE 는 그 점수를 그 예측의 IoU 로 끌어당긴다. 박스가 잘 맞은 예측은 높은 점수에서, 엉성한 예측은 낮은 점수에서 멈춘다. 그래서 점수의 순서가 박스 품질의 순서를 닮게 되고, 3장에서 본 대로 그것이 AP 에 유리하다. 분류 머리가 "이 클래스가 맞는가" 에 더해 "내 박스가 얼마나 맞았는가" 까지 답하도록 배우는 셈이다.
- 이 유도가 말하지 않는 것
-
- IoU 도 움직인다. 유도에서는 \(u\) 를 고정했지만, 학습 중에는 박스 손실이 박스를 고치므로 \(u\) 도 올라간다. 점수는 올라가는 IoU 를 따라간다.
- 손실이 0 으로 가지 않는다. 고정점 \(p = u\) 에서의 손실은 \(-u \log u - (1 - u) \log(1 - u)\) 이다. \(u = 0.9\) 이면 \(0.0948 + 0.2303 = 0.3251\) 이다. 4장에서 본 대로 부드러운 목표의 BCE 는 최솟값이 0 이 아니다. 분류 손실이 더 내려가지 않는다고 학습이 멈춘 것이 아니다(14장의 학습 기록에서 이 모습을 본다).
- 신경망은 칸 하나만 따로 맞추지 못한다. 유도는 로짓 하나를 자유롭게 움직일 수 있다고 보았다. 실제로는 같은 가중치가 모든 그림의 모든 칸을 함께 맞혀야 하므로, 점수가 IoU 와 정확히 같아지지는 않는다. 얼마나 가까워지는지는 11장에서 잰다.
음성 칸은 포컬 손실과 같은 꼴
식의 둘째 항 \(p^2\, \operatorname{BCE}(p, 0) = -p^2 \log(1 - p)\) 는 낯익다. 4장의 포컬 손실에서 음성 칸(\(y = 0\))은 \(p_t = 1 - p\), \(\alpha_t = 1 - \alpha\) 이므로
\(\mathrm{FL}_{\text{음성}} = -(1 - \alpha)\,\big(1 - (1 - p)\big)^{\gamma} \log(1 - p) = -(1 - \alpha)\, p^{\gamma} \log(1 - p)\)
였다(\(\gamma = 2\), 포컬 손실의 \(\alpha = 0.25\) 이면 \(-0.75\, p^2 \log(1 - p)\)). IA-BCE 의 음성 항은 여기서 균형 가중치 \(0.75\) 만 뺀 것 이다. 조절 인자 \(p^2\) 의 구실은 4장과 같다. 음성 칸은 압도적으로 많고 대부분 쉽다(\(p\) 가 0 근처). \(p^2\) 이 그런 칸의 손실을 지워서, 드문 양성 칸이 음성의 합에 묻히지 않게 한다.
양성 칸에는 왜 조절 인자를 쓰지 않을까? Align-DETR 논문의 설명은 이렇다. DETR 에서는 양성이 워낙 드무니 "쉬운 양성" 이라고 깎지 말고 그 영향을 지키고, 음성에만 포컬 손실의 가중치 \(p^2\) 을 남겨 어려운 음성에 집중하게 한다. 그래서 양성은 조절 인자 없는 BCE, 음성은 포컬 꼴인 비대칭 손실이다.
- 음성 칸의 로짓 기울기
- \(L = -p^{2} \log(1 - p), \qquad \frac{\partial L}{\partial p} = -2p \log(1 - p) + \frac{p^{2}}{1 - p}\)
- 곱의 미분이다. \(p^2\) 을 미분하면 \(2p\), \(-\log(1 - p)\) 를 미분하면 \(1/(1 - p)\) 이다. 여기서는 \(p^2\) 도 함께 미분한다. 목표 \(t\) 와 달리 조절 인자에는 기울기 차단이 없다(공개 구현이 그렇고, 4장의 포컬 손실도 그랬다).
- 연쇄 법칙. 시그모이드의 미분은 \(\partial p / \partial z = p(1 - p)\) 이다(4장).
- 곱해서 정리했다. 둘째 항은 \(\frac{p^2}{1-p} \cdot p(1-p) = p^3\). 두 항 모두 0 이상이므로 기울기는 늘 양수, 곧 언제나 "점수를 내려라" 이다. 보통 BCE 의 기울기는 \(p\) 이다.
숫자를 넣어 보통 BCE 와 견준다.
| \(p\) | BCE 손실 \(-\log(1-p)\) | IA-BCE 음성 손실 | BCE 기울기 \(p\) | IA-BCE 음성 기울기 |
| 0.01 | 0.0101 | 0.000001 | 0.01 | 0.000003 |
| 0.10 | 0.1054 | 0.0011 | 0.10 | 0.0029 |
| 0.40 | 0.5108 | 0.0817 | 0.40 | 0.1621 |
| 0.90 | 2.3026 | 1.8651 | 0.90 | 1.1020 |
\(p = 0.4\) 의 줄을 손으로 확인하면 손실은 \(0.16 \times 0.5108 = 0.0817\), 기울기는 \(2 \times 0.16 \times 0.6 \times 0.5108 + 0.064 = 0.0981 + 0.064 = 0.1621\) 이다. 이미 잘 맞힌 음성(\(p = 0.01\))은 손실이 보통 BCE 의 만분의 1, 기울기가 3천분의 1 쯤으로 줄어든다. 반대로 크게 틀린 음성(\(p = 0.9\))은 기울기가 \(1.10\) 으로 보통 BCE 의 \(0.90\) 보다 오히려 크다. 쉬운 칸을 지우고 어려운 칸에 힘을 싣는다는 4장의 관찰 그대로이다.
공식 구현과 한 줄씩 맞추기
RF-DETR 의 공개 코드는 이 손실을 두 가지 "가중치" 로 적는다. 칸마다 \(\log p\) 에 곱할 양성 가중치 \(w_{\text{pos}}\) 와 \(\log(1 - p)\) 에 곱할 음성 가중치 \(w_{\text{neg}}\) 를 정하고, 모든 칸에 같은 식을 쓴다.
\(\text{칸의 손실} = -\,w_{\text{pos}} \log p \;-\; w_{\text{neg}} \log(1 - p)\)
| 칸 | \(w_{\text{pos}}\) | \(w_{\text{neg}}\) | 칸의 손실 | 논문 식 (1) 의 항 |
| 양성 칸(짝지어진 질의 · 정답의 클래스) | \(t\) | \(1 - t\) | \(-t \log p - (1 - t)\log(1 - p)\) | \(\operatorname{BCE}(p, t)\) |
| 그 밖의 모든 칸 | \(0\) | \(p^{\gamma}\) (\(\gamma = 2\)) | \(-p^{2} \log(1 - p)\) | \(p^{2}\, \operatorname{BCE}(p, 0)\) |
표의 넷째 열과 다섯째 열이 같으므로 구현은 논문의 식을 그대로 계산한다. 논문에 적히지 않은 구현 세부가 넷 있다.
- 기울기 차단. \(t\) 는
detach()로 상수가 된다. 음성 가중치 \(p^{\gamma}\) 는 차단하지 않는다. - 목표의 바닥값. \(t\) 가 0.01 보다 작으면 0.01 로 올린다(
clamp(min=0.01)). 박스가 정답과 전혀 겹치지 않으면 \(u = 0\) 이라 \(t = 0\) 이 되는데, 그러면 양성 칸이 음성 칸과 구별되지 않는다. 바닥값은 짝지어진 칸에 최소한의 "올려라" 신호를 남긴다. - 나누는 수. 논문의 식은 합만 적지만, 구현은 모든 칸의 손실을 더한 뒤 정답의 수(
num_boxes)로 나눈다. 질의 묶음을 쓸 때는 정답 수 × 묶음 수이다(다음 절). - IoU 의 기울기. \(u\) 는 예측 박스에서 계산하지만 기울기를 흘리지 않는다. 분류 손실이 박스 머리를 고치지는 않는다. 박스는 박스 손실만으로 배운다.
def ia_bce_loss(logits: torch.Tensor, matched, tgt_classes: torch.Tensor, ious: torch.Tensor, num_boxes: float,
                alpha: float = 0.25, gamma: float = 2.0) -> torch.Tensor:
    """IoU 인지 BCE 손실 (IA-BCE). RF-DETR 공식 구현 criterion.py 의 loss_labels (ia_bce_loss=True) 와 같은 계산.

    logits       (B, N, K)  클래스별 로짓 (시그모이드 방식, ∅ 칸 없음)
    matched      (batch_idx, query_idx) — 각각 (M,). 매칭된 예측은 logits[batch_idx[k], query_idx[k]]
    tgt_classes  (M,)  그 예측의 짝인 정답의 클래스
    ious         (M,)  그 예측 박스와 짝 정답 박스의 IoU (기울기 없음)
    num_boxes    손실을 나눌 수 (배치의 정답 수 × 질의 묶음 수)

    p = σ(로짓). 칸 (b, n, c) 마다
      매칭된 칸 (짝 정답의 클래스 칸):  목표 t = p^α · IoU^(1−α)  (최소 0.01, 기울기 차단)
                                        손실 = −t·log p − (1 − t)·log(1 − p)          ← 목표가 t 인 BCE
      그 밖의 모든 칸:                  손실 = −p^γ · log(1 − p)                        ← p^γ 로 가중한 "목표 0" BCE
    전부 더해 num_boxes 로 나눈다.
    """
    prob = logits.sigmoid()
    batch_idx, query_idx = matched
    pos_weights = torch.zeros_like(logits)  # log p 에 곱할 가중치: 매칭된 칸만 t, 나머지 0
    neg_weights = prob**gamma  # log(1 − p) 에 곱할 가중치: 기본 p^γ (기울기가 흐른다)
    target = prob[batch_idx, query_idx, tgt_classes].pow(alpha) * ious.pow(1 - alpha)
    target = target.clamp(min=0.01).detach()  # 목표는 상수로 본다 (기울기 차단)
    pos_weights[batch_idx, query_idx, tgt_classes] = target
    neg_weights[batch_idx, query_idx, tgt_classes] = 1 - target
    # −pos·log p − neg·log(1 − p) 를 수치적으로 안정되게: log(1 − p) = log σ(−x) = log σ(x) − x
    loss = neg_weights * logits - F.logsigmoid(logits) * (pos_weights + neg_weights)
    return loss.sum() / num_boxes
코드의 마지막 계산 neg_weights * logits - F.logsigmoid(logits) * (pos_weights + neg_weights) 는 위의 식을 4장의 수치 안정 형태로 바꾼 것이다. \(p\) 가 0 이나 1 에 아주 가까우면 \(\log p\) 나 \(\log(1 - p)\) 를 그대로 계산할 때 오차가 커지기 때문이다.
- 로짓에서 바로 계산하는 꼴
- \(1 - p = 1 - \frac{1}{1 + e^{-z}} = \frac{e^{-z}}{1 + e^{-z}} = e^{-z}\, p\)
- \(p = \sigma(z) = 1/(1 + e^{-z})\) 를 넣고 통분했다. 마지막 등호는 \(\frac{1}{1 + e^{-z}} = p\) 를 다시 묶은 것이다.
- 양변에 로그를 씌웠다. \(\log(e^{-z} p) = -z + \log p\).
- 칸의 손실에 넣었다.
- \(\log p\) 끼리 묶었다. 코드의 한 줄과 같다. \(\log \sigma(z)\) 는
F.logsigmoid가 큰 \(|z|\) 에서도 안정되게 계산한다.
손으로 계산하는 손실
작은 예를 끝까지 계산한다. 질의 3개, 클래스 3개인 그림 한 장이고 정답이 2개이다. 헝가리안 매칭이 질의 0 을 정답 A(클래스 1)와, 질의 1 을 정답 B(클래스 0)와 짝지었고, 질의 2 는 짝이 없다. 짝지어진 두 박스의 IoU 는 0.80 과 0.50 이다. 칸마다의 확률 \(p\) 는 다음과 같다(굵은 칸이 양성 칸).
| 클래스 0 | 클래스 1 | 클래스 2 | 짝 | |
| 질의 0 | 0.10 | 0.60 | 0.05 | 정답 A(클래스 1), IoU 0.80 |
| 질의 1 | 0.90 | 0.20 | 0.02 | 정답 B(클래스 0), IoU 0.50 |
| 질의 2 | 0.03 | 0.40 | 0.01 | 없음 |
- IA-BCE 손계산: 9칸, 양성 2칸
- \(t_{A} = 0.60^{0.25} \times 0.80^{0.75} = 0.8801 \times 0.8459 = 0.7445\)
- 양성 칸 (질의 0, 클래스 1) 의 목표. \(0.60^{0.25} = e^{0.25 \ln 0.6} = e^{-0.1277} = 0.8801\), \(0.80^{0.75} = e^{0.75 \ln 0.8} = e^{-0.1674} = 0.8459\).
- 목표 \(t_A\) 의 BCE. 점수 0.60 이 목표 0.74 보다 낮으니 "올려라" 는 손실이다.
- 양성 칸 (질의 1, 클래스 0) 의 목표. 점수는 0.90 으로 높지만 IoU 가 0.50 이라 목표가 0.58 이다.
- 둘째 항이 크다. 목표의 \(1 - t_B = 0.42\) 만큼은 "음성" 인데 점수가 0.90 이라 \(-\log(1 - p) = 2.30\) 의 벌을 받는다. 점수를 내리라는 손실이다.
- 나머지 일곱 칸. \(p = 0.40\) 인 칸이 \(0.16 \times 0.5108 = 0.0817\) 로 거의 전부이고, \(p = 0.20\) 이 \(0.04 \times 0.2231 = 0.0089\), 나머지 다섯 칸(\(p \le 0.10\))은 다 합쳐 0.0012 이다. 점으로 줄인 것은 \(p = 0.03, 0.02, 0.01\) 의 세 칸으로 합이 0.00004 이다.
- 모두 더해 정답의 수 2 로 나눈다.
[IA-BCE] 손계산 예: 질의 3개 × 클래스 3개. 질의 0 ↔ 정답(클래스 1, IoU 0.80), 질의 1 ↔ 정답(클래스 0, IoU 0.50)
  질의 0 의 p = 0.10, 0.60, 0.05
  질의 1 의 p = 0.90, 0.20, 0.02
  질의 2 의 p = 0.03, 0.40, 0.01
  매칭된 칸 (질의 0, 클래스 1): p = 0.60, IoU = 0.80 → t = 0.60^0.25 · 0.80^0.75 = 0.8801 · 0.8459 = 0.7445
      손실 = −t·log p − (1 − t)·log(1 − p) = 0.3803 + 0.2341 = 0.6144
  매칭된 칸 (질의 1, 클래스 0): p = 0.90, IoU = 0.50 → t = 0.90^0.25 · 0.50^0.75 = 0.9740 · 0.5946 = 0.5791
      손실 = −t·log p − (1 − t)·log(1 − p) = 0.0610 + 0.9691 = 1.0301
  그 밖의 칸 (질의 1, 클래스 1): p = 0.20 → −p²·log(1 − p) = 0.0400 · 0.2231 = 0.0089
  그 밖의 칸 (질의 2, 클래스 1): p = 0.40 → −p²·log(1 − p) = 0.1600 · 0.5108 = 0.0817
  그 밖의 칸 7개의 합 = 0.0919 (p 가 작은 칸은 거의 0)
  전체 = (1.6445 + 0.0919) / 정답 2개 = 0.8682
  check 손계산 0.868188 vs ia_bce_loss 0.868188
  check 무작위 (4, 12, 3) 로짓: ia_bce_loss 15.278476 vs F.binary_cross_entropy 로 다시 계산 15.278473 (차이 2.86e-06)
손계산과 함수의 값이 0.868188 로 같고, 무작위 입력에서 PyTorch 내장 BCE 로 다시 계산한 값과도 맞는다. 이 예에서 읽을 것은 셋이다.
- 점수가 높은 쪽이 더 큰 손실을 받았다. 질의 1 은 점수 0.90 으로 자신만만하지만 박스의 IoU 가 0.50 이라 손실이 1.03 이다. 보통의 BCE(목표 1)였다면 \(-\log 0.9 = 0.105\) 로, 거의 벌을 받지 않았을 것이다. 질의 0 은 점수가 0.60 으로 낮은데 박스가 좋아(IoU 0.80) 손실이 0.61 이다. 보통 BCE 라면 \(-\log 0.6 = 0.511\).
- 음성 일곱 칸의 몫은 전체의 5% 이다(\(0.0919 / 1.7364\)). 그것도 거의 \(p = 0.40\) 인 한 칸의 것이다. \(p^2\) 이 쉬운 음성을 지웠다.
- 질의 2 의 0.40 은 "헛예측이 될 뻔한" 칸이다. 짝이 없는 질의가 클래스 1 에 0.40 을 주고 있다. 음성 항이 이 칸을 눌러 중복 예측 · 헛예측을 줄인다. 7장에서 본, NMS 없이 중복이 사라지는 원리의 분류 쪽 절반이다.
곡선으로 보기
- 그림: 그림 9-6 왼쪽: 목표 \(t = p^{0.25} u^{0.75}\) 를 점수 \(p\) 의 함수로 그린 것(IoU 0.3 · 0.5 · 0.7 · 0.9). 가운데: 양성 칸의 로짓 기울기 \(p - t\). 오른쪽: 음성 칸의 손실(세로축은 로그 눈금).
- 왼쪽: IoU 네 값에 대해 목표 t 를 점수 p 의 함수로 그린 곡선과 직선 t = p. 가운데: 양성 칸의 로짓 기울기 p − t 곡선과 보통 BCE 의 기울기 직선. 오른쪽: 음성 칸의 손실을 보통 BCE, IA-BCE, 포컬 손실로 그린 로그 축 그래프.
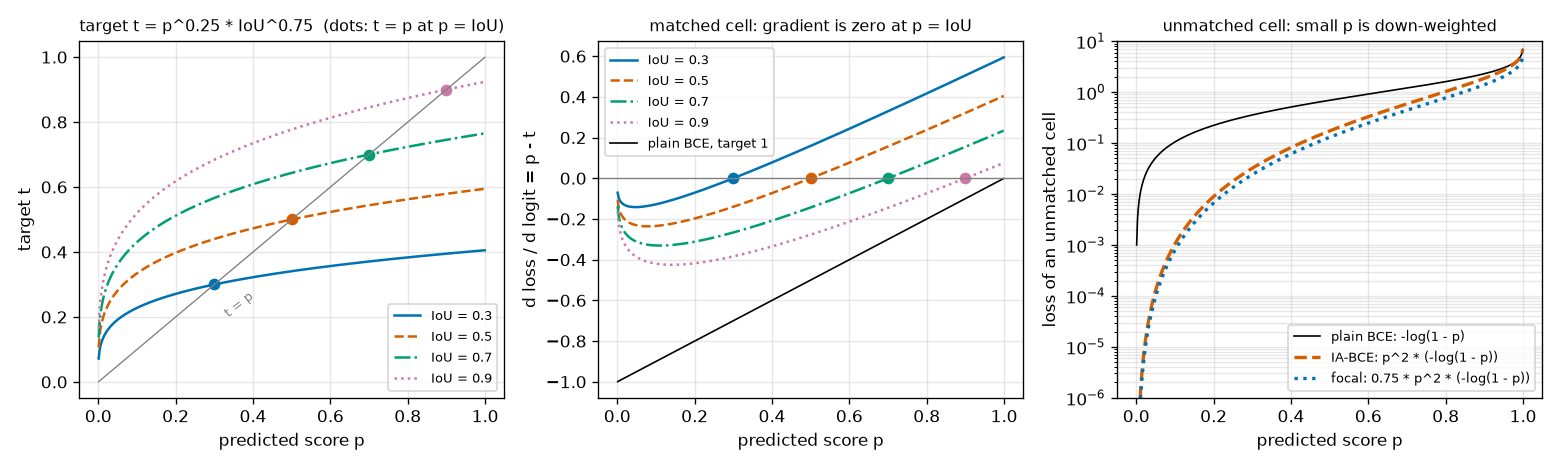
- 왼쪽. 곡선 넷은 IoU 가 다른 네 박스의 목표이다. 회색 직선은 \(t = p\) 이다. 곡선이 직선보다 위 에 있는 구간에서는 목표가 점수보다 높으므로 점수가 올라가고, 아래 에 있는 구간에서는 내려간다. 곡선과 직선이 만나는 점(동그라미)이 고정점이고, 그 가로 좌표가 정확히 IoU(0.3, 0.5, 0.7, 0.9)이다. 유도한 \(p = u\) 가 그림으로 보인다. 곡선이 \(p = 0\) 근처에서 가파르게 솟는 것은 \(p^{0.25}\) 때문이다. 점수가 0.01 처럼 아주 낮아도 목표는 그보다 훨씬 높게 잡힌다(IoU 0.9 이면 \(0.01^{0.25} \times 0.9^{0.75} = 0.3162 \times 0.9240 = 0.292\)). 학습을 시작할 때의 점수가 4장의 사전 확률 편향 초기화로 0.01 근처라는 것을 떠올리면, 처음부터 넉넉한 "올려라" 신호가 걸린다는 뜻이다.
- 가운데. 같은 내용을 기울기로 그렸다. 곡선마다 \(p = \text{IoU}\) 에서 0 을 지나고, 그 왼쪽은 음수(올려라), 오른쪽은 양수(내려라)이다. 검은 직선은 보통 BCE(목표 1)의 기울기 \(p - 1\) 이다. 언제나 음수여서 점수를 1 로만 민다. IoU 가 낮은 박스(파란 실선)일수록 높은 점수에 큰 양의 기울기가 걸린다.
- 오른쪽. 음성 칸의 손실이다. 검은 선(보통 BCE)과 견주어 주황 파선(IA-BCE)은 \(p\) 가 작을수록 크게 깎인다. \(p = 0.1\) 에서 보통 BCE 는 0.105, IA-BCE 는 0.0011 로 100분의 1 이다. 파란 점선(포컬 손실의 음성 쪽)은 주황 파선을 0.75배 한 것이라 로그 눈금에서 나란히 조금 아래에 놓인다. 두 손실의 음성 쪽은 모양이 같다.
11장의 절제 결과 미리 보기
"점수가 IoU 를 따라간다" 가 실제 학습에서 일어나는지는 11장에서 확인한다. 결과만 먼저 적는다. 도형 세상에서 미니 RF-DETR 을 같은 구조 · 같은 설정으로 두고 분류 손실만 IA-BCE 와 포컬 손실로 바꿔 학습했다(학습 4,000장, 15 에폭, 시드 셋. 포컬 손실의 계수는 1).
| 잰 것 (시드 0 / 1 / 2) | IA-BCE | 포컬 손실 |
| 검증 AP | 0.9180 / 0.9210 / 0.9163 | 0.9144 / 0.9103 / 0.9136 |
| 점수와 IoU 의 순위 상관(스피어만) | +0.659 / +0.631 / +0.667 | +0.215 / +0.318 / +0.240 |
| 평균 |점수 − IoU| | 0.035 / 0.040 / 0.036 | 0.140 / 0.165 / 0.159 |
| 평균 점수 (평균 IoU 는 둘 다 약 0.945) | 0.935 / 0.926 / 0.930 | 0.808 / 0.783 / 0.788 |
- 점수의 뜻이 달라진다. IA-BCE 로 학습한 모델은 평균 점수(0.93)가 평균 IoU(0.945)와 거의 같고, 점수와 IoU 의 순위 상관이 +0.63 – +0.67 이다. 고정점 \(p = u\) 가 실제로 나타난다. 포컬 손실로 바꾸면 상관이 +0.22 – +0.32 로 무너지고, 점수는 IoU 와 무관하게 0.78 – 0.81 에 머문다.
- 그런데 AP 의 차이는 작다. 세 시드에서 포컬 − IA-BCE 가 −0.0036, −0.0107, −0.0028 이다. 방향은 모두 IA-BCE 쪽이지만, 크기는 시드를 바꿨을 때 AP 가 달라지는 폭(0.9163 – 0.9210)과 비슷하다. 도형 세상은 그림 한 장에 도형이 1 – 4개뿐이고 박스 대부분의 IoU 가 0.9 를 넘어서, 순위를 바로잡아 얻을 것이 적기 때문으로 보인다.
논문이 COCO 에서 보고한 값은 이보다 크다. LW-DETR 표 2 에서 IoU 인지 분류 손실을 넣은 줄은 mAP 가 34.7 에서 35.4 로 0.7 오른다. Align-DETR 의 첫 판은 점수와 IoU 의 피어슨 상관이 포컬 손실 0.483 에서 IA-BCE 0.597 로 올랐다고 보고한다. 이 튜토리얼의 실험과 논문의 실험은 데이터도 모델도 다르므로 숫자를 직접 견줄 수는 없고, 방향이 같다는 것까지만 말할 수 있다.
Group DETR
둘째 학습 기법은 감독 신호의 양 을 늘린다. LW-DETR 논문은 이것을 "더 많은 감독(more supervision)" 이라는 제목 아래 한 문단으로 적는다. Group DETR(Chen 외, 2022; ICCV 2023)을 쓰고, 학습 때 가중치를 공유하는 병렬 디코더 13개를 두며, 추론에는 첫째 것만 쓴다는 내용이다.
양성이 너무 드물다
7장의 일대일 매칭은 정답 하나에 예측 하나만 짝짓는다. 그 덕분에 중복 예측이 사라지고 NMS 가 필요 없어졌다. 대가는 감독 신호가 드물다는 것이다. 질의가 300개이고 그림에 정답이 5개 있으면, "정답을 맞혀라" 는 신호(분류의 양성 목표와 박스 손실)를 받는 질의는 5개뿐이다. 나머지 295개는 "너는 아니다" 만 배운다. 박스 머리는 그림 한 장에서 박스 5개 분량의 기울기만 받는다.
YOLO 같은 탐지기는 사정이 다르다. 정답 하나에 둘레의 여러 자리를 양성으로 배정하는 일대다 배정을 쓰고, 그래서 생기는 중복을 NMS 로 지운다. 감독 신호는 넉넉하지만 NMS 가 필요하다. Group DETR 논문이 묻는 것은 이것이다. NMS 없는 추론을 지키면서 일대다 배정의 넉넉한 감독을 얻을 수 없을까.
그냥 정답 하나에 여러 질의를 짝지으면 되지 않을까? 그 논문은 이 "단순한 일대다 배정" 을 실제로 해 보고, 통하지 않는다고 보고한다(논문 표 7: 기준 모델 32.6 mAP 가 8.4 로 떨어진다). 모델이 정답 하나에 예측 여럿을 내도록 학습되는데, 그 가운데 하나만 남기고 나머지의 점수를 낮추는 장치가 없어 중복 예측이 그대로 남기 때문이다.
묶음마다 따로 일대일 매칭
Group DETR 의 답은 질의를 통째로 여러 벌 두는 것이다.
- 질의 \(N_q\) 개짜리 묶음(group)을 \(G\) 개 둔다. 질의는 모두 \(G \cdot N_q\) 개이다. 묶음마다 학습되는 질의 임베딩이 따로 있다.
- 모든 질의가 같은 디코더(같은 가중치)를 지나 예측을 낸다.
- 헝가리안 매칭을 묶음마다 따로 푼다. 묶음 하나 안에서는 7장과 똑같은 일대일 매칭이다.
- 모든 묶음의 손실을 더해 학습한다.
- 추론 때는 첫 묶음만 쓴다.
정답 쪽에서 보면 묶음마다 짝이 하나씩 생기므로, 정답 하나가 예측 \(G\) 개와 짝지어진다. 그림 한 장의 양성이 \(T\) 개에서 \(G \cdot T\) 개로 늘어난다. 묶음이 13개이고 정답이 5개면 양성이 5개에서 65개가 된다. 전체로 보면 일대다 배정이지만 묶음 하나 안에서는 여전히 일대일이다. 그 논문의 이름으로 "묶음 단위의 일대다 배정(group-wise one-to-many assignment)" 이다.
원문 그림 9-7(도식): Group DETR. 질의 묶음 세 개가 같은 디코더를 지나 예측을 내고, 묶음마다 따로 정답 두 개와 일대일 매칭을 한다. 자기 어텐션은 묶음 안에서만 일어나고 추론에는 첫 묶음만 쓴다. Group DETR(묶음 3개, 묶음마다 질의 4개, 정답 2개인 예). 묶음마다 따로 일대일 매칭을 해서, 정답 A 와 B 가 저마다 세 번씩 짝을 얻는다.
그림 9-7 에서 선을 세어 보라. 정답 A 에 닿는 선이 셋, B 에 닿는 선이 셋이다. 묶음 하나(같은 색)에서는 A 로 가는 선이 하나, B 로 가는 선이 하나뿐이다. Group DETR 논문은 이 구조를 두 가지로 풀이한다. 하나는 가중치를 공유하는 디코더 \(G\) 개를 나란히 학습하는 것 과 같다는 것이고(LW-DETR 논문의 "병렬 디코더 13개" 가 이 표현이다), 다른 하나는 질의에 대한 데이터 증강 처럼 작용한다는 것이다. 같은 그림, 같은 정답을 서로 다른 질의 묶음으로 여러 번 풀어 보게 하는 셈이다.
실습 코드의 묶음별 매칭이다. 질의 12개짜리 묶음 4개, 정답이 2개와 3개인 그림 두 장이다(긴 줄은 접어 적었다).
  묶음별 매칭 (질의 12 × 묶음 4, 그림 2장 · 정답 2개 / 3개)
    그림 0: 짝 8개 = 정답 2개 × 묶음 4개: 1(묶음 0)→정답 1, 8(묶음 0)→정답 0, 14(묶음 1)→정답 1, 20(묶음 1)→정답 0,
            29(묶음 2)→정답 0, 34(묶음 2)→정답 1, 40(묶음 3)→정답 0, 46(묶음 3)→정답 1
    그림 1: 짝 12개 = 정답 3개 × 묶음 4개: 4(묶음 0)→정답 1, 5(묶음 0)→정답 2, 8(묶음 0)→정답 0, 13(묶음 1)→정답 1,
            15(묶음 1)→정답 2, 23(묶음 1)→정답 0, 26(묶음 2)→정답 2, 28(묶음 2)→정답 1, 32(묶음 2)→정답 0,
            38(묶음 3)→정답 1, 39(묶음 3)→정답 2, 45(묶음 3)→정답 0
  check 묶음을 하나씩 떼어 7장 HungarianMatcher 로 매칭한 결과와 같은가: True
질의 번호는 0 – 47 이고, 묶음 \(g\) 의 질의는 \(12g\) 부터 \(12g + 11\) 까지이다. 그림 0 에서 정답 0 은 질의 8(묶음 0), 20(묶음 1), 29(묶음 2), 40(묶음 3)과, 정답 1 은 1, 14, 34, 46 과 짝지어졌다. 묶음마다 정확히 한 번씩이다. 마지막 줄은 이 매칭이 "묶음을 하나씩 떼어 7장의 매칭을 네 번 한 것" 과 같음을 확인한다. 새 알고리즘은 없다. 비용 행렬을 묶음별로 잘라 헝가리안 풀이를 여러 번 할 뿐이다.
손실을 나누는 수도 함께 바뀐다. 앞 절에서 분류 손실을 정답의 수로 나눈다고 했는데, 묶음을 쓰면 정답 수 × 묶음 수 로 나눈다. 양성이 \(G\) 배가 되었으니 나누는 수도 \(G\) 배이다. 그래서 손실의 크기는 묶음 수와 무관하게 "묶음별 손실의 평균" 이 된다.
묶음끼리는 서로 보지 않는다
한 가지가 더 필요하다. 디코더 층의 자기 어텐션에서 다른 묶음의 질의끼리는 서로 보지 못하게 해야 한다. 교차 어텐션과 FFN 은 질의마다 따로 계산되므로 손댈 것이 없고, 질의끼리 섞이는 곳은 자기 어텐션뿐이다.
왜 막아야 할까? 7장에서 본 대로 DETR 이 중복 예측을 없애는 길은 "일대일 매칭 + 질의끼리의 자기 어텐션" 이다. 질의는 자기 어텐션으로 다른 질의가 무엇을 맡았는지 알아보고, 이미 다른 질의가 맡은 객체라면 자기 점수를 낮추도록 배운다. 이제 묶음 0 의 질의가 묶음 1 의 질의까지 본다고 해 보자. 같은 정답 A 를 묶음 0 에서 맡은 질의와 묶음 1 에서 맡은 질의는 둘 다 양성 이다. 둘 다 높은 점수를 내야 한다. "남이 맡았으면 물러서라" 는 규칙과 "남이 맡았어도 높은 점수를 내라" 는 요구가 부딪친다. 묶음 사이에서는 중복 억제가 일어나면 안 되는데, 서로 보이면 일어나 버린다.
추론과의 일치도 걸려 있다. 추론 때는 첫 묶음만 있다. 학습 때 첫 묶음의 질의가 다른 묶음을 보며 계산했다면, 추론 때는 학습 때 한 번도 해 보지 않은 계산을 하게 된다. 묶음끼리 보지 않으면 첫 묶음의 계산은 다른 묶음이 있든 없든 같고, 학습은 정말로 "독립된 디코더 여러 개를 가중치만 공유해 나란히 돌리는 것" 이 된다.
Group DETR 논문의 설명도 같은 줄기이다. 일대일 매칭이 묶음 안에서 이뤄지므로 예측끼리의 정보도 같은 묶음 안에서만 모으면 되고, 그렇게 나눠서 하는 자기 어텐션이 다른 묶음의 영향을 없애 학습을 쉽게 한다는 것이다. 수치도 있다. 논문 표 7(Conditional DETR, 12 에폭)에서 묶음별 매칭만 넣고 자기 어텐션은 섞어 둔 모델이 34.8 mAP, 자기 어텐션까지 나눈 모델이 37.6 mAP 이다(묶음을 쓰지 않은 기준은 32.6).
두 가지 구현과 추론
"같은 묶음끼리만 본다" 를 구현하는 길은 둘이다.
- 어텐션 마스크. 5장에서 예고한 방법이다. \(G \cdot N_q\) 개 질의 전체로 자기 어텐션을 하되, 묶음이 다른 쌍을 마스크로 막는다.
- 자르기. 질의를 \(N_q\) 개씩 잘라 배치 축으로 붙인다.
(B, G·N_q, D)가(G·B, N_q, D)가 된다. 어텐션은 배치의 다른 줄을 보지 않으므로 저절로 묶음 안에서만 일어난다. 끝나면 되돌린다. 윈도 어텐션에서 윈도를 배치 축에 올린 것과 똑같은 수법 이다. RF-DETR 의 공개 코드가 이 방식을 쓴다.
def group_self_attention(attn: nn.MultiheadAttention, query: torch.Tensor, value: torch.Tensor, groups: int):
    """질의 묶음 안에서만 하는 자기 어텐션 (Group DETR). RF-DETR 공식 디코더 층이 학습 때 하는 방식 그대로다.

    query (B, G·N, D): 질의 + 위치 임베딩 (질의 · 열쇠로 쓴다).  value (B, G·N, D): 질의 (값으로 쓴다).
    질의 G·N 개를 N 개씩 G 묶음으로 잘라 **배치 축**으로 이어 붙이면 (G·B, N, D) —
    어텐션은 배치의 다른 줄을 보지 않으므로, 저절로 같은 묶음의 질의끼리만 서로 본다.
    돌려주는 값: (B, G·N, D).  groups = 1 이면 보통의 자기 어텐션과 같다 (추론).
    """
    batch, total, _ = query.shape
    if groups > 1:
        query = torch.cat(query.split(total // groups, dim=1), dim=0)  # (G·B, N, D): [묶음 0 의 B 줄, 묶음 1 의 B 줄, …]
        value = torch.cat(value.split(total // groups, dim=1), dim=0)
    out = attn(query, query, value, need_weights=False)[0]
    if groups > 1:
        out = torch.cat(out.split(batch, dim=0), dim=1)  # (B, G·N, D) 로 되돌린다
    return out

def group_attention_mask(num_queries: int, groups: int) -> torch.Tensor:
    """같은 일을 어텐션 마스크로 한다면: (G·N, G·N) bool, True = "보지 못하게 막는다". 대각선 블록만 False."""
    group_id = torch.arange(num_queries * groups) // num_queries
    return group_id[:, None] != group_id[None, :]
[Group DETR] 질의 3개 × 묶음 2개의 어텐션 마스크 (1 = 막음)
    [0, 0, 0, 1, 1, 1]
    [0, 0, 0, 1, 1, 1]
    [0, 0, 0, 1, 1, 1]
    [1, 1, 1, 0, 0, 0]
    [1, 1, 1, 0, 0, 0]
    [1, 1, 1, 0, 0, 0]
  check 질의를 잘라 배치로 붙이는 방식 vs 마스크 방식: 최대 차이 1.49e-07
  참고: 마스크 없는 보통 자기 어텐션과의 차이 0.670 (다른 계산이다)
  check 첫 묶음만 떼어 따로 돌린 결과 = 묶음 학습 때의 첫 묶음 출력: 최대 차이 0.00e+00  → 추론 때 첫 묶음만 써도 된다
- 마스크의 모양. 행이 질의, 열이 열쇠이다. 왼쪽 위와 오른쪽 아래의 3×3 블록만 0(볼 수 있음)이고 나머지는 1(막음)이다. 질의 0 – 2 는 0 – 2 만, 3 – 5 는 3 – 5 만 본다.
- 두 구현은 같은 값을 낸다(차이 \(1.5 \times 10^{-7}\)). 막힌 자리의 가중치가 정확히 0 이 되므로(5장), 마스크를 쓴 어텐션은 묶음별로 따로 한 어텐션과 같다. 마스크 없는 보통 자기 어텐션과는 0.670 만큼 다르다.
- 첫 묶음의 출력은 다른 묶음과 무관하다(차이 0). 첫 묶음만 떼어 따로 계산한 값이, 두 묶음을 함께 넣었을 때의 첫 묶음 출력과 한 비트도 다르지 않다. 이것이 "추론 때 첫 묶음만 써도 된다" 의 근거이다.
계산량으로 보면 자르는 쪽이 유리하다. 마스크 방식은 \((G \cdot N_q)^2\) 쌍을 계산한 뒤 대부분을 버리고, 자르는 방식은 처음부터 \(G \cdot N_q^2\) 쌍만 계산한다. 질의 300개 · 묶음 13개면 \(3900^2 = 15{,}210{,}000\) 쌍 대 \(13 \times 300^2 = 1{,}170{,}000\) 쌍이다.
추론의 비용은 0 이다. 추론 때는 첫 묶음의 질의 \(N_q\) 개만 넣으므로, 계산은 Group DETR 을 쓰지 않은 모델과 완전히 같다. 늘어나는 것은 학습의 비용뿐이다. 디코더가 질의 \(G\) 배 분량을 처리하고 매칭도 \(G\) 번 푼다. 첫 묶음이 특별히 좋은 것도 아니다. Group DETR 논문은 묶음마다 따로 평가했을 때 성능이 거의 같았다고 보고한다(중앙값에서 ±0.1 mAP). 그 논문의 기본 묶음 수는 11 이고, LW-DETR 과 RF-DETR 은 13 을 쓴다.
늘어나는 매개변수
디코더의 가중치는 모든 묶음이 공유하므로 디코더는 커지지 않는다. 묶음마다 따로 두어야 하는 것만 늘어난다. RF-DETR 의 공개 코드에서는 두 가지이다.
- 질의 임베딩. 묶음마다 질의 \(N_q\) 개 분량의 학습되는 임베딩이 있다. 묶음 13개 · 질의 300개면 3,900개 분량이다.
- 2단계 질의 선택의 머리. 프로젝터 출력의 칸마다 점수와 박스를 내는 층들을 묶음마다 한 벌씩 둔다. 머리가 따로이므로 묶음마다 고르는 칸과 출발하는 기준 박스가 달라진다. LW-DETR 논문도 "묶음마다 프로젝터의 출력 특징에서 객체 질의를 만든다" 고 적는다.
LW-DETR 표 2 에서 "더 많은 감독" 을 넣은 줄의 매개변수가 11.0M 에서 14.6M 으로 늘어나는 것이 이 몫이다. 같은 줄에서 연산량(16.6 GFLOPs)과 지연(2.9 ms)은 그대로이다. 추론 때는 첫 묶음만 쓰기 때문이다. 그러니 논문 표의 "매개변수 수" 에는 추론 때 쓰이지 않는 가중치가 섞여 있다. RF-DETR Nano 로 세어 보면 전체 약 30.5M 가운데 약 3.6M 이 학습 때만 쓰이는 묶음 12개 분량이다. 이 셈은 10장에서 부품별로 한다.
효과는 논문 표 2 에서 이 장의 기법 가운데 사전 학습 다음으로 크다. mAP 가 35.4 에서 38.4 로 3.0 오른다(12 에폭 학습 기준). 이 튜토리얼의 도형 세상 실험(11장)에서는 효과가 보이지 않았다. 묶음 4개와 1개의 AP 차이가 시드 셋에서 −0.0024, −0.0045, −0.0005(묶음 1개 − 4개)로, 방향은 같지만 시드 사이의 폭보다 작다. 질의가 12개뿐이고 그림마다 도형이 1 – 4개라, 묶음이 하나여도 질의의 상당수가 양성인 탓일 수 있다. 확인하지는 않았다.
박스 재매개변수화
셋째는 박스 머리가 내는 숫자의 뜻 을 바꾸는 것이다. LW-DETR 논문은 부록 A.3 에서 Plain DETR(Lin 외, 2023, "DETR Doesn't Need Multi-Scale or Locality Design")을 따라 박스 재매개변수화(box regression target reparameterization) 를 쓴다고 적는다. 1단계(질의 선택)의 박스와 디코더 층마다의 박스에 모두 적용한다. 논문은 이 기법이 새로운 것이 아니라 2단계 · 1단계 탐지기들에서 널리 쓰여 온 것이라고 밝힌다.
8장의 방식과 무엇이 다른가
8장에서 박스는 "기준 박스 + 머리가 낸 변화량" 이었고, 더하는 곳이 로짓 공간이었다. 기준 박스의 네 좌표를 역시그모이드로 로짓으로 보내고, 변화량 \(\Delta b\) 를 더한 뒤, 시그모이드로 되돌렸다.
\(\text{8장:}\qquad \hat{b} = \sigma\big(\Delta b + \sigma^{-1}(b_{\text{기준}})\big) \qquad (\text{네 좌표 각각})\)
이 방식은 결과가 늘 0 과 1 사이에 놓인다는 장점이 있다. 그런데 변화량의 뜻이 기준 박스의 크기와 무관 한다. 중심 좌표에 \(\Delta b_x = 0.5\) 를 더하면, 기준 박스가 손톱만 하든 그림의 절반을 덮든 중심이 같은 거리만큼 움직인다. 작은 박스에게는 자기 너비의 몇 배나 되는 큰 이동이고, 큰 박스에게는 살짝 움직인 것이다. 머리는 같은 일("오른쪽으로 반 박스만큼")을 하려고 박스 크기마다 다른 숫자를 내야 한다.
식과 역변환
재매개변수화는 변화량 \((\delta_x, \delta_y, \delta_w, \delta_h)\) 를 다음과 같이 쓴다(LW-DETR 논문 식 6).
\(\hat{x} = \delta_x\, w_r + x_r, \qquad \hat{y} = \delta_y\, h_r + y_r, \qquad \hat{w} = e^{\delta_w}\, w_r, \qquad \hat{h} = e^{\delta_h}\, h_r\)
- 중심. \(\delta_x\) 는 "기준 박스 너비의 몇 배 만큼 가로로 옮길까" 이다. \(\delta_x = 0.5\) 는 너비의 절반만큼 오른쪽으로, \(-1\) 은 너비만큼 왼쪽으로. \(\delta_y\) 는 높이를 단위로 같은 일을 한다.
- 크기. \(\delta_w\) 는 "너비를 몇 배 로 할까" 의 로그이다. \(e^{\delta_w}\) 를 곱하므로 \(\delta_w = 0\) 이면 그대로, \(\log 2 = 0.693\) 이면 2배, \(-0.693\) 이면 절반이다. 지수 함수는 늘 양수이므로 너비가 0 이하가 될 수 없다.
- 시그모이드가 없다. 결과를 0 과 1 사이로 누르는 장치가 없으므로 박스가 그림 밖으로 조금 나갈 수 있다. RF-DETR 의 공개 코드도 잘라 내지 않는다.
거꾸로, 기준 박스를 정답 박스 \((x_g, y_g, w_g, h_g)\) 에 꼭 맞추려면 머리가 어떤 값을 내야 하는지도 구할 수 있다. 위 식을 \(\delta\) 에 대해 푼다.
- 역변환: 기준 박스를 정답 박스로 옮기는 변화량
- \(x_g = \delta_x\, w_r + x_r \;\Longleftrightarrow\; \delta_x = \frac{x_g - x_r}{w_r}\)
- \(\hat{x}\) 자리에 정답의 중심 \(x_g\) 를 놓고, \(x_r\) 을 넘긴 뒤 \(w_r\) 로 나눴다. 중심이 벗어난 거리를 기준 박스의 너비로 잰 것이다. \(\delta_y = (y_g - y_r) / h_r\) 도 같다.
- \(w_r\) 로 나누고 양변에 로그를 씌웠다. 너비의 비 의 로그이다. \(\delta_h = \log(h_g / h_r)\) 도 같다.
- Plain DETR 논문이 박스 회귀의 목표로 적은 식(그 논문의 식 6)이 이것이다. 코드의
box_reparam_inverse이기도 하다.
크기에 비례해 움직인다
이 꼴의 요점은 변화량이 박스의 크기를 단위로 잰 값이라는 것이다. 그림을 통째로 \(k\) 배 확대해도(기준 박스와 정답 박스의 좌표 · 크기가 모두 \(k\) 배) 필요한 변화량이 같다.
- 변화량은 박스의 크기와 무관하다
- \(\delta_x' = \frac{k\,x_g - k\,x_r}{k\,w_r} = \frac{k\,(x_g - x_r)}{k\,w_r} = \frac{x_g - x_r}{w_r} = \delta_x\)
- 분자와 분모의 \(k\) 가 약분된다. 중심의 어긋남이 너비의 몇 배인지는 확대해도 그대로이다.
- 너비의 비도 확대와 무관하다. 큰 객체든 작은 객체든 "반 박스만큼 옆으로, 1.5배로 키워라" 는 같은 \(\delta\) 이다.
2장에서 IoU 가 크기 불변이라는 것을 보았다. 재매개변수화는 박스 머리의 출력에 같은 성질을 준다. Plain DETR 논문은 동기를 이렇게 적는다. 원래의 DETR 과 대부분의 변형은 박스의 중심과 크기를 그대로 [0, 1] 로 맞춰 다루는데, 그러면 손실 계산을 큰 객체가 지배해 작은 객체를 찾기 어렵다. 그 논문은 자기 모델(평범한 ViT 위의 DETR)에서 이 변경으로 AP 가 2.2, 작은 객체의 AP 가 2.9 올랐다고 보고한다. LW-DETR 표 2 에서는 mAP 가 38.4 에서 38.6 으로 0.2 오르고, 논문은 이것을 "약간의 향상" 이라고 적는다. 두 논문은 출발점이 되는 모델이 다르므로 이득의 크기도 다르다. 이 튜토리얼은 재매개변수화를 켜고 끈 학습을 견주어 보지 않았다.
손계산과 그림
같은 변화량 \(\delta = (0.5,\ 0,\ 0.2,\ 0)\) 을 크기가 다른 두 기준 박스에 적용해, 두 방식을 견준다. 작은 박스는 \((0.5, 0.5, 0.05, 0.05)\), 큰 박스는 \((0.5, 0.5, 0.40, 0.40)\) 이다.
- 같은 변화량, 다른 크기의 기준 박스
- \(\text{재매개변수화, 작은 박스:}\quad \hat{x} = 0.5 \times 0.05 + 0.5 = 0.525, \qquad \hat{w} = e^{0.2} \times 0.05 = 1.2214 \times 0.05 = 0.0611\)
- 중심이 \(0.025\) 움직였다. 너비 \(0.05\) 의 절반이다. 너비는 1.22배.
- 중심이 \(0.20\) 움직였다. 이번에도 너비 \(0.40\) 의 절반이다. 너비는 똑같이 1.22배.
- \(\sigma^{-1}(0.5) = \log(0.5/0.5) = 0\) 이다. 로짓 공간의 덧셈에는 박스의 너비가 들어가지 않으므로 두 박스의 중심이 똑같이 \(0.1225\) 움직인다.
- \(\sigma^{-1}(0.05) = \log(0.05/0.95) = -2.9444\), \(\sigma^{-1}(0.40) = \log(0.4/0.6) = -0.4055\). 작은 박스는 1.21배, 큰 박스는 1.12배가 되었다. 배율이 박스 크기에 따라 다르다.
- 재매개변수화에서는 같은 \(\delta\) 가 두 박스에 같은 뜻(너비의 0.5배)이다. 8장 방식에서는 작은 박스가 자기 너비의 2.45배나 튀어 나가고, 큰 박스는 0.31배만 움직인다. 8배 차이는 두 박스의 너비 비 \(0.40 / 0.05\) 그대로이다.
def box_reparam(delta: torch.Tensor, reference: torch.Tensor) -> torch.Tensor:
    """박스 재매개변수화: 머리가 낸 델타 (δx, δy, δw, δh) 로 기준 박스 (cx, cy, w, h) 를 고친다.

      cx' = δx · w + cx        cy' = δy · h + cy        (중심은 "기준 박스 크기의 몇 배" 만큼 움직인다)
      w'  = exp(δw) · w        h'  = exp(δh) · h        (크기는 "몇 배" 로 바뀐다)

    delta · reference: (..., 4), 기준 박스는 정규화 좌표 (로짓 아님). 시그모이드를 거치지 않으므로 결과가 0 – 1 을
    벗어날 수 있다. δ = 0 이면 기준 박스 그대로다.
    """
    cxcy = delta[..., :2] * reference[..., 2:] + reference[..., :2]
    wh = delta[..., 2:].exp() * reference[..., 2:]
    return torch.cat([cxcy, wh], dim=-1)

def box_reparam_inverse(box: torch.Tensor, reference: torch.Tensor) -> torch.Tensor:
    """box_reparam 의 역: 기준 박스를 box 로 옮기는 델타. (머리가 맞혀야 하는 값이 얼마인지 볼 때 쓴다.)"""
    return torch.cat([(box[..., :2] - reference[..., :2]) / reference[..., 2:],
                      (box[..., 2:] / reference[..., 2:]).log()], dim=-1)

def box_sigmoid_update(delta: torch.Tensor, reference: torch.Tensor) -> torch.Tensor:
    """비교용 — 8장(Deformable DETR)의 방식: 로짓 공간에서 더하고 시그모이드. σ(δ + σ⁻¹(기준 박스))."""
    return (delta + inverse_sigmoid(reference)).sigmoid()
[박스 재매개변수화] 같은 델타 δ = (0.5, 0, 0.2, 0) 를 크기가 다른 두 기준 박스에 적용
  작은 기준 박스 (0.5000, 0.5000, 0.0500, 0.0500)
    재매개변수화: cx = 0.5·0.05 + 0.50 = 0.5250, w = e^0.2·0.05 = 0.0611  → (0.5250, 0.5000, 0.0611, 0.0500)
    시그모이드  : cx = σ(0.5 + σ⁻¹(0.50)) = 0.6225, w = σ(0.2 + σ⁻¹(0.05)) = 0.0604  → (0.6225, 0.5000, 0.0604, 0.0500)
    중심 이동량 / 기준 너비: 재매개변수화 0.500, 시그모이드 2.449 | 너비 배율: 재매개변수화 1.221, 시그모이드 1.208
  큰 기준 박스   (0.5000, 0.5000, 0.4000, 0.4000)
    재매개변수화: cx = 0.5·0.40 + 0.50 = 0.7000, w = e^0.2·0.40 = 0.4886  → (0.7000, 0.5000, 0.4886, 0.4000)
    시그모이드  : cx = σ(0.5 + σ⁻¹(0.50)) = 0.6225, w = σ(0.2 + σ⁻¹(0.40)) = 0.4488  → (0.6225, 0.5000, 0.4488, 0.4000)
    중심 이동량 / 기준 너비: 재매개변수화 0.500, 시그모이드 0.306 | 너비 배율: 재매개변수화 1.221, 시그모이드 1.122
  check box_reparam(box_reparam_inverse(box, ref), ref) = box: 최대 차이 5.96e-08
  check δ = 0 이면 기준 박스 그대로: True
출력의 수치가 손계산과 같다. 끝의 두 줄은 덤으로 확인한 것이다. 역변환으로 구한 변화량을 다시 적용하면 원래 박스가 나오고(오차 \(6 \times 10^{-8}\)), \(\delta = 0\) 이면 기준 박스가 그대로 나온다. 뒤쪽이 중요하다. RF-DETR 의 박스 머리는 마지막 층의 가중치와 편향을 0 으로 초기화하므로, 학습을 시작할 때 모든 \(\delta\) 가 0 이다. 그러면 처음의 예측 박스는 기준 박스 그대로이다. 머리는 "기준에서 얼마나 고칠까" 를 0 에서부터 배워 나간다. 중심 식에 \(\delta_x = 0\) 을 넣으면 \(\hat{x} = x_r\), 크기 식에 \(\delta_w = 0\) 을 넣으면 \(\hat{w} = e^0 w_r = w_r\) 이다.
- 그림: 그림 9-8 같은 변화량 \(\delta = (0.5,\ 0.25,\ 0.4,\ 0)\) 을 작은 기준 박스(파랑, 너비 0.10)와 큰 기준 박스(주황, 너비 0.30)에 적용한 결과. 점선이 기준 박스, 실선이 고친 박스, 화살표가 중심의 이동이다. 세로축은 아래로 갈수록 커진다.
- 같은 변화량을 작은 기준 박스와 큰 기준 박스에 적용한 결과. 왼쪽은 재매개변수화, 오른쪽은 시그모이드 방식. 점선이 기준 박스, 실선이 고친 박스, 화살표가 중심의 이동.
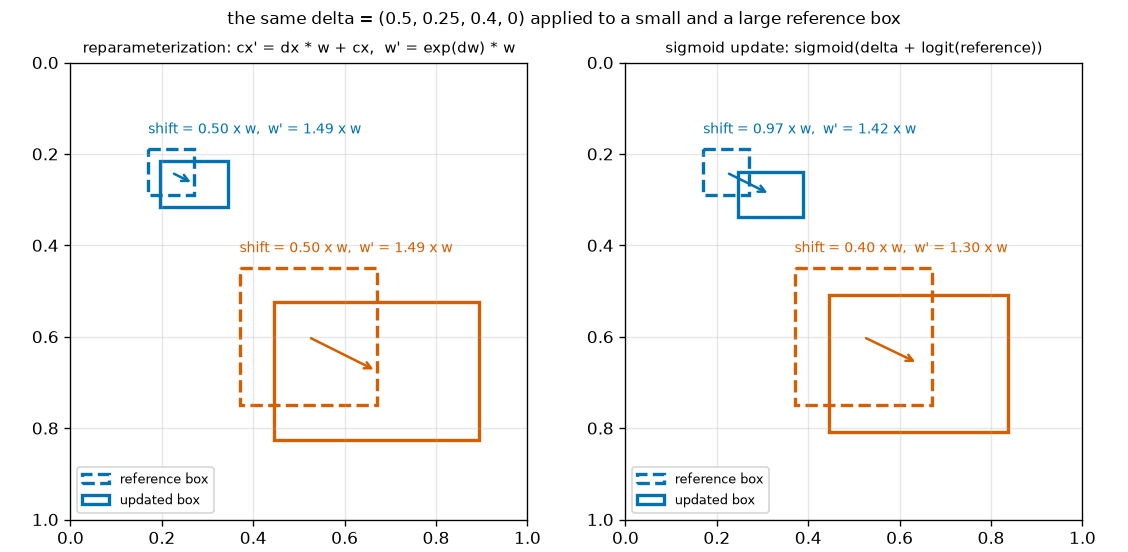
그림 9-8 은 손계산과 다른 변화량으로 같은 것을 보여 준다.
- 왼쪽(재매개변수화). 두 박스 위의 글이 같다. "너비의 0.50배 이동, 너비 1.49배(\(e^{0.4} = 1.49\))". 파란 화살표와 주황 화살표는 길이가 3배 다르지만, 저마다 자기 박스에 견주면 같은 비율이다. 큰 그림을 줄여 놓으면 작은 그림과 겹친다.
- 오른쪽(8장의 시그모이드 방식). 작은 박스는 너비의 0.97배, 큰 박스는 0.40배 움직였고, 너비의 배율도 1.42 와 1.30 으로 다르다. 같은 숫자가 박스마다 다른 뜻이 된다.
도형 세상에서 필요한 델타
머리가 실제로 내야 하는 값은 어느 정도일까? 8장의 2단계 방식에서 디코더의 기준 박스는 특징 맵 칸마다의 제안 박스에서 출발했다. 칸의 중심에 놓인 너비 · 높이 0.05 의 작은 박스이다. 도형 세상의 정답 박스 501개(검증용 그림 200장)에 대해, 그 중심이 놓인 칸의 제안 박스에서 정답까지 가는 데 필요한 \(\delta\) 를 역변환으로 구했다.
  도형 세상 정답 501개를 '중심이 놓인 칸의 제안 박스 (칸 중심, 0.05, 0.05)' 에서 맞히는 데 필요한 델타
    |δx|, |δy| 최대 0.832 (반 칸 = 0.0417 / 0.05 = 0.833 이하), δw, δh 범위 1.030 – 2.127 (= log(정답 크기 / 0.05), 정답 크기 0.140 – 0.420)
- 중심. 12×12 격자에서 칸의 너비는 \(1/12 = 0.0833\) 이고, 정답의 중심은 칸 중심에서 많아야 반 칸(\(0.0417\)) 떨어져 있다. 이것을 제안 박스의 너비 0.05 로 나누면 \(0.0417 / 0.05 = 0.833\) 이다. 그래서 \(|\delta_x|, |\delta_y| \le 0.833\) 이다.
- 크기. 도형 세상의 정답은 너비 · 높이가 0.14 에서 0.42 사이이다. \(\delta_w = \log(0.14 / 0.05) = \log 2.8 = 1.030\) 에서 \(\log(0.42 / 0.05) = \log 8.4 = 2.128\) 까지이다. 제안 박스를 2.8배에서 8.4배로 키우는 일이다.
네 값 모두 크기가 1 안팎인 수이다. 신경망이 내기에 무리가 없는 범위이다. 8장의 방식이라면 같은 일에 로짓으로 \(\sigma^{-1}(0.42) - \sigma^{-1}(0.05) = -0.32 + 2.94 = 2.62\) 를 더해야 한다. 어느 쪽이 학습에 더 유리한지는 이 튜토리얼에서 실험하지 않았다. 앞에서 적은 대로 LW-DETR 논문이 COCO 에서 보고한 차이는 0.2 mAP 이다.
섞은 질의 선택과 사전 학습
섞은 질의 선택
LW-DETR 의 디코더가 질의를 얻는 방법은 8장에서 이미 만든 것이다. 논문 3.1절은 이것을 DINO(Zhang 외, 2022. 6장의 자기 지도 학습 DINO 와 이름만 같은 탐지기이다)의 방식을 따른 섞은 질의 선택(mixed-query selection) 이라고 부르고, 객체 질의를 두 부분의 합으로 설명한다.
- 내용 질의(content query): 7장의 DETR 처럼 학습되는 임베딩 이다. 그림과 무관하게 질의 자리마다 정해져 있다.
- 공간 질의(spatial query): 그림을 보고 정한다. 프로젝터의 마지막 출력에서 점수가 높은 칸을 \(N_q\) 개 고르고, 그 칸에서 박스를 예측하고, 그 박스를 임베딩으로 바꾼다. 8장의 2단계 방식이다.
"섞은" 은 둘의 출처가 다르다는 뜻이다. 어디를 볼지(위치)는 그림에서 고르고, 무엇을 찾을지(내용)는 학습된 임베딩으로 둔다. 8장의 구현이 바로 이 꼴이었다. 고른 칸의 박스가 디코더의 기준 박스가 되었고, 질의의 내용은 학습되는 임베딩이었다. 달라지는 것은 그 박스를 다루는 방식(재매개변수화)과 질의 묶음(Group DETR)이고, RF-DETR 의 실제 코드로 다시 조립하는 일은 10장에서 한다.
Objects365 사전 학습
LW-DETR 의 마지막 재료는 구조가 아니라 데이터 이다. 논문은 COCO 로 학습하기 전에 더 큰 탐지 데이터셋 Objects365(1장)로 사전 학습을 한다. 두 단계이다.
- 인코더의 사전 학습. ViT 를 Objects365 의 그림으로 CAEv2 라는 방법으로 사전 학습한다. 그림의 일부를 가리고 맞히게 하는 계열의 자기 지도 학습이다(6장에서 본 자기 지도 학습의 다른 갈래). 논문은 이것으로 COCO 에서 0.7 mAP 를 얻는다고 적는다.
- 탐지기 전체의 사전 학습. 인코더를 이어서 학습하면서 프로젝터와 디코더를 Objects365 의 박스 라벨로 지도 학습한다(30 에폭). 그 뒤에 COCO 로 미세 조정한다.
효과는 이 장의 모든 기법을 합친 것보다 크다. 표 2 에서 사전 학습을 넣은 줄은 mAP 가 38.6 에서 47.3 으로 8.7 오른다. 논문은 이것을 두고 Transformer 가 큰 데이터의 덕을 본다고 적는다. 끝까지 학습한 다섯 모델로 견준 표 5 에서도 사전 학습의 이득은 평균 5.5 mAP 이다(tiny 36.5 → 42.6, xlarge 53.0 → 58.3).
논문은 흥미로운 대조도 보고한다. 같은 Objects365 사전 학습이 YOLO 계열에는 별로 도움이 되지 않았다. 표 3 에서 YOLOv8n 은 37.4 에서 37.6, RTMDet-s 는 44.6 에서 44.9 로 오를 뿐이다. 논문은 그 까닭을 단정하지 않는다. 이 탐지기들은 300 – 500 에폭이나 학습하므로 사전 학습의 이득이 학습이 길어질수록 사라지는 것일 수 있다는 실험을 하나 싣고, 더 조사가 필요하다고 적는다. 어느 쪽이든 DETR 계열은 큰 데이터로 미리 배운 가중치에서 많은 것을 얻는다 는 관찰이 남고, 이것이 RF-DETR 이 인터넷 규모로 사전 학습된 DINOv2 를 백본으로 고른 배경이다.
논문 표 2 를 계단식으로 읽기
이 장에서 조금씩 인용한 LW-DETR 논문 표 2 를 한자리에 모은다. 전역 어텐션만 쓰고 마지막 층의 특징 맵만 내는 "처음 탐지기" 에서 출발해, 한 줄에 하나씩 기법을 쌓아 small 모델에 이르는 절제 실험이다. 마지막 줄을 뺀 모든 줄은 45,000 스텝(12 에폭)만 학습한 값이다. 오른쪽 끝 열은 바로 윗줄과의 mAP 차이로, 논문의 표에는 없고 여기서 뺄셈한 것이다.
| 설정 (위에서부터 누적) | 매개변수 | 연산량 | 지연 | mAP | 차이 |
| 처음 탐지기 | 10.8M | 22.8 G | 3.6 ms | 35.3 | |
| + 다층 특징 집계 | 11.0M | 23.0 G | 3.7 ms | 36.0 | +0.7 |
| + 윈도 · 전역 어텐션 번갈아 (ViTDet 방식 구현) | 11.0M | 16.6 G | 3.9 ms | 34.7 | −1.3 |
| + 윈도 우선 배치 | 11.0M | 16.6 G | 2.9 ms | 34.7 | 0 |
| + IoU 인지 분류 손실 (IA-BCE) | 11.0M | 16.6 G | 2.9 ms | 35.4 | +0.7 |
| + 더 많은 감독 (Group DETR) | 14.6M | 16.6 G | 2.9 ms | 38.4 | +3.0 |
| + 박스 재매개변수화 | 14.6M | 16.6 G | 2.9 ms | 38.6 | +0.2 |
| + Objects365 사전 학습 | 14.6M | 16.6 G | 2.9 ms | 47.3 | +8.7 |
| LW-DETR-small (180,000 스텝까지 학습) | 14.6M | 16.6 G | 2.9 ms | 48.0 | +0.7 |
표를 계단처럼 한 칸씩 내려가며 읽는다.
- 속도를 바꾸는 줄은 둘뿐이다. 윈도 어텐션(연산량 23.0 → 16.6 GFLOPs)과 윈도 우선 배치(지연 3.9 → 2.9 ms)이다. 그 아래 다섯 줄은 연산량과 지연이 한 번도 바뀌지 않는다. IA-BCE, Group DETR, 재매개변수화, 사전 학습은 모두 학습 방법 이어서 추론 때의 계산을 건드리지 않는다.
- 윈도 어텐션은 정확도를 값으로 치른다. 1.3 mAP 를 내주고 지연 0.8 ms(3.7 → 2.9)를 얻었다. 그 손해는 바로 아래의 학습 기법들이 갚고도 남는다. "구조는 빠르게, 정확도는 학습으로" 가 LW-DETR 의 설계이다.
- 가장 큰 두 계단은 감독 신호와 데이터이다. Group DETR 이 +3.0, 사전 학습이 +8.7 이다. 두 줄을 합친 11.7 이 처음 탐지기에서 최종 모델까지 오른 12.7 mAP 의 대부분이다.
- 매개변수가 늘어나는 줄은 Group DETR 뿐이다(11.0M → 14.6M). 앞에서 본 대로 묶음마다 따로 두는 질의 임베딩과 질의 선택 머리의 몫이고, 추론 때는 쓰이지 않는다.
- 누적 절제를 읽을 때
- 이런 표의 "차이" 는 그 기법의 값어치가 아니라 그 순서로 쌓았을 때의 증가분이다. 순서를 바꾸면 달라질 수 있다. 예를 들어 사전 학습을 먼저 넣은 뒤에 Group DETR 을 더했다면 +3.0 보다 작았을 수도, 컸을 수도 있다. 논문은 그 실험을 싣지 않는다. 또 12 에폭 학습에서의 차이가 끝까지 학습했을 때도 그대로라는 보장도 없다. Group DETR 처럼 수렴을 빠르게 하는 기법은 짧은 학습에서 특히 크게 보인다.
구현 따라 읽기
부품별 코드는 앞에서 대부분 보았다. 여기서는 실습 파일 전체를 돌리는 방법과, 아직 열어 보지 않은 윈도 ViT 인코더 · 프로젝터 · 묶음별 매칭의 코드를 읽는다. 이 파일의 부품들은 10장의 미니 RF-DETR 이 그대로 가져다 쓴다.
실행
$ python ch09_lwdetr_parts.py            # 본문의 결과 (노트북 GPU 에서 약 32초)
$ python ch09_lwdetr_parts.py --quick    # 줄인 판 (CPU 에서 약 7초)
이 파일은 학습을 하지 않는다. 부품마다 손계산 예를 출력하고, PyTorch 내장 연산과 값을 대조하고, 그림 다섯 장을 그린다. 시간의 대부분은 윈도 어텐션의 시간 측정(48×48 격자, 세 방식 × 40바퀴)에 든다. --quick 은 측정 바퀴 수와 격자 크기만 줄인다. 실행 순서는 아래와 같고, 출력의 마지막 두 줄은 다음과 같다.
def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--quick", action="store_true")
    parser.add_argument("--fig-dir", default="figures")
    parser.add_argument("--seed", type=int, default=0)
    args = parser.parse_args()
    import matplotlib
    matplotlib.use("Agg")
    os.makedirs(args.fig_dir, exist_ok=True)
    torch.manual_seed(args.seed)
    device = get_device()
    if device == "cpu":
        torch.set_num_threads(4)
    start = time.time()
    print(f"장치: {device}")

    toy_window_order()
    pair_rows, time_rows = window_checks(device, args.quick)
    vit = vit_checks()
    projector_checks(vit)
    ia_bce_checks()
    group_checks()
    reparam_checks()

    plot_window_order(os.path.join(args.fig_dir, "ch09-window-order.png"))
    plot_window_cost(pair_rows, time_rows, device, os.path.join(args.fig_dir, "ch09-window-cost.png"))
    shares = plot_influence(os.path.join(args.fig_dir, "ch09-window-influence.png"))
    print("[그림 ch09-window-influence] 출력 칸 (행 2, 열 3) 이 받는 영향 가운데 자기 윈도 안 패치의 몫: "
          f"윈도 블록만 {shares[0]:.3f}, 윈도 + 전역 {shares[1]:.3f}, 전역만 {shares[2]:.3f}")
    plot_ia_bce(os.path.join(args.fig_dir, "ch09-ia-bce.png"))
    plot_reparam(os.path.join(args.fig_dir, "ch09-reparam.png"))
    print(f"그림 5장 저장: {args.fig_dir}/ch09-*.png  |  전체 {time.time() - start:.1f}초")
[그림 ch09-window-influence] 출력 칸 (행 2, 열 3) 이 받는 영향 가운데 자기 윈도 안 패치의 몫: 윈도 블록만 1.000, 윈도 + 전역 0.910, 전역만 0.838
그림 5장 저장: /home/zer0/Projects/pages/public/rf-detr/figures/ch09-*.png  |  전체 32.1초
윈도 ViT 인코더
인코더는 블록부터 본다. SelfAttention 은 5장의 다중 머리 자기 어텐션 그대로이고, ViTBlock 은 6장의 pre-norm 블록에 merge 인자 하나를 더한 것이다. merge=1 이면 들어온 모양 그대로 어텐션을 하고(윈도 우선 배치에서는 이것이 윈도 어텐션이다), merge=m 이면 배치의 이웃한 \(m\) 줄을 view 로 한 줄로 붙여 어텐션을 한 뒤 되돌린다(전역 어텐션). 윈도 어텐션과 전역 어텐션의 차이가 모양 바꾸기 두 줄 로 줄어든 것을 확인하라. 어텐션 뒤의 MLP 는 토큰마다 따로 계산되므로 어느 모양으로 넣어도 같다.
class SelfAttention(nn.Module):
    """다중 머리 자기 어텐션 (5장). 입력 (B, T, C) 의 토큰 T 개가 서로를 본다 — 배치의 다른 줄은 보지 않는다.

    "윈도 어텐션" 을 위한 특별한 코드는 없다. 윈도를 배치 축에 올려 (B·윈도 수, 윈도 안 토큰 수, C) 로 넣으면
    이 모듈이 저절로 윈도 안에서만 어텐션을 한다.
    """

    def __init__(self, dim: int, heads: int):
        super().__init__()
        assert dim % heads == 0
        self.heads = heads
        self.qkv = nn.Linear(dim, 3 * dim)  # 질의 · 열쇠 · 값 투영을 한 번에
        self.proj = nn.Linear(dim, dim)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        batch, tokens, dim = x.shape
        qkv = self.qkv(x).view(batch, tokens, 3, self.heads, dim // self.heads).permute(2, 0, 3, 1, 4)
        q, k, v = qkv[0], qkv[1], qkv[2]  # 각각 (B, 머리, T, C/머리)
        out = F.scaled_dot_product_attention(q, k, v)  # softmax(QKᵀ/√d)·V — 계산량이 T² 에 비례한다
        return self.proj(out.transpose(1, 2).reshape(batch, tokens, dim))

class ViTBlock(nn.Module):
    """ViT 블록 한 개 (pre-norm): x + γ₁·어텐션(LN(x)), 이어서 x + γ₂·MLP(LN(x)).

    DINOv2 처럼 잔차 가지마다 학습되는 배율 γ (LayerScale) 가 있다. merge 인자가 윈도 · 전역을 가른다.
    """

    def __init__(self, dim: int, heads: int, mlp_ratio: float = 4.0, layer_scale: float = 1.0):
        super().__init__()
        self.norm1 = nn.LayerNorm(dim, eps=1e-6)
        self.attn = SelfAttention(dim, heads)
        self.gamma1 = nn.Parameter(torch.full((dim,), layer_scale))
        self.norm2 = nn.LayerNorm(dim, eps=1e-6)
        hidden = int(dim * mlp_ratio)
        self.mlp = nn.Sequential(nn.Linear(dim, hidden), nn.GELU(), nn.Linear(hidden, dim))
        self.gamma2 = nn.Parameter(torch.full((dim,), layer_scale))

    def forward(self, x: torch.Tensor, merge: int = 1) -> torch.Tensor:
        """x: (B', T, C).  merge = 1 이면 들어온 모양 그대로 어텐션 (윈도 우선 배치에서는 "윈도 어텐션").

        merge = m > 1 이면 배치의 이웃한 m 줄을 한 줄로 이어 붙여 (B'/m, m·T, C) 로 보고 어텐션을 한 뒤 되돌린다.
        윈도 우선 배치에서 m = 윈도 수면 "전역 어텐션" 이다. 메모리에서 이웃한 줄을 붙이는 것이라 view 만으로 된다
        (값을 옮기지 않는다) — 이것이 윈도 우선 배치의 이득이다.
        """
        shape = x.shape
        y = self.norm1(x)
        if merge > 1:
            y = y.view(shape[0] // merge, merge * shape[1], shape[2])
        y = self.attn(y).view(shape)
        x = x + self.gamma1 * y
        return x + self.gamma2 * self.mlp(self.norm2(x))
잔차 가지마다 곱해지는 gamma1 · gamma2 는 DINOv2 의 블록에 있는 학습되는 배율(LayerScale)이다. RF-DETR 의 백본과 같은 꼴로 맞추려고 넣었고, 초기값이 1 이라 처음에는 없는 것과 같다.
어느 블록을 윈도로 할지는 공개 구현의 규칙을 그대로 옮긴 함수가 정한다.
def compute_window_block_indexes(out_feature_indexes, window_block_indexes=None):
    """어느 블록이 윈도 어텐션을 쓰는가 (0 부터 센 블록 번호의 목록). 공식 구현의 규칙 그대로다.

    따로 지정하지 않으면 0 … out_feature_indexes[-1] 가운데 out_feature_indexes 에 **없는** 번호가 윈도 블록이다.
    예: [3, 6, 9, 12] → 윈도 [0, 1, 2, 4, 5, 7, 8, 10, 11], 전역은 블록 3, 6, 9.
    out_feature_indexes 의 숫자 i 는 "블록 i 개를 지난 뒤의 특징" 이라는 뜻이므로 (0 = 임베딩 직후),
    특징을 꺼낸 **바로 다음** 블록이 전역 블록이 된다.
    """
    if window_block_indexes is not None:
        return sorted(window_block_indexes)
    return sorted(set(range(out_feature_indexes[-1] + 1)) - set(out_feature_indexes))
규칙은 "특징 맵을 꺼내는 자리가 아닌 블록이 윈도 블록" 이다. out_feature_indexes 의 숫자 \(i\) 는 "블록 \(i\) 개를 지난 뒤의 특징" 을 뜻한다(0 은 임베딩 직후). 미니 모델은 (2, 4, 6) 이므로 0 – 6 가운데 2, 4, 6 을 뺀 0, 1, 3, 5 번 블록이 윈도, 2, 4 번 블록이 전역이다(6 은 블록 번호의 범위 0 – 5 밖이라 해당하는 블록이 없다). 특징을 꺼낸 바로 다음 블록이 전역 블록이 되는 무늬이다. RF-DETR Nano 의 설정 [3, 6, 9, 12] 를 넣으면 12개 블록 가운데 3, 6, 9 번이 전역이고 나머지 9개가 윈도이다. 논문 부록에 적힌 윈도 블록의 번호와 공개 코드의 이 동작이 다르다는 점은 10장에서 짚는다.
(원문에서 접혀 있는 windowed-vit 영역의 코드는 ch09_lwdetr_parts.py 에 있다.)
WindowedViT.forward 의 다섯 단계를 텐서 모양으로 따라간다(그림 2장, 96×96, 패치 8, 차원 96, 윈도 2×2).
[WindowedViT] 기본 설정: 그림 96, 패치 8, 차원 96, 블록 6, 머리 4, 꺼내는 층 [2, 4, 6], 윈도 2×2
  윈도 블록 [0, 1, 3, 5], 전역 블록 [2, 4], 매개변수 705,024개
  공식 규칙 확인: compute_window_block_indexes([3, 6, 9, 12]) = [0, 1, 2, 4, 5, 7, 8, 10, 11]
  모양 추적 (B = 2)
    그림                         (2, 3, 96, 96)
    패치 임베딩 + CLS + 위치      (2, 145, 96)   (1 + 12·12 토큰)
    윈도 우선 재배열 (패치만)     (8, 36, 96)    (B·4 윈도, 6·6 토큰)
    윈도마다 CLS 를 붙인 뒤       (8, 37, 96)    ← 윈도 블록의 입력
    전역 블록 안에서의 view       (2, 148, 96)   (4·37 토큰: CLS 4개 포함)
    꺼낸 특징 맵 3개              각각 (2, 96, 12, 12)
- 패치 임베딩. 8×8 합성곱(스트라이드 8)으로 12×12 = 144개의 패치 토큰을 만들고, 앞에 CLS 토큰을 붙이고, 학습되는 위치 임베딩을 더한다.
(2, 145, 96). - 윈도 우선 재배열. 패치 토큰 144개만
to_window_major로 다시 늘어놓는다. 윈도 4개가 배치 축으로 올라가(8, 36, 96). - CLS 토큰 복제. 위치 임베딩까지 더한 CLS 토큰을 윈도마다 한 벌씩 복제해 앞에 붙인다. 윈도 하나가 1 + 36 = 37 토큰,
(8, 37, 96). 이것이 윈도 블록의 입력이다. - 전역 블록.
view로 윈도 4개를 한 줄로 붙이면 4 × 37 = 148 토큰이다. 패치 토큰 144개에 CLS 토큰이 4개 섞여 있고, 전역 어텐션에서는 이 CLS 토큰 4개도 서로를 본다. - 특징 맵 꺼내기. 정해진 층마다 층 정규화를 하고, CLS 토큰을 떼고,
from_window_major로 행 우선으로 되돌려(2, 96, 12, 12)로 접는다. 순서를 되돌리는 일은 꺼낼 때만 한다.
CLS 토큰 때문에 어텐션의 쌍이 앞의 계산보다 조금 늘어난다. 윈도 블록은 \(4 \times 37^2 = 5{,}476\) 쌍(패치만이면 5,184), 전역 블록은 \(148^2 = 21{,}904\) 쌍(패치만이면 20,736)이다. 윈도가 많을수록 복제되는 CLS 토큰도 많아진다는 점을 기억해 두라. 10장에서 RF-DETR 이 윈도 수를 고르는 이야기에 다시 나온다.
이 인코더는 가중치를 그대로 둔 채 입력 해상도, 패치 크기, 윈도 수 를 호출할 때마다 바꿀 수 있게 만들었다. 12장의 NAS 가 이 손잡이들을 돌린다.
  손잡이 (가중치는 그대로, 호출 인자만 바꿈)
    해상도  96, 패치  8, 윈도 2×2 → 특징 맵 (1, 96, 12, 12)
    해상도  96, 패치  8, 윈도 1×1 → 특징 맵 (1, 96, 12, 12)
    해상도  96, 패치  8, 윈도 3×3 → 특징 맵 (1, 96, 12, 12)
    해상도  64, 패치  8, 윈도 2×2 → 특징 맵 (1, 96, 8, 8) (위치 임베딩 보간)
    해상도 128, 패치  8, 윈도 2×2 → 특징 맵 (1, 96, 16, 16) (위치 임베딩 보간)
    해상도  96, 패치 12, 윈도 2×2 → 특징 맵 (1, 96, 8, 8) (위치 임베딩 보간) (패치 임베딩 보간)
    해상도  96, 패치  6, 윈도 2×2 → 특징 맵 (1, 96, 16, 16) (위치 임베딩 보간) (패치 임베딩 보간)
    해상도  96, 패치 16, 윈도 1×1 → 특징 맵 (1, 96, 6, 6) (위치 임베딩 보간) (패치 임베딩 보간)
윈도 수는 어텐션을 묶는 방식만 바꾸므로 매개변수가 전혀 달라지지 않는다(위의 세 줄). 해상도나 패치 크기를 바꾸면 격자 크기가 달라지므로 위치 임베딩을 보간한다(6장). 제약은 둘이다. 그림의 한 변이 패치 크기의 배수여야 하고, 격자의 한 변이 윈도 수의 배수여야 한다. 12×12 격자라면 한 변의 윈도 수는 1, 2, 3, 4, 6 이 가능하다.
def resize_patch_embed_simple(weight: torch.Tensor, new_patch: int) -> torch.Tensor:
    """패치 임베딩 합성곱의 가중치를 다른 패치 크기로 바꾸는 가장 단순한 방법: 가중치를 그림처럼 보간한다.

    weight: (C, 3, p, p) → (C, 3, p', p').  쌍삼차 보간 뒤 (p/p')² 를 곱해, 밋밋한 패치에 대한 응답 크기를 맞춘다
    (가중치의 합이 p'²/p² 배로 늘어나는 것을 되돌린다).
    FlexiViT 는 이보다 나은 변환(보간의 유사 역행렬)을 쓴다 — 12장에서 WindowedViT.patch_resize_fn 에 끼워 넣는다.
    """
    old_patch = weight.shape[-1]
    if new_patch == old_patch:
        return weight
    resized = F.interpolate(weight, size=(new_patch, new_patch), mode="bicubic", align_corners=False, antialias=True)
    return resized * (old_patch / new_patch) ** 2
- 이 출력이 말하는 것과 말하지 않는 것
- 위 표는 모양이 맞게 돌아간다 는 것만 보인다. 학습하지 않은 모델이고, 설정을 바꿨을 때의 정확도는 재지 않았다. 특히 패치 크기를 바꾸는
resize_patch_embed_simple은 패치 임베딩의 가중치를 그림처럼 보간하는 가장 단순한 방법이다. RF-DETR 논문이 쓴다고 적은 FlexiViT 식 변환이 아니다. 그 변환과 정확도의 비교는 12장의 몫이다.
프로젝터 코드
프로젝터의 부품은 넷이다. 채널 축을 정규화하는 ChannelLayerNorm, "합성곱 → 정규화 → 활성 함수" 묶음 ConvX, 3×3 ConvX 두 번인 Bottleneck, 그리고 C2f 이다. C2f.forward 의 세 줄이 그림 9-5 그대로이다. cv1 의 출력을 split 으로 둘로 나누고, 목록의 마지막 원소를 병목에 넣어 그 결과를 목록에 덧붙이기를 되풀이하고, 목록 전체를 cat 으로 이어 cv2 에 넣는다.
class ChannelLayerNorm(nn.Module):
    """(B, C, H, W) 특징 맵용 층 정규화: 칸마다 채널 C 개에 걸쳐 평균 0 · 분산 1 로 맞춘다.

    nn.LayerNorm 은 마지막 축을 정규화하므로, 채널 축을 맨 뒤로 보냈다가 되돌린다.
    배치 정규화와 달리 배치의 다른 그림을 보지 않는다 → 배치가 작아도 (기울기 누적을 써도) 동작이 같다.
    """

    def __init__(self, channels: int, eps: float = 1e-6):
        super().__init__()
        self.weight = nn.Parameter(torch.ones(channels))
        self.bias = nn.Parameter(torch.zeros(channels))
        self.eps = eps

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = F.layer_norm(x.permute(0, 2, 3, 1), self.weight.shape, self.weight, self.bias, self.eps)
        return x.permute(0, 3, 1, 2)

class ConvX(nn.Module):
    """합성곱(편향 없음) → 정규화 → 활성 함수. layer_norm=True 면 층 정규화(RF-DETR), False 면 배치 정규화(LW-DETR)."""

    def __init__(self, cin: int, cout: int, kernel: int = 3, stride: int = 1, act: str = "relu",
                 layer_norm: bool = True):
        super().__init__()
        self.conv = nn.Conv2d(cin, cout, kernel, stride, padding=kernel // 2, bias=False)
        self.bn = ChannelLayerNorm(cout) if layer_norm else nn.BatchNorm2d(cout)  # 이름은 공식 구현을 따라 bn
        self.act = nn.SiLU() if act == "silu" else nn.ReLU()

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.act(self.bn(self.conv(x)))

class Bottleneck(nn.Module):
    """3×3 ConvX 두 번. shortcut=True 이고 채널 수가 같으면 입력을 더한다 (C2f 안에서는 기본이 False)."""

    def __init__(self, c1: int, c2: int, shortcut: bool = True, e: float = 0.5, act: str = "silu",
                 layer_norm: bool = True):
        super().__init__()
        hidden = int(c2 * e)
        self.cv1 = ConvX(c1, hidden, 3, act=act, layer_norm=layer_norm)
        self.cv2 = ConvX(hidden, c2, 3, act=act, layer_norm=layer_norm)
        self.add = shortcut and c1 == c2

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return x + self.cv2(self.cv1(x)) if self.add else self.cv2(self.cv1(x))

class C2f(nn.Module):
    """C2f 블록 (YOLOv8). 입력 (B, c1, H, W) → 출력 (B, c2, H, W), 해상도는 그대로.

    1) 1×1 ConvX 로 2c 채널 (c = c2/2) → 반씩 둘로 나눈다: y₀, y₁
    2) 병목 n 개를 차례로: y₂ = m₁(y₁), y₃ = m₂(y₂), …
    3) y₀ … y_{n+1} 을 모두 채널 방향으로 이어 붙여 ((2 + n)·c 채널) 1×1 ConvX 로 c2 채널
    중간 결과를 전부 마지막에 모으므로, 얕은 경로와 깊은 경로의 특징이 함께 쓰인다.
    """

    def __init__(self, c1: int, c2: int, n: int = 1, shortcut: bool = False, e: float = 0.5, act: str = "silu",
                 layer_norm: bool = True):
        super().__init__()
        self.c = int(c2 * e)
        self.cv1 = ConvX(c1, 2 * self.c, 1, act=act, layer_norm=layer_norm)
        self.cv2 = ConvX((2 + n) * self.c, c2, 1, act=act, layer_norm=layer_norm)
        self.m = nn.ModuleList(Bottleneck(self.c, self.c, shortcut, e=1.0, act=act, layer_norm=layer_norm)
                               for _ in range(n))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        y = list(self.cv1(x).split((self.c, self.c), dim=1))
        y.extend(m(y[-1]) for m in self.m)
        return self.cv2(torch.cat(y, dim=1))
MultiScaleProjector 는 배율마다 "(입력마다 크기 조절) → 채널로 이어 붙이기 → C2f → 층 정규화" 를 한 단계씩 만든다. 입력이 여러 층의 특징 맵 목록이라는 점이 다층 특징 집계의 구현이다. forward 의 torch.cat([...], dim=1) 한 줄이 그것이다.
SCALE_FACTORS = {"P3": 2.0, "P4": 1.0, "P5": 0.5}  # ViT 특징 맵(P4) 기준의 배율

class MultiScaleProjector(nn.Module):
    """ViT 의 여러 층 특징 맵을 받아 디코더가 읽을 특징 맵(들)을 만든다 (공식 projector.py 와 같은 구조).

    입력: 목록 [(B, C_j, h, w), …] — 모두 같은 해상도 (ViT 는 층이 달라도 해상도가 같다).
    scale_factors 의 배율마다 한 단계(stage)씩:
      배율 2.0 (P3): 입력마다 전치 합성곱(2×2, 스트라이드 2)으로 2배 키우고 채널은 절반
      배율 1.0 (P4): 그대로
      배율 0.5 (P5): 입력마다 3×3 스트라이드 2 ConvX 로 절반
      → 입력들을 채널 방향으로 이어 붙임 → C2f(num_blocks) → 층 정규화
    돌려주는 값: 목록 [(B, out_channels, h·배율, w·배율), …]  (배율 순서대로).
    RF-DETR 의 기본은 P4 한 단계뿐이다 (단일 스케일).
    """

    def __init__(self, in_channels, out_channels: int, scale_factors=(1.0,), num_blocks: int = 3,
                 layer_norm: bool = True):
        super().__init__()
        self.scale_factors = list(scale_factors)
        sampling, stages = [], []
        for scale in self.scale_factors:
            layers = []
            for cin in in_channels:
                if scale == 2.0:
                    layers.append(nn.Sequential(nn.ConvTranspose2d(cin, cin // 2, kernel_size=2, stride=2)))
                elif scale == 1.0:
                    layers.append(nn.Sequential())
                elif scale == 0.5:
                    layers.append(nn.Sequential(ConvX(cin, cin, 3, 2, layer_norm=layer_norm)))
                else:
                    raise NotImplementedError(f"지원하지 않는 배율: {scale}")
            sampling.append(nn.ModuleList(layers))
            fused = sum(cin // 2 if scale == 2.0 else cin for cin in in_channels)
            stages.append(nn.Sequential(C2f(fused, out_channels, num_blocks, layer_norm=layer_norm),
                                        ChannelLayerNorm(out_channels)))
        self.stages_sampling = nn.ModuleList(sampling)
        self.stages = nn.ModuleList(stages)

    def forward(self, features):
        results = []
        for sampling, stage in zip(self.stages_sampling, self.stages):
            fused = torch.cat([layer(x) for layer, x in zip(sampling, features)], dim=1)  # 여러 층을 채널로 잇는다
            results.append(stage(fused))
        return results
묶음별 매칭 코드
GroupHungarianMatcher 는 7장의 HungarianMatcher(8장의 포컬 꼴 분류 비용)를 물려받아 두 군데만 바꾼다. assign_groups 가 비용 행렬을 묶음별로 잘라 헝가리안 풀이를 따로 하고, cost_parts 가 L1 비용을 torch.cdist 대신 뺄셈으로 계산한다(값은 같고, 학습 스텝마다 불리는 작은 행렬에서 더 빠르다). 매칭 비용의 가중치는 RF-DETR 의 기본값인 분류 2, L1 5, GIoU 2 이다. 11장의 학습이 이 클래스를 쓴다.
class GroupHungarianMatcher(HungarianMatcher):
    """묶음마다 따로 하는 헝가리안 매칭. 7장 HungarianMatcher (포컬 꼴 비용) 에 묶음 나누기만 더했다.

    예측 G·N 개를 N 개씩 G 묶음으로 나누고, 묶음마다 그림의 정답 전체와 일대일 매칭을 푼다.
    → 정답 하나가 묶음마다 한 번씩, 모두 G 번 짝을 얻는다 (학습 신호가 G 배). 추론 때는 묶음이 하나뿐이다.
    """

    def __init__(self, cost_class: float = 2.0, cost_bbox: float = 5.0, cost_giou: float = 2.0):
        super().__init__(cost_class, cost_bbox, cost_giou, class_cost="focal")

    @torch.no_grad()
    def cost_parts(self, logits, boxes, tgt_labels, tgt_boxes):
        """7장과 같은 세 비용 (포컬 꼴 분류 비용, L1, −GIoU), 각각 (Q, T). L1 만 torch.cdist 대신 뺄셈으로 계산한다

        (값은 같고, 이렇게 작은 행렬에서는 GPU 에서 훨씬 빠르다 — 학습 스텝마다 불리므로 차이가 쌓인다).
        """
        prob = logits.sigmoid()[:, tgt_labels]  # (Q, T): 열 j 는 정답 j 의 클래스에 준 확률
        alpha, gamma = self.focal_alpha, self.focal_gamma
        c_cls = (alpha * (1 - prob) ** gamma * (-(prob + 1e-8).log())
                 - (1 - alpha) * prob**gamma * (-(1 - prob + 1e-8).log()))
        c_l1 = (boxes[:, None] - tgt_boxes[None]).abs().sum(-1)
        c_giou = -generalized_box_iou(box_cxcywh_to_xyxy(boxes), box_cxcywh_to_xyxy(tgt_boxes))
        return c_cls, c_l1, c_giou

    @staticmethod
    def assign_groups(cost: np.ndarray, group_detr: int):
        """그림 한 장의 비용 행렬 (G·N, T) 을 묶음별로 잘라 각각 헝가리안 풀이를 한다.

        돌려주는 값: (예측 번호 (G·T,), 정답 번호 (G·T,)) — 예측 번호는 0 … G·N−1.
        """
        per_group = cost.shape[0] // group_detr
        rows, cols = [], []
        for g in range(group_detr):
            r, c = linear_sum_assignment(cost[g * per_group:(g + 1) * per_group])  # 묶음 g 안에서만 푼다
            rows.append(r + g * per_group)
            cols.append(c)
        return np.concatenate(rows), np.concatenate(cols)

    @torch.no_grad()
    def forward(self, outputs, targets, group_detr: int = 1):
        """outputs: {"pred_logits": (B, G·N, K), "pred_boxes": (B, G·N, 4)}.

        돌려주는 값: 길이 B 의 목록. b 번째는 (pred_idx, tgt_idx) — 길이 G·T_b. pred_idx 는 0 … G·N−1 의 번호.
        """
        batch, total = outputs["pred_logits"].shape[:2]
        sizes = [len(t["labels"]) for t in targets]
        cost = self.cost_matrix(
            outputs["pred_logits"].flatten(0, 1), outputs["pred_boxes"].flatten(0, 1),
            torch.cat([t["labels"] for t in targets]), torch.cat([t["boxes"] for t in targets]),
        ).view(batch, total, -1).cpu().numpy()  # (B, G·N, ΣT)
        offsets = np.cumsum([0] + sizes)
        indices = []
        for b in range(batch):  # block: (G·N, T_b) — 이 그림의 예측 × 이 그림의 정답
            rows, cols = self.assign_groups(cost[b, :, offsets[b]:offsets[b + 1]], group_detr)
            indices.append((torch.as_tensor(rows, dtype=torch.long), torch.as_tensor(cols, dtype=torch.long)))
        return indices
- 공식 구현과의 대조
- 이 장의 부품은 설치된
rfdetr패키지(1.12.1)의 해당 모듈과 같은 입력 · 같은 가중치로 값을 대조해 두었다(대조용 스크립트는 실습 파일에 들어 있지 않다). 윈도 ViT 인코더의 특징 맵,compute_window_block_indexes의 결과, 묶음별 매칭의 배정은 공식 구현과 일치했고, 프로젝터의 출력은 최대 차이 \(10^{-5}\), IA-BCE 의 손실값은 6.831939 로 같았다. 패치 크기를 바꾸는 경로는 공식 구현에 대응하는 것이 없어 대조하지 못했다. 또 LW-DETR 의 공식 저장소는 열어 보지 못했고, "LW-DETR 과 같다" 는 설명은 논문과 그것을 물려받은 RF-DETR 의 코드로 확인한 것이다.
LW-DETR 에서 RF-DETR 로
RF-DETR 논문은 자기 구조를 "LW-DETR 을 현대화한 것" 이라고 소개한다. 이 장에서 익힌 부품의 대부분이 그대로 넘어가고, 몇 군데가 바뀐다. 10장으로 가기 전에 지도를 그려 둔다.
| 부품 | LW-DETR | RF-DETR | 다루는 곳 |
| 뼈대 | ViT 인코더 → 프로젝터 → 변형 교차 어텐션 디코더 | 그대로 | 10장 |
| 백본 | CAEv2 로 사전 학습한 ViT(10층, CLS 토큰 없음) | DINOv2(12층, CLS 토큰 있음 → 윈도마다 복제) | 6장, 10장 |
| 윈도 · 전역 어텐션, 윈도 우선 배치 | 윈도 16개(한 변 4) | 그대로 쓰되 윈도 수가 손잡이가 됨(대개 한 변 2) | 10장, 12장 |
| 다층 특징 집계 · C2f 프로젝터 | 배치 정규화 | 층 정규화 | 4장, 이 장 |
| 디코더 | 3층 고정 | 모든 층에 손실을 걸고 추론 때 층을 떼어 낼 수 있음 | 10장, 12장 |
| 섞은 질의 선택 | 사용 | 그대로 | 8장, 10장 |
| IA-BCE · Group DETR(13묶음) · 박스 재매개변수화 | 사용 | 그대로(공개 코드의 기본값) | 이 장, 11장 |
| Objects365 사전 학습 | 사용 | 사용(백본은 DINOv2 에서 출발) | 11장 |
| 모델 크기를 정하는 방법 | 사람이 정한 다섯 크기 | 가중치 공유 NAS 로 탐색 | 12장 |
| 인스턴스 분할 | 없음 | 가벼운 분할 머리 추가 | 13장 |
바뀌는 것들은 한 방향을 가리킨다. LW-DETR 은 COCO 에서 YOLO 를 앞서는 실시간 DETR 을 만들었고, RF-DETR 은 그 구조를 사전 학습된 큰 백본 과 재학습 없이 돌릴 수 있는 손잡이 쪽으로 밀고 간다. RF-DETR 논문 표 5 의 절제는 LW-DETR(M)의 52.6 AP 에서 출발해 DINOv2 백본, 추가 사전 학습, NAS 를 거쳐 54.6 AP 에 이른다. 층 정규화로의 교체, CLS 토큰의 복제, 디코더 층을 떼어 내는 설계가 모두 그 길에 필요한 손질이다.
정리
- 실시간의 두 길. RT-DETR 은 CNN 백본 뒤의 인코더를 가볍게 다시 짰고(가장 거친 특징 맵에만 어텐션, 해상도 사이의 융합은 합성곱), LW-DETR 은 평범한 ViT 를 인코더로 삼았다. 둘 다 NMS 가 없어 신경망 시간이 곧 전체 시간이다.
- LW-DETR 의 구조. ViT 인코더(윈도 · 전역 어텐션을 번갈아, 여러 층의 특징 맵을 모음) → C2f 프로젝터 → 3층 디코더(변형 교차 어텐션) + 섞은 질의 선택. 디코더를 6층에서 3층으로 줄여 1.4 → 0.7 ms.
- 윈도 어텐션. 윈도를 배치 축에 올리면 보통의 자기 어텐션이 윈도 어텐션이 된다. 쌍의 수는 \(N^2\) 에서 \(N^2 / W_n^2\) 로 줄지만, 줄어드는 것은 제곱 항뿐이라 토큰이 적으면 속도 이득이 없다. 전역 블록이 없으면 윈도 사이로 정보가 전혀 흐르지 않는다.
- 윈도 우선 배치. 토큰을 윈도 단위로 늘어놓으면 윈도 블록도 전역 블록도
view만으로 된다. 논문은 이것으로 3.9 → 2.9 ms 를 보고했고, 이 튜토리얼의 PyTorch 측정에서는 차이가 재지지 않았다. - C2f. 1×1 합성곱 → 둘로 나눔 → 병목(3×3 두 번)을 차례로 → 중간 결과를 전부 이어 붙여 1×1 합성곱. 입력 288 · 출력 128 · 병목 3개일 때 300,544개.
- IA-BCE. 양성 칸의 목표를 \(t = p^{0.25} u^{0.75}\) 로 둔 BCE, 음성 칸은 \(p^2\) 을 곱한 BCE. 양성 칸의 기울기 \(p - t\) 가 0 이 되는 곳이 \(p = u\) 이므로 점수가 IoU 로 끌려간다.
- Group DETR. 질의 묶음 \(G\) 개가 디코더를 공유하고 묶음마다 따로 일대일 매칭을 해서 양성이 \(G\) 배가 된다. 묶음끼리는 자기 어텐션에서 서로 보지 않고, 추론은 첫 묶음만 쓰므로 추론 비용이 늘지 않는다.
- 박스 재매개변수화. \(\hat{x} = \delta_x w_r + x_r\), \(\hat{w} = e^{\delta_w} w_r\). 변화량이 기준 박스의 크기를 단위로 한 값이라 박스 크기와 무관하게 같은 뜻이고, \(\delta = 0\) 이면 기준 박스 그대로이다.
- 논문의 절제. LW-DETR 표 2 에서 가장 큰 계단은 Objects365 사전 학습(+8.7)과 Group DETR(+3.0)이다. 속도를 바꾸는 것은 윈도 어텐션과 윈도 우선 배치뿐이고, 나머지는 추론 비용이 없는 학습 기법이다.
DETR 계열을 실시간으로 만든 재료가 모였다. 인코더에는 윈도 어텐션과 윈도 우선 배치, 인코더와 디코더 사이에는 여러 층의 특징을 섞는 C2f 프로젝터, 학습에는 IA-BCE 와 Group DETR 과 박스 재매개변수화가 있다. 이 장에서는 부품을 하나씩 따로 만들고 따로 확인했다. 10장에서는 이것들을 8장의 변형 어텐션 디코더와 이어 붙여 RF-DETR 한 대를 조립한다. LW-DETR 에서 달라지는 곳, 곧 DINOv2 백본과 윈도마다 복제되는 CLS 토큰, 2단계 질의 선택의 실제 코드, 층마다 기준 박스를 갈지 않는 가벼운 정제, 그리고 재학습 없이 돌리는 손잡이들을 그 자리에서 본다.
확인 문제
- 1. 윈도 어텐션의 쌍 세기 — RF-DETR Nano 는 384×384 그림을 16×16 패치로 자르고, 한 변을 2등분해 윈도를 만든다. CLS 토큰은 빼고 답하라. (가) 토큰 수 \(N\) 과 전역 어텐션 한 번의 쌍의 수는? (나) 윈도 하나의 토큰 수와 윈도 어텐션 한 번의 쌍의 수는? (다) 블록 12개 가운데 3개가 전역, 9개가 윈도라면, 모두 전역일 때와 견주어 인코더 전체의 어텐션 쌍은 몇 배인가?
- (가) 한 변에 \(384 / 16 = 24\) 개이므로 \(N = 24^2 = 576\). 전역 어텐션의 쌍은 \(576^2 = 331{,}776\).
- (나) 윈도는 \(2 \times 2 = 4\) 개, 윈도 하나에 \(576 / 4 = 144\) 토큰(12×12). 쌍은 \(4 \times 144^2 = 4 \times 20{,}736 = 82{,}944\). 식 \(N^2 / W_n^2 = 331{,}776 / 4\) 와 같다.
- (다) \((3 \times 1 + 9 \times \tfrac{1}{4}) / 12 = 5.25 / 12 = 0.4375\) 배. 윈도 9층을 다 합쳐도 전역 2.25층 분량이다. 어텐션의 쌍만 센 값이고, 선형 층과 MLP 는 줄지 않으므로 블록 전체의 계산량은 이보다 덜 줄어든다.
- 2. 윈도 우선 자리 — 본문의 4×4 격자 · 윈도 2×2 예에서, (가) 윈도 우선 배치의 자리 \(k = 13\) 에 놓이는 칸은 무엇인가? (나) 칸 \(f_{23}\) 은 윈도 우선 배치에서 몇 번째 자리에 놓이는가? 식 \(k = 8a + 4b + 2i + j\) 와 행 우선 번호 \(8a + 4i + 2b + j\) 를 쓰라.
- (가) \(13 = 8 \cdot 1 + 4 \cdot 1 + 2 \cdot 0 + 1\) 이므로 \((a, b, i, j) = (1, 1, 0, 1)\). 행 우선 번호는 \(8 \cdot 1 + 4 \cdot 0 + 2 \cdot 1 + 1 = 11\), 곧 \(r = 2\), \(c = 3\) 이라 \(f_{34}\) 이다. 본문 출력의 목록에서 자리 13 의 값이 11 인 것과 맞는다.
- (나) \(f_{23}\) 은 \(r = 1\), \(c = 2\) 이므로 \(a = 0, i = 1, b = 1, j = 0\). 윈도 우선 자리는 \(k = 8 \cdot 0 + 4 \cdot 1 + 2 \cdot 1 + 0 = 6\) 이다. 행 우선 번호도 \(4 \cdot 1 + 2 = 6\) 이라, 이 칸은 두 배치에서 자리가 같다. 오른쪽 위 윈도의 셋째 칸이다.
- 3. 줄어든 연산량, 줄지 않은 시간 — 이 장의 측정에서 12×12 격자는 윈도 어텐션으로 쌍의 수가 4분의 1 이 되었는데도 시간이 1.01 ms 에서 0.97 ms 로 거의 그대로였다. 48×48 격자에서는 0.59배가 되었다. 6장의 어림식 \(12ND^2 + 2N^2D\) 로 이 차이를 설명하라(\(D = 96\)). 그리고 LW-DETR 논문에서 연산량이 줄었는데 지연이 늘어난 까닭으로 논문이 든 것은 무엇인가?
- 윈도 어텐션이 줄이는 것은 제곱 항 \(2N^2D\) 뿐이다. 두 항의 비는 \(N / 6D\) 로, 12×12 격자(\(N = 144\))에서는 \(144 / 576 = 0.25\) 이다. 블록 계산의 \(0.25 / 1.25 = 20\%\) 만 어텐션 쌍의 몫이라, 그것을 4분의 1 로 줄여도 블록 하나는 15% 줄 뿐이고, 블록 6개 가운데 4개만 윈도이므로 전체는 10% 준다. 이만큼 작은 계산에서는 그 10% 도 호출 비용에 묻힌다.
- 48×48 격자(\(N = 2304\))에서는 \(N / 6D = 4\) 로 어텐션 쌍이 블록의 80% 이다. 윈도 블록은 \((1 + 1)/(1 + 4) = 0.4\) 배가 되고, 전체는 \((2 \times 5 + 4 \times 2) / (6 \times 5) = 0.60\) 배이다. 잰 값 0.59 와 맞는다.
- 논문이 든 까닭은 행 우선 배치에서 윈도 블록마다 필요한 순서 바꾸기(메모리에서 값을 옮기는 일)이다. 연산량(FLOPs)은 곱셈과 덧셈만 세므로 이런 비용이 드러나지 않는다. 윈도 우선 배치가 그 순서 바꾸기를 없앤다.
- 4. C2f 의 채널과 매개변수 — 입력 192 채널, 출력 64 채널, 병목 2개인 C2f 블록이 있다(정규화는 층 정규화, 합성곱에 편향 없음). (가) \(c\) 와, 마지막 1×1 합성곱에 들어가는 채널 수는? (나) C2f 블록의 매개변수 수는?
- (가) \(c = 64 / 2 = 32\). 이어 붙이는 갈래는 \(y_0, y_1, y_2, y_3\) 의 넷이므로 \((2 + 2) \times 32 = 128\) 채널이다.
- (나) cv1: \(192 \times 64 + 2 \times 64 = 12{,}288 + 128 = 12{,}416\). 3×3 ConvX 하나: \(32 \times 32 \times 9 + 2 \times 32 = 9{,}216 + 64 = 9{,}280\), 병목 2개에 넷이 있으므로 \(37{,}120\). cv2: \(128 \times 64 + 2 \times 64 = 8{,}192 + 128 = 8{,}320\). 합은 \(12{,}416 + 37{,}120 + 8{,}320 = 57{,}856\) 개이다.
- 5. IA-BCE 손계산 — 정답과 짝지어진 예측의 점수가 \(p = 0.70\), 박스의 IoU 가 \(u = 0.60\) 이다(\(\alpha = 0.25\)). \(0.70^{0.25} = 0.9147\), \(0.60^{0.75} = 0.6817\), \(\log 0.7 = -0.3567\), \(\log 0.3 = -1.2040\) 을 쓰라. (가) 목표 \(t\) 는? (나) 이 칸의 손실은? (다) 로짓에 대한 기울기와 그 뜻은? (라) 보통의 BCE(목표 1)였다면 손실과 기울기는?
- (가) \(t = 0.9147 \times 0.6817 = 0.6236\). \(u = 0.60\) 과 \(p = 0.70\) 사이에 있다.
- (나) \(-0.6236 \times (-0.3567) - 0.3764 \times (-1.2040) = 0.2224 + 0.4532 = 0.6756\).
- (다) \(p - t = 0.70 - 0.6236 = +0.0764\). 양수이므로 경사 하강법이 로짓을 낮춘다. 점수가 IoU 보다 높으니 내리라는 신호이다.
- (라) 손실 \(-\log 0.7 = 0.3567\), 기울기 \(0.70 - 1 = -0.30\). 박스가 얼마나 맞았는지와 상관없이 점수를 더 올리라는 신호이다.
- 6. 지수 α 와 고정점 — (가) \(\alpha\) 를 0.25 에서 0.5 로 바꾸면 양성 칸의 고정점은 어디로 옮겨 가는가? (나) \(\alpha = 1\) 이면 어떻게 되는가? (다) \(\alpha = 0\) 이면 IA-BCE 의 양성 항은 4장의 무엇과 같아지는가?
- (가) 옮겨 가지 않는다. 유도에서 \(p = p^{\alpha} u^{1-\alpha} \Leftrightarrow p^{1-\alpha} = u^{1-\alpha} \Leftrightarrow p = u\) 는 \(0 \le \alpha \lt 1\) 인 어떤 \(\alpha\) 에서도 성립한다. 달라지는 것은 고정점까지 끌려가는 세기이다. \(\alpha\) 가 클수록 목표가 지금의 점수에 가까워 기울기 \(p - t\) 가 작아진다. 예: \(p = 0.2\), \(u = 0.9\) 에서 \(\alpha = 0.25\) 이면 \(t = 0.618\), \(\alpha = 0.5\) 이면 \(t = \sqrt{0.2 \times 0.9} = 0.424\).
- (나) \(t = p\) 가 되어 기울기 \(p - t\) 가 언제나 0 이다. 모든 점수가 고정점이라 양성 칸에서 아무것도 배우지 못한다.
- (다) \(t = u\) 가 되므로, 목표가 IoU 로 고정된 부드러운 목표 BCE 이다. 최솟점은 \(p = u\) 로 같다.
- 7. Group DETR 의 수 세기 — 질의 300개짜리 묶음 13개로 학습한다. 어떤 그림에 정답이 7개 있다. (가) 이 그림에서 양성(정답과 짝지어진 예측)은 몇 개인가? Group DETR 없이는? (나) 분류 손실을 나누는 수는? (다) 추론 때 디코더에 들어가는 질의는 몇 개인가? (라) 자기 어텐션에서 묶음끼리 서로 보게 두면 무엇이 어긋나는가?
- (가) 묶음마다 7개씩 \(13 \times 7 = 91\) 개. Group DETR 없이는 7개이다.
- (나) 정답 수 × 묶음 수 = 91 이다. 그래서 손실의 크기가 묶음 수와 무관하게 유지된다.
- (다) 첫 묶음의 300개이다. 계산은 Group DETR 을 쓰지 않은 모델과 같다.
- (라) 두 가지이다. 같은 정답을 맡은 다른 묶음의 질의는 둘 다 양성이어야 하는데, 자기 어텐션은 "다른 질의가 맡은 객체면 점수를 낮춘다" 를 배우는 통로라 요구가 부딪친다. 그리고 추론 때는 첫 묶음뿐이므로, 학습 때 다른 묶음을 보며 한 계산을 추론 때 되풀이할 수 없다. 묶음끼리 보지 않으면 첫 묶음의 출력이 다른 묶음과 무관하다(본문의 check, 차이 0).
- 8. 박스 재매개변수화 손계산 — 기준 박스가 \((x_r, y_r, w_r, h_r) = (0.40,\ 0.50,\ 0.20,\ 0.10)\) 이다. \(e^{0.5} = 1.6487\), \(e^{-0.5} = 0.6065\), \(\log 1.5 = 0.4055\) 를 쓰라. (가) 머리가 \(\delta = (0.3,\ -0.5,\ 0.5,\ -0.5)\) 를 냈을 때의 예측 박스는? (나) 정답 박스가 \((0.46,\ 0.50,\ 0.30,\ 0.10)\) 이면 머리가 내야 하는 \(\delta\) 는? (다) 기준 박스와 정답 박스를 모두 절반 크기로 줄이면(좌표와 크기에 0.5 를 곱하면) (나)의 답이 어떻게 되는가?
- (가) \(\hat{x} = 0.3 \times 0.20 + 0.40 = 0.46\), \(\hat{y} = -0.5 \times 0.10 + 0.50 = 0.45\), \(\hat{w} = 1.6487 \times 0.20 = 0.3297\), \(\hat{h} = 0.6065 \times 0.10 = 0.0607\). 예측 박스는 \((0.46,\ 0.45,\ 0.3297,\ 0.0607)\).
- (나) \(\delta_x = (0.46 - 0.40) / 0.20 = 0.3\), \(\delta_y = (0.50 - 0.50) / 0.10 = 0\), \(\delta_w = \log(0.30 / 0.20) = \log 1.5 = 0.4055\), \(\delta_h = \log(0.10 / 0.10) = 0\).
- (다) 그대로이다. \(\delta_x = (0.23 - 0.20) / 0.10 = 0.3\), \(\delta_w = \log(0.15 / 0.10) = 0.4055\). 분자와 분모가 함께 절반이 되어 약분된다. 변화량이 기준 박스의 크기를 단위로 잰 값이기 때문이다.
See also
Favorite site
- 09. 실시간 DETR: RT-DETR 과 LW-DETR
- ch09_lwdetr_parts.py - 이 장의 실습 코드
- DETRs Beat YOLOs on Real-time Object Detection (RT-DETR, Zhao 외)
- LW-DETR: A Transformer Replacement to YOLO for Real-Time Detection (Chen 외, 2024)
- Align-DETR: Improving DETR with Simple IoU-aware BCE loss (첫 판)
- Group DETR: Fast DETR Training with Group-Wise One-to-Many Assignment
- Exploring Plain Vision Transformer Backbones for Object Detection (ViTDet)