RF-DETR:Tutorial:14-Practice
lastmod 2026-11-18created 2026-11-187 edits
실전: rfdetr 패키지는 RF-DETR 튜토리얼의 14장이다. 13장까지 손으로 만든 미니 모델을 내려놓고, Roboflow 가 공개한 진짜 RF-DETR, 곧 rfdetr 패키지로 사전 학습 모델을 추론하고, 도형 세상을 COCO 형식으로 내보내 RF-DETR Nano 를 미세 조정하고, 3장의 채점기와 맞대어 평가하고, ONNX 로 내보내 지연 시간을 잰다. 설치와 모델 가족 · 라이선스, predict() 의 전처리 · 후처리, 학습 인자와 로그 읽기, 체크포인트, 지연 시간을 바르게 재는 법까지 다루며, 단계마다 앞 장에서 만든 부품(박스 변환, AP, 헝가리안 매칭, 윈도 어텐션, IA-BCE, EMA, 2단계 질의 선택)이 패키지 안에서 어떻게 돌고 있는지 짚는다. 튜토리얼 본문의 마지막 장이며, 15장 부록이 뒤따른다.
- 원문: 14. 실전: rfdetr 패키지
- 실습 코드:
code/ch14_make_coco.py(도형 세상을 COCO 형식 폴더로 내보내기, CPU 약 15초),code/ch14_finetune.py(사전 학습 모델 추론 → 미세 조정 2회 → 평가 → 추론 설정 바꿔 보기, GPU 약 30분),code/ch14_export.py(ONNX 내보내기 → onnxruntime 추론 → 지연 시간 재기, GPU + CPU 약 5분). 이 장의 코드만은 rfdetr · supervision · pillow · onnx · onnxruntime 을 쓴다. - 이전: 13. RF-DETR-Seg: 인스턴스 분할 / 다음: 15. 부록: 디버깅 · 용어집 · 다음 걸음
- 이 장이 확인한 판(버전)
- 이 장의 모든 API · 인자 이름 · 기본값 · 출력은
rfdetr1.12.1(2026년 11월 기준 설치판; torch 2.15.0, supervision 0.31.7, onnx 1.23.2, onnxruntime 1.32.0)에서 실제로 돌려 확인한 것 이다. 패키지는 빠르게 바뀌므로(예를 들어 예전 글에 자주 나오는optimize_for_inference()는 이 판에 없다) 다른 판을 쓴다면 이름이 조금 다를 수 있다. 돌려 보지 못하고 공식 문서 · 소스의 설명만 옮긴 곳은 “문서에 따르면” 이라고 따로 밝혔다.
원리에서 도구로
앞 장들의 미니 구현은 원리를 보이려고 일부러 작게 만든 것이다. 96×96 그림, 수십만 개의 매개변수, 몇 분의 학습. 진짜 RF-DETR Nano 는 매개변수가 약 3,050만 개이고, DINOv2 로 사전 학습된 백본 위에서 Objects365 와 COCO 로 학습된 가중치를 가지고 있다. 그 가중치와, 학습 · 추론 · 내보내기에 필요한 모든 코드를 묶어 놓은 것이 rfdetr 패키지다.
패키지를 쓰는 흐름은 다섯 단계다. 이 장의 차례도 이 순서를 따른다.
원문 그림 14-1 은 이 장의 다섯 단계를 왼쪽에서 오른쪽으로 잇는다. 각 단계 아래에는 그 단계에서 돌고 있는 원리를 만들어 본 장이 적혀 있다.
- 추론:
RFDETRNano()를 만들고.predict(그림)→Detections. (7 · 8 · 10장) - 데이터 준비:
train·valid·test폴더마다_annotations.coco.json. (2장) - 미세 조정:
.train(dataset_dir=…)→ 체크포인트. (6 · 9 · 11장) - 평가:
.evaluate(split="test")→ mAP 50:95 등. (3장) - 내보내기 · 배포:
.export()→ ONNX, onnxruntime 추론, 지연 시간 재기. (12장)
① 은 받아 온 모델을 그대로 써 보는 것이고, ② – ⑤ 가 “내 데이터에 맞추고 내보내는” 본론이다.
실습 파일은 세 개이다. 차례로 실행한다.
| 파일 | 하는 일 | 걸린 시간(이 튜토리얼의 노트북) |
| | 도형 세상을 COCO 형식 폴더로 내보내기 | CPU 약 15초 |
| | 사전 학습 모델 추론 → 미세 조정 2회 → 평가 → 추론 설정 바꿔 보기 | GPU 약 30분(학습 18.2분 + 8.5분, 그 밖의 단계 약 3분 반) |
| | ONNX 내보내기 → onnxruntime 추론 → 지연 시간 재기 | GPU + CPU 약 5분(그 가운데 3분은 추론 전용 스냅숏 두 개를 준비하는 시간) |
설치와 모델 가족
설치
패키지는 Python 3.10 이상에서 pip 로 설치한다. 기본 설치는 추론에 필요한 것만 들어 있고, 학습과 내보내기에 필요한 패키지는 “추가 묶음(extras)” 으로 나뉘어 있다. 이 장의 세 파일을 모두 돌리려면 train 과 onnx 묶음이 필요하다.
| 설치 명령 | 들어오는 것 | 이 장에서 쓰는 곳 |
| | torch · torchvision · transformers · supervision · pydantic 등. 추론( | 사전 학습 모델로 추론 |
| | pytorch_lightning · torchmetrics · pycocotools 를 비롯한 COCO 채점기들 · roboflow 등 | |
| | onnx · onnxruntime | |
| | | 쓰지 않음 |
- 학습 묶음을 빼먹으면
train()을 부를 때RF-DETR training dependencies are missing. Install them with `pip install "rfdetr[train,loggers]"`라는ImportError가 난다. (loggers묶음은 TensorBoard · wandb · mlflow 같은 기록 도구다. 이 장은 쓰지 않는다.) - GPU. 추론은 CPU 로도 되지만 학습은 NVIDIA GPU 가 사실상 필요하다. 이 장의 실험은 8GB 노트북 GPU(NVIDIA RTX PRO 2000 Blackwell) 한 장으로 했다. GPU 가 있다면 0장 의 안내대로 CUDA 판 torch 를 먼저 설치해 두라.
- 가중치 파일. 모델 클래스를 처음 만들 때 사전 학습 가중치를 내려받아
~/.roboflow/models/에 둔다(환경 변수RF_HOME으로 바꿀 수 있다). Nano 의rf-detr-nano.pth는 366 MB 였다. 열어 보면 모델 가중치(116 MB)와 함께 옵티마이저의 상태가 들어 있어서 크다(미세 조정 뒤에 생기는 추론용 체크포인트는 약 120 MB 이다). - 이 튜토리얼의 다른 장은 torch · numpy · matplotlib · scipy 만 쓰지만(
requirements.txt), 이 장의 코드만은 rfdetr · supervision · pillow · onnx · onnxruntime 을 쓴다.
모델 가족과 라이선스
RF-DETR 은 모델 하나가 아니라 크기가 다른 모델들의 가족 이다. 12장 에서 본 것처럼, 가중치 공유 NAS 로 찾은 파레토 곡선 위의 점들에 이름(Nano, Small, Medium …)을 붙인 것이다. 패키지에서는 크기마다 클래스가 하나씩 있다.
| 과제 | 클래스 | 라이선스 | 설치 |
| 객체 탐지 | | Apache 2.0 | |
| 객체 탐지 | Atto · Femto · Pico(아주 작은 것), XLarge · 2XLarge(아주 큰 것) | PML 1.0 | |
| 인스턴스 분할 | | Apache 2.0 | |
| 키포인트 탐지(미리보기) | | Apache 2.0 | |
라이선스는 실무에서 가장 먼저 확인할 것이다. 저장소 README(2026년 11월)에 따르면 이렇다.
- Apache 2.0:
rfdetr패키지 자체, 탐지 Nano · Small · Medium · Large, 분할 전 크기, 키포인트 모델. 소스를 공개하지 않는 상용 제품에 넣어도 되고 사용료가 없다. - PML 1.0(Roboflow Platform Model License): 탐지 Atto · Femto · Pico · XLarge · 2XLarge.
rfdetr[plus]로 따로 설치한다. README 는 “Roboflow 에 배포하면 상업적 이용이 포함되고, 직접 운영하는 상업적 이용에는 Enterprise 추가 계약이 필요하다” 고 적고 있다. -
pip install rfdetr만으로는 Apache 2.0 인 코드와 모델만 들어온다. 이 장은 Apache 2.0 인 Nano 만 쓴다.
- 라이선스는 직접 확인하라
- 위 내용은 이 글을 쓴 시점의 README 를 옮긴 것이고 법률 조언이 아니다. 제품에 넣기 전에 그 시점의 저장소
LICENSE와 README 의 License 절을 직접 읽으라.
크기별 성능표
아래 표의 왼쪽 절반(해상도 – 질의 수)은 설치판의 설정 클래스(RFDETRNanoConfig 등)에서 읽은 값이고, 오른쪽 절반은 저장소 README 의 벤치마크 표에서 옮긴 값이다. README 는 지연 시간을 “NVIDIA T4, TensorRT, FP16, 배치 1” 로, COCO AP 를 val2017 5,000장 전체로 쟀다고 밝힌다.
| 크기 | 해상도 | 패치 | 윈도(한 변) | 디코더 층 | 질의 | 매개변수(M) | 지연(ms) | COCO AP50:95 | AP50 |
| Nano | 384 | 16 | 2 | 2 | 300 | 30.5 | 2.3 | 48.4 | 67.6 |
| Small | 512 | 16 | 2 | 3 | 300 | 32.1 | 3.5 | 53.0 | 72.1 |
| Medium | 576 | 16 | 2 | 4 | 300 | 33.7 | 4.4 | 54.7 | 73.6 |
| Large | 704 | 16 | 2 | 4 | 300 | 33.9 | 6.8 | 56.5 | 75.1 |
- 네 크기의 백본은 모두 같다(DINOv2-S 에 윈도 어텐션을 넣은
dinov2_windowed_small, 은닉 차원 256). 달라지는 것은 12장 의 손잡이 가운데 해상도 와 디코더 층 수 뿐이다. 그래서 매개변수는 30.5M → 33.9M 으로 조금만 늘고(디코더 층과, 해상도를 따라 늘어나는 위치 임베딩만큼), 지연 시간은 해상도를 따라 2.3 → 6.8 ms 로 늘어난다. - 설치판에서 직접 센 Nano 의 매개변수는 30,467,298개로 표의 30.5M 과 맞다(아래 실행 출력).
- 같은 Nano 의 COCO AP 가 README 에는 48.4, 논문 표 2 에는 48.0 으로 적혀 있다(1장). 측정 시점 · 방법이 다른 두 출처이므로 섞어 쓰지 않는다. 이 표는 README 값이다.
- README 의 같은 표에서 PML 1.0 모델은 Atto 30.5 AP / 1.0 ms(380×380)부터 2XLarge 60.1 AP / 17.2 ms(880×880)까지이다.
- 표의 지연 시간은 내 컴퓨터의 지연 시간이 아니다
- 2.3 ms 는 서버용 GPU T4 에서 TensorRT 로 변환하고 FP16 으로 잰, 모델 순전파만의 시간이다. 같은 Nano 를 이 튜토리얼의 노트북에서 PyTorch 로 돌리면 전혀 다른 값이 나온다. 무엇이 왜 다른지는 이 장 뒤쪽의 지연 시간 재기 에서 직접 재 본다.
사전 학습 모델로 추론
모델 만들기와 predict
가장 짧은 사용법은 세 줄이다. 클래스를 만들면 가중치를 내려받아 읽고, predict 에 그림을 주면 결과가 돌아온다.
from rfdetr import RFDETRNano

model = RFDETRNano()                                 # COCO 로 학습된 가중치를 내려받아 읽는다
detections = model.predict("my_photo.jpg", threshold=0.5)
print(detections.xyxy, detections.confidence, detections.class_id)
my_photo.jpg 자리에 여러분의 사진을 넣어 꼭 직접 해 보라. 사람 · 자동차 · 개 같은 COCO 의 80가지 물체가 찍힌 사진이면 박스가 잘 나온다. 이 튜토리얼은 남의 사진을 싣지 않으므로, 아래 실행 예는 모두 우리의 도형 세상 그림으로 한다. COCO 에는 “원 · 사각형 · 삼각형” 이라는 클래스가 없으니 잘 될 리가 없다. 그 “안 되는 모습” 이 미세 조정이 왜 필요한지를 보여 주는 출발점이다.
ch14_finetune.py 의 첫 단계가 이 일을 한다. 모델을 만들고, 설정을 찍고, 입력 형태를 바꿔 가며 같은 결과가 나오는지 확인한다.
ch14_finetune.py · coco-predict
def try_pretrained(test_paths, fig_dir: str):
    """COCO 로 학습된 Nano 를 그대로 도형 세상에 써 본다."""
    from rfdetr import RFDETRNano
    from rfdetr.assets.coco_classes import COCO_CLASSES  # {1: "person", 2: "bicycle", …, 90: "toothbrush"}

    start = time.time()
    model = RFDETRNano()  # 처음 부르면 가중치 rf-detr-nano.pth 를 내려받는다 (~/.roboflow/models, 366 MB)
    cfg = model.model_config
    net = model.model.model  # 실제 nn.Module (클래스 이름 LWDETR)
    print(f"  모델 준비 {time.time() - start:.1f}초 | 매개변수 {sum(p.numel() for p in net.parameters()):,}개")
    print(f"  설정: resolution={cfg.resolution}, patch_size={cfg.patch_size}, num_windows={cfg.num_windows},"
          f" dec_layers={cfg.dec_layers}, num_queries={cfg.num_queries}, num_select={cfg.num_select},"
          f" group_detr={cfg.group_detr}, num_classes={cfg.num_classes}")
    print(f"  분류 머리: {net.class_embed}")
    print(f"  COCO_CLASSES: 이름 {len(COCO_CLASSES)}개, id 범위 {min(COCO_CLASSES)} – {max(COCO_CLASSES)},"
          f" 예: {COCO_CLASSES[1]!r}, {COCO_CLASSES[18]!r}")

    # (가) 입력 형태: 경로 · PIL · numpy (H, W, 3) uint8 RGB · 텐서 (3, H, W) 0 – 1 · 목록(배치)
    pil = Image.open(test_paths[0])
    array = np.asarray(pil)
    tensor = torch.from_numpy(array).permute(2, 0, 1).float() / 255.0
    low = 0.05  # 일부러 아주 낮은 문턱값 (기본은 0.5)
    outs = [model.predict(x, threshold=low) for x in (test_paths[0], pil, array, tensor)]
    batch = model.predict([test_paths[0], test_paths[1]], threshold=low)  # 목록을 주면 목록이 돌아온다
    reference = outs[0]
    diffs = [float(np.abs(o.xyxy - reference.xyxy).max()) if len(reference) else 0.0 for o in outs[1:] + batch[:1]]
    print(f"  입력 형태 check (경로 기준 박스 최대 차이, 픽셀): PIL {diffs[0]:.1e}, numpy {diffs[1]:.1e},"
          f" 텐서 {diffs[2]:.1e}, 배치 {diffs[3]:.1e}")
    print(f"  predict 가 돌려준 것: {type(reference).__module__}.{type(reference).__name__}, 객체 {len(reference)}개"
          f" (threshold={low})")
    for box, score, class_id in list(zip(reference.xyxy, reference.confidence, reference.class_id))[:4]:
        print(f"    xyxy {np.round(box, 1).tolist()}  confidence {score:.3f}  class_id {class_id}"
              f" → {COCO_CLASSES[int(class_id)]!r}")

    # (나) 시험 그림 50장(--quick 은 20장)에서 문턱값별로 몇 개나 "찾는지", 무엇이라고 부르는지
    results = []
    count = min(50, len(test_paths))
    for i in range(0, count, 10):
        results += model.predict(test_paths[i:i + 10], threshold=low)
    scores = np.concatenate([r.confidence for r in results])
    names = np.concatenate([r.data["class_name"] for r in results])
    for threshold in (0.5, 0.3, 0.1, low):
        print(f"  시험 그림 {count}장, threshold={threshold}: 탐지 {int((scores > threshold).sum())}개")
    unique, counts = np.unique(names[scores > 0.1], return_counts=True)
    top = sorted(zip(counts.tolist(), unique.tolist()), reverse=True)[:6]
    print("  threshold=0.1 에서 붙인 이름 (많은 순):", ", ".join(f"{name} {count}" for count, name in top))

    draw_pretrained_figure(test_paths, results, fig_dir)
    return model
[0] 환경: rfdetr 1.12.1, torch 2.15.0+cu132, supervision 0.31.7, 장치 NVIDIA RTX PRO 2000 Blackwell Generation Laptop GPU
[1] COCO 로 사전 학습된 RF-DETR Nano 를 도형 세상에 그대로 써 보기
  모델 준비 8.7초 | 매개변수 30,467,298개
  설정: resolution=384, patch_size=16, num_windows=2, dec_layers=2, num_queries=300, num_select=300, group_detr=13, num_classes=90
  분류 머리: Linear(in_features=256, out_features=91, bias=True)
  COCO_CLASSES: 이름 80개, id 범위 1 – 90, 예: 'person', 'dog'
  입력 형태 check (경로 기준 박스 최대 차이, 픽셀): PIL 0.0e+00, numpy 0.0e+00, 텐서 0.0e+00, 배치 5.6e-03
  predict 가 돌려준 것: supervision.detection.core.Detections, 객체 21개 (threshold=0.05)
    xyxy [0.0, 0.0, 192.0, 192.0]  confidence 0.390  class_id 82 → 'refrigerator'
    xyxy [0.0, 0.0, 192.0, 192.0]  confidence 0.110  class_id 85 → 'clock'
    xyxy [0.0, 0.0, 192.0, 192.0]  confidence 0.102  class_id 61 → 'cake'
    xyxy [0.0, 0.0, 192.0, 192.0]  confidence 0.083  class_id 13 → 'stop sign'
  시험 그림 50장, threshold=0.5: 탐지 3개
  시험 그림 50장, threshold=0.3: 탐지 18개
  시험 그림 50장, threshold=0.1: 탐지 412개
  시험 그림 50장, threshold=0.05: 탐지 2500개
  threshold=0.1 에서 붙인 이름 (많은 순): person 48, tv 46, clock 33, refrigerator 32, apple 24, laptop 22
  그림 저장: figures/ch14-coco-model-on-shapes.png
출력의 둘째 줄이 반갑다. 10장 에서 직접 만든 구조의 손잡이들이 그대로 보인다.
| 설정 | 값(Nano) | 뜻 | 만들어 본 장 |
| | 384 | 모델 입력 그림의 한 변(픽셀) | |
| | 16 | 패치 한 변. 384 ÷ 16 = 24 → 패치 토큰 24 × 24 = 576개 | |
| | 2 | 윈도 어텐션에서 한 변을 나누는 수 → 윈도 2 × 2 = 4개, 윈도 하나에 12 × 12 = 144 토큰 | |
| | 2 | 디코더 층 수 | |
| | 300 | 객체 질의 수 = 그림 한 장에서 나오는 박스 후보 수 | |
| | 300 | 후처리가 남기는 예측 수(아래 “후처리” 절) | 이 장 |
| | 13 | 학습 때만 쓰는 질의 묶음 수. 추론은 첫 묶음 300개만 | |
| | 90 | COCO 의 범주 id 가 1 – 90 이라 90. 분류 머리의 출력은 그보다 하나 많은 91칸 | 이 장 |
Detections 읽는 법
predict 가 돌려주는 것은 Detections(supervision.Detections) 이다. Roboflow 의 시각화 · 후처리 라이브러리 supervision 이 정의한, 탐지 결과를 담는 그릇이다. 객체가 \(n\) 개 탐지되었다면 필드의 모양은 이렇다.
| 필드 | 모양 · 자료형 | 내용 |
| | | 박스의 두 모서리 \((x_0, y_0, x_1, y_1)\). 원본 그림의 픽셀 좌표(모델 입력 384 의 좌표가 아님) |
| | | 점수(신뢰도). 시그모이드를 거친 0 – 1 의 값이고 내림차순 으로 정렬되어 있음 |
| | | 클래스 번호 |
| | | 클래스 이름 |
| | | 원본 그림의 (높이, 너비) |
| | | 원본 그림( |
| | | 탐지 모델은 비어 있음. 분할 모델이면 객체별 마스크 |
len(detections) 는 객체 수 \(n\) 이고, detections[detections.confidence > 0.7] 처럼 불 배열로 골라낼 수 있다.
이 튜토리얼은 2장부터 줄곧 박스를 정규화한 중심 표현 \((c_x, c_y, w, h)\) 로 써 왔다. xyxy 픽셀 좌표를 우리 형식으로 바꾸는 식은 2장의 변환에 “그림 크기로 나누기” 를 더한 것이다. 원본 그림의 너비를 \(W\), 높이를 \(H\) 라 하면
\(c_x = \frac{x_0 + x_1}{2W}, \qquad c_y = \frac{y_0 + y_1}{2H}, \qquad w = \frac{x_1 - x_0}{W}, \qquad h = \frac{y_1 - y_0}{H}\)
예를 들어 192 × 192 그림에서 xyxy = [72, 24, 120, 120] 이면 \(c_x = (72 + 120)/(2 \cdot 192) = 0.5\), \(c_y = (24 + 120)/384 = 0.375\), \(w = 48/192 = 0.25\), \(h = 96/192 = 0.5\) 이다. 3장의 evaluate_ap 에 넣을 수 있게 바꿔 주는 함수가 아래다. 이 장의 채점은 모두 이 함수를 거친다.
ch14_finetune.py · to-prediction
def detections_to_prediction(detections, num_classes: int | None = None) -> dict:
    """supervision.Detections 하나를 이 튜토리얼의 예측 형식으로 바꾼다.

    Detections 의 주요 필드 (객체 n 개):
      xyxy        (n, 4) float32 — 원본 그림의 픽셀 좌표 (x0, y0, x1, y1)
      confidence  (n,)   float32 — 점수 (시그모이드를 거친 값), 내림차순
      class_id    (n,)   int64   — 클래스 번호
      data["class_name"], data["source_shape"] (원본 그림의 (높이, 너비))
    돌려주는 값: {"boxes": (n, 4) 정규화 (cx, cy, w, h), "scores": (n,), "labels": (n,)} — 3장의 evaluate_ap 형식.
    num_classes 를 주면 class_id 가 그보다 작은 것만 남긴다 (미세 조정한 모델의 머리에는 클래스 수보다
    하나 많은 출력이 있고, 문턱값을 0 으로 두면 그 남는 칸의 예측도 딸려 나오기 때문이다).
    """
    xyxy = torch.from_numpy(np.asarray(detections.xyxy, dtype=np.float32)).reshape(-1, 4)
    scores = torch.from_numpy(np.asarray(detections.confidence, dtype=np.float32))
    labels = torch.from_numpy(np.asarray(detections.class_id, dtype=np.int64))
    if len(xyxy):
        height, width = (float(v) for v in detections.data["source_shape"][0])
        xyxy = xyxy / torch.tensor([width, height, width, height])  # 픽셀 → 0 – 1
    if num_classes is not None:
        keep = labels < num_classes
        xyxy, scores, labels = xyxy[keep], scores[keep], labels[keep]
    return {"boxes": box_xyxy_to_cxcywh(xyxy), "scores": scores, "labels": labels}
클래스 번호와 이름
위 출력에서 class_id 82 → 'refrigerator' 를 보라. COCO 의 클래스는 80가지인데 번호가 82 이다. COCO 의 범주 id 는 1 부터 90 까지이고 그 가운데 10개(12, 26, 29, 30, 45, 66, 68, 69, 71, 83)가 비어 있기 때문이다. 그래서
- 사전 학습 모델의
num_classes는 80 이 아니라 90 이고, 분류 머리는Linear(256 → 91)이다. -
class_id는 COCO 범주 id 그대로다. 이름은rfdetr.assets.coco_classes.COCO_CLASSES사전으로 찾는다(COCO_CLASSES[1]은"person",COCO_CLASSES[18]은"dog").data["class_name"]에는 이 이름이 이미 들어 있다. -
model.class_names는 이름 80개의 목록인데, 번호로 바로 찾으면 틀린다(class_names[18]은 개가 아니라 양(sheep)이다). 사전 학습 모델에서는 꼭COCO_CLASSES나data["class_name"]을 쓰라.
미세 조정한 모델은 훨씬 단순하다. 클래스 번호가 0 부터 차례로 매겨지고 model.class_names[class_id] 가 곧 이름이다. 이 차이는 “내 데이터 준비” 절에서 다시 본다.
입력 형태
predict 의 첫 인자는 여러 형태를 받는다. 위 실행의 입력 형태 check 줄이 같은 그림을 네 가지로 넣어 박스가 같은지 본 것이다.
| 형태 | 조건 |
| 파일 경로 · URL 문자열 | URL 은 그 자리에서 내려받으므로 믿을 수 있는 주소만 |
| | RGB 로 바뀌어 쓰임 |
| numpy 배열 | |
| | |
| 위의 것들의 목록 | 한 배치로 처리하고 Detections 의 목록 을 돌려줌 |
- 경로 · PIL · numpy · 텐서 넷은 박스가 완전히 같았다(차이 0). 두 장을 한 배치로 넣었을 때만 0.006 픽셀쯤 달라졌는데, 배치 크기가 바뀌면 GPU 의 연산 순서가 달라져 생기는 부동소수점 오차다.
- OpenCV 로 읽은 그림은 BGR 순서 이다. 그대로 넣으면 빨강과 파랑이 뒤바뀐 그림을 보게 된다.
image[:, :, ::-1]로 뒤집어 넣으라. - 동영상 · 폴더 · 웹캠은
predict가 받지 않는다. 문서에 따르면RFDETRInference(model).predict(…)가 그런 입력을 다룬다(이 장에서는 돌려 보지 않았다).
전처리: 리사이즈와 정규화
그림이 모델에 들어가기 전에 거치는 손질을 전처리(preprocessing) 라고 한다. predict 안에서 일어나는 일은 세 단계다.
- 0 – 1 로. uint8 픽셀값을 255 로 나누고, 모양을
(H, W, 3)에서(3, H, W)로 바꾼다. - 리사이즈. 가로세로 비율을 무시하고
resolution × resolution(Nano 는 384 × 384)으로 쌍선형 보간한다(8장 의 그 쌍선형 보간이다). 우리 그림은 192 × 192 이므로 가로세로 두 배로 커진다. 길쭉한 사진은 찌그러져 들어가지만, 출력 박스는 원본 크기로 되돌려 주므로 쓰는 사람은 신경 쓸 일이 없다. - 정규화. 채널마다 평균을 빼고 표준편차로 나눈다. 값은 ImageNet 의 통계로, DINOv2 가 사전 학습될 때 쓴 것과 같다. \(\tilde{x}_c = \frac{x_c - \text{mean}_c}{\text{std}_c}, \qquad \text{mean} = (0.485,\ 0.456,\ 0.406), \quad \text{std} = (0.229,\ 0.224,\ 0.225)\) 여기서 \(x_c\) 는 채널 \(c\)(R, G, B)의 0 – 1 픽셀값, \(\text{mean}_c\) · \(\text{std}_c\) 는 그 채널의 평균 · 표준편차, \(\tilde{x}_c\) 는 모델에 들어가는 값이다.
숫자로 확인한다. 시험 그림 0번의 왼쪽 위 픽셀은 RGB (30, 17, 39) 이다(어두운 회색 배경에 잡음이 섞인 값). R 채널은
\(\tilde{x}_R = \frac{30/255 - 0.485}{0.229} = \frac{0.1176 - 0.485}{0.229} = -1.6042\)
이다. 뒤에 나올 ch14_export.py 가 같은 전처리를 직접 구현해 이 값을 찍어 본다(전처리 예 줄).
ch14_export.py · preprocess
def preprocess(image: np.ndarray, size: int, means, stds) -> np.ndarray:
    """그림 한 장을 모델 입력으로 바꾼다. predict() 가 안에서 하는 일과 같다.

    image: (H, W, 3) uint8 RGB  →  돌려주는 값: (1, 3, size, size) float32
      ① 0 – 255 → 0 – 1,  (H, W, 3) → (3, H, W)
      ② 가로세로 비율을 무시하고 size × size 로 쌍선형 보간 (antialias 없음)
      ③ 채널마다 (값 − 평균) / 표준편차  — ImageNet 의 평균 · 표준편차
    """
    x = torch.from_numpy(image).permute(2, 0, 1).float() / 255.0           # (3, H, W)
    x = F.interpolate(x[None], size=(size, size), mode="bilinear", align_corners=False)  # (1, 3, size, size)
    mean = torch.tensor(means).view(1, 3, 1, 1)
    std = torch.tensor(stds).view(1, 3, 1, 1)
    return ((x - mean) / std).numpy()
- antialias 인자
-
predict(…, antialias=False)가 기본이다. 그림을 줄일 때 계단 현상을 막는 흐림 처리(안티에일리어싱)를 할지 정하는 인자로, 문서는 “학습 때의 리사이즈 방식과 맞추라” 고 한다. 우리처럼 192 를 384 로 키우는 경우에는 결과에 차이가 없다. 모델 해상도보다 훨씬 큰 사진을 다룬다면 두 값을 다 돌려 검증 AP 가 좋은 쪽을 고르라.
후처리: 질의 곱하기 클래스에서 상위 K 고르기
모델(신경망)이 내놓는 날출력은 두 텐서다. 질의 수를 \(Q\)(= 300), 분류 머리의 출력 칸 수를 \(C\)(COCO 모델은 91)라 하면
-
pred_boxes: 모양(B, Q, 4). 질의마다의 박스, 정규화 \((c_x, c_y, w, h)\) -
pred_logits: 모양(B, Q, C). 질의마다 · 클래스마다의 로짓(시그모이드를 거치기 전의 값)
이것을 “점수 높은 박스 몇 개” 로 바꾸는 손질이 후처리(postprocessing) 이다. 7장 의 DETR 은 질의마다 소프트맥스로 클래스 하나 를 골랐다. RF-DETR 은 다르다. 4장 · 9장 에서 본 것처럼 분류 손실이 시그모이드 기반(IA-BCE)이라, 칸 하나하나가 “이 질의가 이 클래스의 객체인가” 를 따로 답하는 독립된 점수 이다. 그래서 후처리도 질의 단위가 아니라 (질의, 클래스) 쌍 단위로 한다. 패키지의 PostProcess(rfdetr/models/postprocess.py)가 하는 일을 순서대로 적으면 이렇다.
- 날출력에서 탐지 결과까지 (그림 한 장 기준)
\(s_{q,c} = \sigma(z_{q,c}) = \frac{1}{1 + e^{-z_{q,c}}} \qquad (q = 0, \dots, Q-1;\ \ c = 0, \dots, C-1)\)
① 로짓 \(z_{q,c}\)(질의 \(q\) 의 클래스 \(c\) 칸)마다 시그모이드 \(\sigma\) 를 씌워 점수 \(s_{q,c}\) 를 만든다. 소프트맥스가 아니므로 한 질의의 점수들을 더해도 1 이 아니다.
\(i = q \cdot C + c \qquad (i = 0, \dots, QC - 1)\)
② \((Q, C)\) 표를 한 줄로 편다. 쌍 \((q, c)\) 가 편 번호 \(i\) 가 된다. COCO 모델이면 \(300 \times 91 = 27{,}300\) 개의 쌍이다.
\(\{i_1, \dots, i_K\} = \text{점수 } s_i \text{ 가 큰 순서로 } K \text{ 개}, \qquad K = \min(\texttt{num\_select},\ QC)\)
③ 쌍 전체에서 점수 상위 \(K\) 개를 고른다. 기본 \(K = 300\). 점수가 같으면 편 번호가 작은 쪽이 먼저다(안정 정렬).
\(q_k = \lfloor i_k / C \rfloor, \qquad c_k = i_k \bmod C\)
④ 편 번호를 다시 질의 번호(몫)와 클래스 번호(나머지)로 푼다. \(\lfloor \cdot \rfloor\) 는 내림이다.
\((x_0, y_0, x_1, y_1)_k = \Big( (c_x - \tfrac{w}{2})\,W,\ \ (c_y - \tfrac{h}{2})\,H,\ \ (c_x + \tfrac{w}{2})\,W,\ \ (c_y + \tfrac{h}{2})\,H \Big)\)
⑤ 질의 \(q_k\) 의 박스 \((c_x, c_y, w, h)\) 를 모서리 표현으로 바꾸고(2장) 원본 그림 의 너비 \(W\) · 높이 \(H\) 를 곱한다. 그림 밖으로 나간 좌표는 \([0, W]\), \([0, H]\) 로 자른다.
\(\text{결과} = \{\, (\text{박스}_k,\ s_{i_k},\ c_k) \;:\; s_{i_k} \gt \tau \,\}\)
⑥ 마지막으로 점수가 문턱값 \(\tau\)(threshold, 기본 0.5)보다 큰 것만 남긴다. NMS 는 어디에도 없다(7장: 헝가리안 매칭으로 학습한 모델은 중복 예측을 스스로 억제한다).
작은 숫자로 따라가 본다. 질의 3개(\(Q = 3\)), 클래스 2개(\(C = 2\)), num_select \(= 3\), 그림은 너비 200 · 높이 100 이라 하고 로짓이 다음과 같다고 하자.
| 질의 \(q\) | 박스 \((c_x, c_y, w, h)\) | 로짓 \(z_{q,0}\) | 로짓 \(z_{q,1}\) | 점수 \(s_{q,0}\) | 점수 \(s_{q,1}\) |
| 0 | (0.5, 0.5, 0.2, 0.4) | 2.0 | −1.0 | 0.8808 | 0.2689 |
| 1 | (0.25, 0.75, 0.5, 0.5) | 0.0 | 1.0 | 0.5000 | 0.7311 |
| 2 | (0.8, 0.2, 0.1, 0.1) | −3.0 | −2.0 | 0.0474 | 0.1192 |
- 시그모이드: \(\sigma(2) = 1/(1 + e^{-2}) = 1/1.1353 = 0.8808\), \(\sigma(1) = 1/1.3679 = 0.7311\), \(\sigma(0) = 0.5\) 등.
- 편 번호: 점수를 한 줄로 펴면 \([0.8808,\ 0.2689,\ 0.5000,\ 0.7311,\ 0.0474,\ 0.1192]\) (편 번호 0 – 5).
- 상위 3개: 편 번호 0(0.8808), 3(0.7311), 2(0.5000).
- 풀기: \(0 \to (q, c) = (0, 0)\), \(\ 3 \to (\lfloor 3/2 \rfloor,\ 3 \bmod 2) = (1, 1)\), \(\ 2 \to (1, 0)\). 질의 1 이 두 번 뽑혔다. 한 번은 클래스 1 로, 한 번은 클래스 0 으로. 같은 박스가 서로 다른 이름표를 달고 두 번 나올 수 있다는 뜻이다.
- 박스: 질의 0 은 \(((0.5 - 0.1) \cdot 200,\ (0.5 - 0.2) \cdot 100,\ (0.5 + 0.1) \cdot 200,\ (0.5 + 0.2) \cdot 100) = (80, 30, 120, 70)\), 질의 1 은 \(((0.25 - 0.25) \cdot 200,\ (0.75 - 0.25) \cdot 100,\ 0.5 \cdot 200,\ 1.0 \cdot 100) = (0, 50, 100, 100)\).
- 문턱값 0.5: 0.8808 과 0.7311 은 남고, 0.5000 은 0.5 보다 크지 않으므로 빠진다. 결과는 두 개이다.
같은 계산을 코드로 한 것이 아래다(ch14_export.py). 이 함수는 뒤에서 ONNX 모델의 날출력을 직접 후처리하는 데 그대로 쓰인다.
ch14_export.py · postprocess
def postprocess(dets: np.ndarray, logits: np.ndarray, width: int, height: int, num_select: int = 300,
                threshold: float = 0.5):
    """모델의 날출력 한 장 분량을 탐지 결과로 바꾼다. 패키지의 PostProcess 와 같은 순서다.

    dets:   (Q, 4)  질의마다의 박스, 정규화 (cx, cy, w, h)          (Q = 질의 수 300)
    logits: (Q, C)  질의마다 · 클래스마다의 로짓 (시그모이드 전)     (C = 머리의 출력 칸 수)
    돌려주는 값: xyxy (n, 4) 원본 픽셀 좌표, scores (n,), class_ids (n,), query_ids (n,)
    """
    prob = 1.0 / (1.0 + np.exp(-logits))                 # ① 시그모이드: (Q, C) 칸마다 독립인 점수
    flat = prob.reshape(-1)                              # ② (Q·C,) 로 편다 — "질의 × 클래스" 쌍 전체
    order = np.argsort(-flat, kind="stable")[:num_select]  # ③ 점수 상위 num_select 개의 쌍
    scores = flat[order]
    query_ids = order // prob.shape[1]                   # ④ 편 번호 → 질의 번호 (몫)
    class_ids = order % prob.shape[1]                    #            → 클래스 번호 (나머지)
    cx, cy, w, h = dets[query_ids].T                     # ⑤ 그 질의의 박스를 가져와 (같은 질의가 두 번 뽑힐 수도 있다)
    xyxy = np.stack([cx - w / 2, cy - h / 2, cx + w / 2, cy + h / 2], axis=1)
    xyxy = xyxy * np.array([width, height, width, height], dtype=np.float32)  # ⑥ 원본 그림의 픽셀 단위로
    xyxy = np.clip(xyxy, 0.0, [width, height, width, height])                 #    그림 밖으로 나간 부분은 자른다
    keep = scores > threshold                            # ⑦ 문턱값보다 큰 것만. NMS 는 없다
    return xyxy[keep], scores[keep], class_ids[keep], query_ids[keep]
  손계산 예: 시그모이드 점수 (질의 3 × 클래스 2) = [[0.8808, 0.2689], [0.5, 0.7311], [0.0474, 0.1192]]
    편 번호 상위 3개 [0, 3, 2] → 질의 [0, 1, 1], 클래스 [0, 1, 0], 점수 [0.8808, 0.7311, 0.5]
    문턱값 0.5 통과: 질의 0, 클래스 0, 점수 0.8808, xyxy [80.0, 30.0, 120.0, 70.0]
    문턱값 0.5 통과: 질의 1, 클래스 1, 점수 0.7311, xyxy [0.0, 50.0, 100.0, 100.0]
- 상위 K 개는 “질의 K 개” 가 아니다
-
num_select = 300이라고 해서 질의 300개가 하나씩 나오는 것이 아니다. 27,300 개의 (질의, 클래스) 쌍 가운데 점수가 높은 300 쌍이다. 자신 있는 질의는 여러 클래스로 여러 번 뽑힐 수 있고, 자신 없는 질의는 한 번도 안 뽑힐 수 있다. 다만 잘 학습된 모델에서는 둘째 클래스의 점수가 보통 문턱값보다 한참 낮아서,threshold=0.5를 넘는 결과에서 같은 박스가 두 번 보이는 일은 드물다.
COCO 모델은 도형을 모른다
이제 위 실행 출력의 아래쪽을 읽어 보자. COCO 로 학습된 Nano 에게 도형 세상의 시험 그림 50장을 보여 준 결과다.
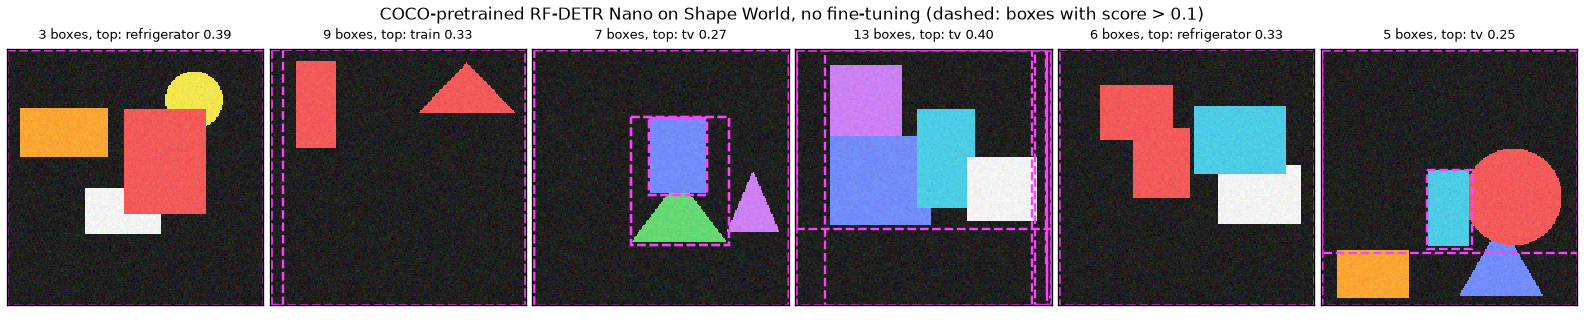
분홍 점선은 점수가 0.1 을 넘는 박스 전부이고, 그림마다 제목에 박스 수와 점수가 가장 높은 예측의 이름 · 점수를 적었다. 도형 세상 시험 그림 여섯 장에서 대부분의 박스가 그림 전체를 덮고, 냉장고 · TV 같은 COCO 이름이 붙어 있다.
- 기본 문턱값 0.5 에서는 거의 아무것도 나오지 않는다. 50장(정답 객체 123개)에서 탐지 3개. 모델은 “내가 아는 물체가 없다” 고 꽤 정직하게 답하고 있다.
- 문턱값을 낮추면 엉뚱한 이름이 쏟아진다. 0.1 에서 412개, 0.05 에서는 2,500개(그림당 50개). 붙인 이름은 person 48, tv 46, clock 33, refrigerator 32, apple 24, laptop 22 순이다. 네모난 것(TV · 냉장고 · 노트북)과 둥근 것(시계 · 사과)의 이름이 많은 것을 보면, 처음 보는 도형을 “아는 것 가운데 가장 비슷한 것” 에 끼워 맞추고 있는 듯하다.
- 박스의 위치도 맞지 않다. 시험 그림 0번에서 점수가 가장 높은 예측은 그림 전체(
[0, 0, 192, 192])를 냉장고(0.39)라고 한 것이다. 그림 14-2 에서도 분홍 박스는 대부분 그림 전체나 도형 여러 개를 한꺼번에 감싸고 있다. 다만 도형 하나에 꼭 맞는 박스도 가끔 보인다 — 클래스 이름은 몰라도 “무언가 덩어리가 있다” 는 것은 느끼고 있다는 뜻이다.
그렇다고 이 모델이 쓸모없는 것은 아니다. 이름표(분류 머리)만 우리 것이 아닐 뿐, 그 아래의 백본 · 프로젝터 · 디코더는 “그림에서 물체를 찾아 박스를 두르는 법” 을 이미 알고 있다. 미세 조정 은 그 지식을 그대로 둔 채 이름표를 우리 클래스로 갈아 끼우고 조금 더 학습하는 일이다. 그러려면 먼저 우리 데이터를 패키지가 읽을 수 있는 모양으로 만들어야 한다.
추론 전용 스냅숏
위 출력에는 생략했지만, predict 를 처음 부르면 패키지가 이런 경고를 한 번 낸다.
[WARNING] rf-detr - Model is not optimized for inference. Latency may be higher than expected. Create predictor = native_model.inference(...) and use predictor.predict(...).
model.predict() 는 학습할 때와 같은 일반 PyTorch 모듈로 추론한다. 편하지만 가장 빠른 길은 아니다. predictor = model.inference() 는 지금의 가중치를 복사해 배치 크기와 해상도를 고정한 추론 전용 사본을 만들어 돌려주고(GPU 에서는 연산 순서를 미리 기록해 두었다가 재생하는 CUDA 그래프를 쓴다), 그 뒤로는 predictor.predict(그림) 을 쓴다. 반정밀도로 만들려면 model.inference(dtype="float16") 이다. 얼마나 빨라지는지는 지연 시간 절에서 잰다.
- optimize_for_inference() 는 없어졌다
- 예전 글과 예제에는
model.optimize_for_inference()가 자주 나온다. 1.12.1 에서 부르면AttributeError: 'RFDETRNano' object has no attribute 'optimize_for_inference'가 난다. 저장소의 변경 기록(CHANGELOG)에 따르면 이 이름은 1.9 부터inference()로 바뀌었고 그 뒤 지워졌다. 또 예전에는 모델 자체를 바꿔 놓았지만, 지금의inference()는 원래 모델을 건드리지 않고 새 추론기를 돌려준다.
내 데이터 준비: COCO 형식
패키지가 받는 폴더 구조
train(dataset_dir=…) 에는 폴더 하나를 준다. 패키지는 그 안을 보고 형식을 스스로 알아낸다. 문서와 소스에 따르면 두 가지를 받는다.
| 형식 | 알아보는 기준 | 주석이 담긴 곳 | 박스 표기 |
| COCO 형식(COCO format) | | 분할(train · valid · test)마다 JSON 파일 하나 | 픽셀 |
| YOLO 형식(YOLO format) | | 그림마다 | 정규화 |
둘 다 있으면 COCO 가 우선이다. 이 장은 COCO 형식을 쓴다(직접 돌려 확인한 것도 COCO 형식뿐이다). 폴더는 이렇게 생겼다.
ch14_shapes_coco/
├── train/
│   ├── _annotations.coco.json      ← 학습용 주석 (이 이름 그대로여야 한다)
│   ├── 000000.png
│   ├── 000001.png
│   └── …
├── valid/                          ← 검증용. "val" 이 아니라 "valid"
│   ├── _annotations.coco.json
│   └── …
└── test/                           ← 시험용. evaluate(split="test") 가 읽는다
    ├── _annotations.coco.json
    └── …
세 분할의 역할은 3장 에서 본 그대로다. 학습 세트로 가중치를 고치고, 검증 세트로 에폭마다 채점해 가장 좋은 체크포인트를 고르고, 시험 세트는 마지막에 한 번만 본다. 이 폴더 구조는 Roboflow 서비스에서 데이터셋을 “COCO” 로 내려받았을 때의 구조와 같다. 그래서 train() 의 dataset_file 인자의 기본값 이름이 "roboflow" 이다.
주석 JSON 의 세 목록
_annotations.coco.json 은 큰 사전 하나이고, 그 안의 목록 세 개가 핵심이다.
| 목록 | 원소 하나 | 필드 |
| | 그림 한 장 | |
| | 클래스 하나 | |
| | 객체 하나 | |
그림과 객체가 따로 적혀 있고 image_id 로 이어진다는 점이 처음에는 낯설다. 객체가 없는 그림은 images 에만 있고 annotations 에는 한 줄도 없다. iscrowd 는 “사람 무리” 처럼 낱개로 셀 수 없는 영역을 표시하는 값이다. 보통은 0 이고, 문서에 따르면 1 인 주석은 학습 정답으로 쓰이지 않는다.
박스 좌표 바꾸기
COCO 의 bbox 는 네 숫자 [x, y, w, h] 이다. 2장의 두 가지 표현(모서리 표현 · 중심 표현) 가운데 어느 것과도 다르다.
- 앞의 두 숫자
(x, y)는 박스의 왼쪽 위 모서리(중심이 아님), 뒤의 두 숫자는 너비 · 높이 - 단위는 픽셀(0 – 1 로 정규화하지 않음). 원점은 그림의 왼쪽 위이고 세로 좌표는 아래로 갈수록 커진다
- 이 절에서만 — 같은 글자 w, h 의 두 가지 단위
- 우리 형식의 너비 · 높이와 COCO 의 너비 · 높이가 둘 다 흔히 \(w\), \(h\) 로 쓰여 헷갈린다. 이 절에서는 정규화한 우리 형식 을 \((c_x, c_y, w, h)\), COCO 의 픽셀 값 을 \([x^{\text{px}}, y^{\text{px}}, w^{\text{px}}, h^{\text{px}}]\) 로 구별해 쓴다. 그림의 너비 · 높이(픽셀)는 대문자 \(W\), \(H\) 이다.
- 정규화 (cx, cy, w, h) 에서 COCO [x, y, w, h] 로
\(x_0 = c_x - \frac{w}{2}, \qquad y_0 = c_y - \frac{h}{2}\)
2장: 왼쪽 위 모서리는 중심에서 너비 · 높이의 절반만큼 왼쪽 · 위로 간 점이다(아직 0 – 1 단위).
\(x^{\text{px}} = x_0 \cdot W = \Big(c_x - \frac{w}{2}\Big) W, \qquad y^{\text{px}} = y_0 \cdot H = \Big(c_y - \frac{h}{2}\Big) H\)
정규화 좌표는 “그림 크기에 대한 비율” 이므로, 가로 방향 값에는 그림 너비 \(W\) 를, 세로 방향 값에는 높이 \(H\) 를 곱하면 픽셀이 된다.
\([x^{\text{px}},\ y^{\text{px}},\ w^{\text{px}},\ h^{\text{px}}] = \Big[ \Big(c_x - \frac{w}{2}\Big) W,\ \ \Big(c_y - \frac{h}{2}\Big) H,\ \ wW,\ \ hH \Big]\)
너비 · 높이도 같은 이유로 \(W\) · \(H\) 를 곱한다.
거꾸로는 각 식을 뒤집으면 된다. 모서리에 너비의 절반을 더해 중심으로 옮기고, 그림 크기로 나눈다.
\(c_x = \frac{x^{\text{px}} + w^{\text{px}}/2}{W}, \qquad c_y = \frac{y^{\text{px}} + h^{\text{px}}/2}{H}, \qquad w = \frac{w^{\text{px}}}{W}, \qquad h = \frac{h^{\text{px}}}{H}\)
손으로 해 본다. 정규화 박스 \((c_x, c_y, w, h) = (0.5,\ 0.375,\ 0.25,\ 0.5)\) 를 192 × 192 그림의 COCO 박스로 바꾸면
- \(x^{\text{px}} = (0.5 - 0.125) \times 192 = 0.375 \times 192 = 72\)
- \(y^{\text{px}} = (0.375 - 0.25) \times 192 = 0.125 \times 192 = 24\)
- \(w^{\text{px}} = 0.25 \times 192 = 48\), \(\ h^{\text{px}} = 0.5 \times 192 = 96\) →
[72, 24, 48, 96], 넓이 \(48 \times 96 = 4608\) - 되돌리기: \(c_x = (72 + 24)/192 = 0.5\), \(c_y = (24 + 48)/192 = 0.375\) ✓
같은 박스가 96 × 96 그림에서는 [36, 12, 24, 48] 이다. 정규화 좌표는 그림 크기가 바뀌어도 그대로지만 COCO 좌표는 그림 크기에 따라 달라진다. 그래서 그림을 리사이즈해 저장할 때는 주석도 같이 고쳐야 한다.
ch14_make_coco.py · convert
def cxcywh_norm_to_coco(box, width: int, height: int):
    """정규화 (cx, cy, w, h) → COCO bbox [x, y, w, h] (픽셀, (x, y) 는 왼쪽 위 모서리).

    x = (cx − w/2)·W,  y = (cy − h/2)·H,  너비 = w·W,  높이 = h·H
    """
    cx, cy, w, h = (float(v) for v in box)
    return [(cx - w / 2) * width, (cy - h / 2) * height, w * width, h * height]

def coco_to_cxcywh_norm(bbox, width: int, height: int):
    """COCO bbox [x, y, w, h] (픽셀) → 정규화 (cx, cy, w, h). 위 함수의 역변환."""
    x, y, w, h = (float(v) for v in bbox)
    return [(x + w / 2) / width, (y + h / 2) / height, w / width, h / height]
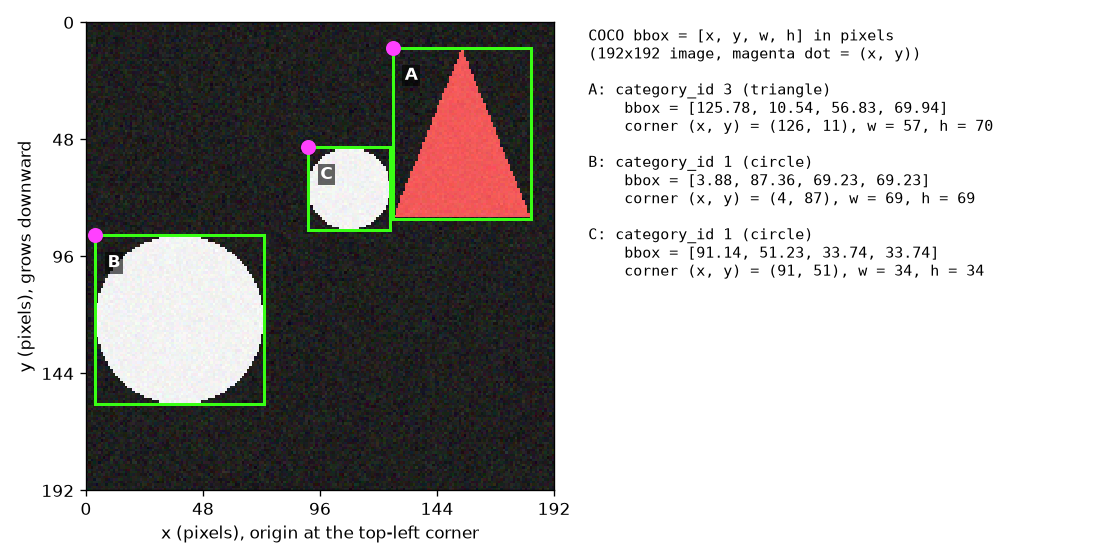
학습 세트의 한 그림(192×192)과 그 주석 세 개. 초록 사각형이 박스이고, 분홍 점이 bbox 의 앞 두 숫자 \((x^{\text{px}}, y^{\text{px}})\), 곧 왼쪽 위 모서리다. 축의 눈금은 픽셀이고 세로축이 아래로 자란다.
그림 14-3 에서 읽을 것은 두 가지이다. 첫째, 분홍 점은 늘 박스의 왼쪽 위 에 있다(중심이 아니다). 둘째, 오른쪽에 적힌 bbox 의 뒤 두 숫자는 오른쪽 아래 모서리의 좌표가 아니라 너비와 높이 이다. 원 B 는 너비와 높이가 같고(69.23), 삼각형 A 는 높이(69.94)가 너비(56.83)보다 크다. 2장의 모서리 표현 \((x_0, y_0, x_1, y_1)\) 과 가장 자주 헷갈리는 부분이니 눈에 익혀 두라.
도형 세상 내보내기
이제 ShapesDataset 을 COCO 형식 폴더로 저장한다. 장면은 앞 장들과 같은 시드(학습 0, 검증 1, 시험 2)로 만들되, 그림은 96 대신 192 픽셀 로 그린다. 0장 에서 본 것처럼 장면은 정규화 좌표로 적혀 있어 어떤 해상도로도 그릴 수 있다. 학습 1,000장 · 검증 200장 · 시험 200장이다.
ch14_make_coco.py · export
def export_split(dataset: ShapesDataset, split_dir: str) -> dict:
    """데이터셋 하나를 COCO 형식 폴더 하나로 저장하고, 저장한 주석 사전을 돌려준다.

    COCO 주석 JSON 은 목록 세 개로 이루어진다.
      images:      그림마다 {"id", "file_name", "width", "height"}
      categories:  클래스마다 {"id", "name", "supercategory"} — COCO 의 관례대로 id 를 1 부터 매긴다.
      annotations: 객체마다 {"id", "image_id", "category_id", "bbox", "area", "iscrowd"}
    """
    os.makedirs(split_dir, exist_ok=True)
    size = dataset.size
    images, annotations = [], []
    for image_id, target in enumerate(dataset.targets):
        file_name = f"{image_id:06d}.png"
        pixels = dataset.images[image_id].permute(1, 2, 0).numpy()  # (3, S, S) uint8 → (S, S, 3)
        Image.fromarray(pixels).save(os.path.join(split_dir, file_name))  # PNG: 손실 없이 저장
        images.append({"id": image_id, "file_name": file_name, "width": size, "height": size})
        for box, label in zip(target["boxes"].tolist(), target["labels"].tolist()):
            bbox = cxcywh_norm_to_coco(box, size, size)
            annotations.append({
                "id": len(annotations) + 1,          # 주석 번호 (데이터셋 안에서 유일하면 된다)
                "image_id": image_id,                # 어느 그림의 객체인가
                "category_id": int(label) + 1,       # 우리 클래스 0, 1, 2 → COCO 범주 id 1, 2, 3
                "bbox": [round(v, 2) for v in bbox],  # [x, y, w, h] 픽셀
                "area": round(round(bbox[2], 2) * round(bbox[3], 2), 2),  # 넓이 (여기서는 박스 넓이 w·h)
                "iscrowd": 0,                        # 1 이면 "여럿이 뭉친 영역" — 학습 정답으로 쓰지 않는다
            })
    coco = {
        "info": {"description": "Shape World (RF-DETR tutorial, chapter 14)"},
        "licenses": [],
        "images": images,
        "categories": [{"id": k + 1, "name": name, "supercategory": "shape"} for k, name in enumerate(CLASS_NAMES)],
        "annotations": annotations,
    }
    with open(os.path.join(split_dir, ANNOTATION_FILE), "w", encoding="utf-8") as f:
        json.dump(coco, f)
    return coco
저장한 폴더를 다시 읽어 우리 형식의 정답으로 되돌리는 함수도 만든다. 뒤에서 시험 세트를 3장의 evaluate_ap 로 채점할 때 쓴다. 그리고 “저장 → 다시 읽기” 를 거친 박스가 원래와 같은지 확인한다.
ch14_make_coco.py · load
def load_coco_split(split_dir: str):
    """COCO 형식 폴더를 읽어 (그림 경로 목록, 정답 목록) 을 돌려준다.

    정답은 이 튜토리얼의 형식: {"boxes": (n, 4) 정규화 (cx, cy, w, h), "labels": (n,) 0 부터의 클래스 번호}.
    범주 id 를 작은 것부터 0, 1, 2 … 로 다시 매긴다 — rfdetr 패키지가 학습할 때 하는 일과 같다.
    """
    with open(os.path.join(split_dir, ANNOTATION_FILE), encoding="utf-8") as f:
        coco = json.load(f)
    cat_to_label = {cat_id: k for k, cat_id in enumerate(sorted(c["id"] for c in coco["categories"]))}
    by_image = {image["id"]: [] for image in coco["images"]}
    for ann in coco["annotations"]:
        by_image[ann["image_id"]].append(ann)
    paths, targets = [], []
    for image in coco["images"]:
        anns = by_image[image["id"]]
        boxes = [coco_to_cxcywh_norm(a["bbox"], image["width"], image["height"]) for a in anns]
        paths.append(os.path.join(split_dir, image["file_name"]))
        targets.append({
            "boxes": torch.tensor(boxes, dtype=torch.float32).reshape(-1, 4),
            "labels": torch.tensor([cat_to_label[a["category_id"]] for a in anns], dtype=torch.int64),
        })
    return paths, targets
ch14_make_coco.py · check
def check_roundtrip(dataset: ShapesDataset, split_dir: str) -> float:
    """저장한 폴더를 다시 읽어 원래 정답과 비교한다. 돌려주는 값: 박스 좌표의 최대 차이 (정규화 단위)."""
    paths, targets = load_coco_split(split_dir)
    assert len(paths) == len(dataset)
    worst = 0.0
    for original, loaded in zip(dataset.targets, targets):
        assert original["labels"].tolist() == loaded["labels"].tolist()
        if len(original["boxes"]):
            worst = max(worst, float((original["boxes"] - loaded["boxes"]).abs().max()))
    first = np.asarray(Image.open(paths[0]))  # 그림도 한 장 읽어 픽셀이 그대로인지 본다
    assert np.array_equal(first, dataset.images[0].permute(1, 2, 0).numpy())
    return worst
[1] 손계산 예: 정규화 (cx, cy, w, h) = (0.5, 0.375, 0.25, 0.5)
  96×96 그림 → COCO bbox [x, y, w, h] = [36.0, 12.0, 24.0, 48.0]  (넓이 1152)  → 되돌리면 (0.5, 0.375, 0.25, 0.5)
  192×192 그림 → COCO bbox [x, y, w, h] = [72.0, 24.0, 48.0, 96.0]  (넓이 4608)  → 되돌리면 (0.5, 0.375, 0.25, 0.5)
[2] 도형 세상을 COCO 형식으로 내보내기 → ch14_shapes_coco/  (그림 192×192)
  train: 그림  1000장, 객체  2442개 (circle 807, rectangle 863, triangle 772) | 되읽기 check: 박스 최대 차이 3.8e-05
  valid: 그림   200장, 객체   501개 (circle 169, rectangle 183, triangle 149) | 되읽기 check: 박스 최대 차이 3.8e-05
  test : 그림   200장, 객체   483개 (circle 161, rectangle 163, triangle 159) | 되읽기 check: 박스 최대 차이 3.8e-05
  걸린 시간 15.1초
[3] 주석 파일 들여다보기 (train/_annotations.coco.json)
  images[0]      = {"id": 0, "file_name": "000000.png", "width": 192, "height": 192}
  categories     = [{"id": 1, "name": "circle", "supercategory": "shape"}, {"id": 2, "name": "rectangle", "supercategory": "shape"}, {"id": 3, "name": "triangle", "supercategory": "shape"}]
  annotations[0] = {"id": 1, "image_id": 0, "category_id": 2, "bbox": [6.2, 130.09, 41.38, 29.08], "area": 1203.33, "iscrowd": 0}
  2장 형식의 같은 박스 (cx, cy, w, h) = [0.1401, 0.7533, 0.2155, 0.1515]
  그림 저장: figures/ch14-coco-bbox.png
- 되읽기 check. 박스 좌표의 최대 차이가 \(3.8 \times 10^{-5}\)(정규화 단위)이다. 주석을 소수 둘째 자리 픽셀로 반올림해 저장했기 때문에 생기는 차이다. 반올림 오차는 숫자마다 최대 0.005 픽셀이므로 중심 \(x^{\text{px}} + w^{\text{px}}/2\) 의 오차는 최대 \(0.005 + 0.0025 = 0.0075\) 픽셀, 192 로 나누면 \(3.9 \times 10^{-5}\) 로 관측값과 맞다. 무시해도 되는 크기다.
- 주석 한 줄 읽기.
annotations[0]은 0번 그림의 사각형(category_id2)이고bbox는[6.2, 130.09, 41.38, 29.08]이다. 되돌리면 \(c_x = (6.2 + 41.38/2)/192 = 26.89/192 = 0.1401\), \(c_y = (130.09 + 29.08/2)/192 = 144.63/192 = 0.7533\), \(w = 41.38/192 = 0.2155\), \(h = 29.08/192 = 0.1515\). 마지막 줄의 2장 형식 값과 같다. - 세 클래스가 고르게 들어 있다(학습 세트에 원 807, 사각형 863, 삼각형 772).
클래스 번호는 다시 매겨진다
우리 클래스는 0, 1, 2 인데 category_id 는 일부러 COCO 의 관례대로 1, 2, 3 으로 적었다. 그래도 된다. 패키지는 (기본값 dataset_file="roboflow" 일 때) 학습 세트의 categories 를 id 순으로 늘어놓고 0 부터 다시 번호를 매긴다.
| JSON 의 | 이름 | 모델의 |
| 1 | circle | 0 |
| 2 | rectangle | 1 |
| 3 | triangle | 2 |
미세 조정을 마친 모델에서 model.class_names 는 ['circle', 'rectangle', 'triangle'] 이었고, predict 의 class_id 는 0, 1, 2 로 나왔다(뒤의 실행 출력). 범주 id 가 0 부터든 1 부터든, 중간에 빈 번호가 있든 결과는 같다. 예측의 class_id 는 JSON 의 category_id 가 아니라 “id 순서로 몇 번째 범주인가” 이다. 우리 load_coco_split 도 같은 방식으로 번호를 매겨 두었으므로 모델의 예측과 그대로 비교할 수 있다.
그리고 클래스 수를 따로 알려 줄 필요가 없다. train() 이 categories 를 세어 분류 머리를 알맞은 크기로 다시 만든다. 이때 나오는 경고와 그 뜻은 다음 절에서 본다.
해상도와 나누어떨어짐 제약
우리 그림은 192 픽셀인데 Nano 의 입력은 384 이다. 문제없다. 학습 때도 추론 때도 패키지가 그림을 모델 해상도로 리사이즈한다(주석의 박스도 함께). 데이터셋의 그림 크기는 제각각이어도 된다.
모델 해상도를 바꾸고 싶다면 제약이 하나 있다. 한 변의 길이가 patch_size × num_windows 로 나누어떨어져야 한다.
- 왜 patch_size × num_windows 의 배수여야 하나
\(N = \frac{S}{P} \quad \text{가 정수}\)
그림 한 변 \(S\) 픽셀을 한 변 \(P\) 픽셀의 패치로 빈틈없이 자르려면(6장) \(S\) 가 \(P\) 의 배수여야 한다. \(N\) 은 한 변의 패치 수이다.
\(\frac{N}{M} \quad \text{가 정수}\)
윈도 어텐션은 \(N \times N\) 패치 격자를 한 변 \(M\) 등분해 \(M \times M\) 개의 윈도로 나눈다(9장). 윈도마다 패치 수가 같으려면 \(N\) 이 \(M\) 의 배수여야 한다.
\(S = P \cdot M \cdot n \qquad (n = 1, 2, 3, \dots)\)
두 조건을 합치면 \(S\) 는 \(P \cdot M\) 의 배수다. \(n\) 은 윈도 한 변의 패치 수이다.
Nano 는 \(P = 16\), \(M = 2\) 이므로 \(S\) 는 32 의 배수 여야 한다. 기본 384 는 \(32 \times 12\) 로, 패치 \(24 \times 24\) 개가 \(12 \times 12\) 짜리 윈도 4개로 나뉜다. 320, 352, 416, 448 은 되고 400 은 안 된다(\(400/32 = 12.5\)). 실제로 넣어 보면 이렇게 거절된다.
shape=(400, 400) 은 거절된다: shape must have both dimensions divisible by 32 (patch_size=16 * num_windows=2), got (400, 400).
이 제약은 학습(train(resolution=…)), 추론(predict(shape=…)), 내보내기(export(shape=…)) 모두에 똑같이 적용된다. 분할 모델은 패치가 12 라서 배수가 다르다(대부분 24, SegNano 는 12).
- 학습 중에는 해상도가 배치마다 바뀐다
- 11장 의 다중 스케일 학습이 기본으로 켜져 있다(
multi_scale="per-batch",expanded_scales=True). 설치판의 함수로 Nano(384)의 후보 크기를 계산해 보면 224, 256, 288, …, 544 의 11가지, 곧 384 를 가운데 두고 32 씩 다섯 칸 아래위다(384 의 0.58 – 1.42 배; 논문의 “0.5 – 1.5 배” 에 해당). 배치마다 이 가운데 하나를 무작위로 골라 그 크기로 학습한다. 검증과 추론은 늘 384 이다.
미세 조정
train 한 번 부르기
미세 조정은 메서드 하나다. 모델을 만들고(사전 학습 가중치가 읽힌다) train() 에 데이터셋 폴더와 출력 폴더를 알려 준다. 11장에서 손으로 짠 학습 고리, 곧 다중 스케일, Group DETR, 헝가리안 매칭, IA-BCE · L1 · GIoU 손실, 보조 손실, 기울기 누적, 기울기 자르기, AdamW, EMA, 에폭마다의 검증이 모두 이 한 줄 안에서 돈다. (안쪽은 PyTorch Lightning 으로 짜여 있다.)
ch14_finetune.py · config
# 미세 조정 설정. model.train(**TRAIN_KWARGS) 로 넘긴다. 적지 않은 것은 TrainConfig 의 기본값이다.
TRAIN_KWARGS = dict(
    epochs=5,              # 기본 100. 도형 세상은 쉬워서 몇 에폭이면 충분하다
    batch_size=2,          # 기본 4. 한 번에 GPU 에 올리는 그림 수 — 8GB GPU 를 나눠 쓰느라 작게 잡았다
    grad_accum_steps=4,    # 기본 1. 기울기를 4번 모아 한 번 갱신 → 실효 배치 크기 2 × 4 = 8
    lr=1e-4,               # 기본 1e-4 (디코더 쪽). 백본은 lr_encoder=1.5e-4 에 층별 감쇠 0.8 이 곱해진다
    num_workers=2,         # 기본 2. 데이터 로더 일꾼 수
    seed=0,
    tensorboard=False,     # 기본 True. 이 실습은 metrics.csv 만 읽는다 (wandb · mlflow 는 기본이 False)
    eval_base_model=True,  # 기본 False(EMA 가중치만 검증). EMA 와 일반 가중치를 둘 다 검증해 비교한다
    compact_train_metrics=False,  # 기본 True(보조 손실을 _aux 하나로 합쳐 기록). 층별 손실을 따로 본다
    progress_bar=None,
)
SCRATCH_EPOCHS = 3  # (b) 무작위 초기화는 3 에폭만 돌린다 (GPU 시간을 아끼려고). 그 밖의 설정은 (a) 와 같다
OUT_PRETRAINED = "ch14_out_pretrained"
OUT_SCRATCH = "ch14_out_scratch"
RESULTS_FILE = "ch14_finetune_results.json"
ch14_finetune.py · train
def finetune(output_dir: str, dataset_dir: str, pretrained: bool, retrain: bool, **overrides) -> dict:
    """RF-DETR Nano 를 dataset_dir 로 미세 조정한다. 돌려주는 값: {"minutes": 걸린 시간, "peak_gib": GPU 메모리 최대}.

    학습을 마치면 같은 값을 output_dir/train_info.json 에 적어 두고, 다음에 부르면 학습을 건너뛰고 그것을 읽는다.

    pretrained=True : RFDETRNano() — COCO 까지 학습된 가중치(rf-detr-nano.pth)에서 시작.
    pretrained=False: RFDETRNano(pretrain_weights=None) — 가중치를 읽지 않는다. Nano 는 패치 16 · 위치 임베딩
                      24×24 라 DINOv2 원본(패치 14)도 읽을 수 없어, 백본까지 전부 무작위 초기화로 시작한다.
    """
    from rfdetr import RFDETRNano

    info_path = os.path.join(output_dir, "train_info.json")
    if os.path.exists(os.path.join(output_dir, "checkpoint_best_total.pth")) and os.path.exists(info_path) and not retrain:
        with open(info_path, encoding="utf-8") as f:
            info = json.load(f)
        print(f"  {output_dir}/ 에 학습 결과가 있어 건너뜀 (--retrain 으로 다시 학습).")
        print(f"  그때의 기록: {info['minutes']:.1f}분, GPU 메모리 최대 {info['peak_gib']:.2f} GiB (torch 가 할당한 양)")
        return info
    model = RFDETRNano() if pretrained else RFDETRNano(pretrain_weights=None)
    if torch.cuda.is_available():
        torch.cuda.reset_peak_memory_stats()
    start = time.time()
    # 클래스 수는 주지 않는다: train() 이 train/_annotations.coco.json 의 categories 를 세어
    # 분류 머리를 (클래스 수 + 1) 칸으로 다시 만든다 (이때 머리의 가중치는 새로 초기화된다).
    model.train(dataset_dir=dataset_dir, output_dir=output_dir, **{**TRAIN_KWARGS, **overrides})
    peak = torch.cuda.max_memory_allocated() / 2**30 if torch.cuda.is_available() else float("nan")
    info = {"minutes": round((time.time() - start) / 60, 1), "peak_gib": round(peak, 2)}
    with open(info_path, "w", encoding="utf-8") as f:
        json.dump(info, f)
    print(f"  학습 끝: {info['minutes']:.1f}분, GPU 메모리 최대 {info['peak_gib']:.2f} GiB (torch 가 할당한 양)")
    return info
- 바깥으로 나가는 것은 없는가
- 설치판의
TrainConfig기본값은wandb=False,mlflow=False,clearml=False이고tensorboard=True뿐이다. TensorBoard 는 출력 폴더에 파일을 쓸 뿐 어디로도 보내지 않는다. 곧 따로 켜지 않는 한 학습 기록이 외부 서비스로 올라가지 않는다. 이 실습은tensorboard=False로 그것마저 끄고, 늘 기록되는metrics.csv만 읽는다. (네트워크를 쓰는 것은 처음에 사전 학습 가중치를 내려받을 때뿐이다.)
주요 인자와 기본값
train() 의 키워드 인자는 그대로 TrainConfig 의 필드가 된다. 아래 기본값은 설치판(1.12.1)의 rfdetr/config.py 에서 읽은 것이다. 이름을 틀리게 쓰면(예: epoch=10) 조용히 무시되지 않고 오류가 난다.
| 인자 | 기본값 | 뜻 | 앞 장 |
| | (필수) | COCO · YOLO 형식 데이터셋 폴더 | 이 장 |
| | | 체크포인트 · 기록을 쓸 폴더 | |
| | 100 | 학습 세트를 몇 바퀴 돌 것인가 | |
| | 4 | 한 번에 GPU 에 올리는 그림 수. | |
| | 1 | 기울기를 몇 번 모아 한 번 갱신할 것인가 | |
| | 1e-4 | 학습률(프로젝터 · 머리 등). 디코더는 여기에 | |
| | 1.5e-4 | 백본(DINOv2)의 기준 학습률. 여기에 층별 감쇠가 곱해짐 | |
| | 0.8 | 층별 학습률 감쇠율 | |
| | 0.7 | 부품(디코더 · 백본)별 학습률 감쇠율 | 이 장 |
| | 1e-4 | 가중치 감쇠(AdamW) | |
| | 0.0 | 학습률 워밍업 길이. 0 = 워밍업 없음 | |
| | 0.1 | 기울기 자르기의 최대 노름 | |
| | True, 0.993, 100 | 가중치의 지수 이동 평균(EMA) | |
| | "per-batch", True | 배치마다 해상도를 바꾸는 다중 스케일 학습 | |
| | 0.0 | 드롭 패스 확률 | |
| | False | 검증 AP 가 오르지 않으면 일찍 멈춤( | 이 장 |
| | 10 | 몇 에폭마다 | |
| | None | 이어서 학습할 체크포인트( | 이 장 |
| | (모델 기본값) | 학습 해상도 바꾸기. | |
| | 2 | 데이터 로더 일꾼(프로세스) 수 | |
| | None | 난수 시드 | |
| | True / False / False | 기록 도구 | |
| | False | 학습이 끝나면 시험 세트도 채점할 것인가 |
손실의 가중치(분류 1, L1 5, GIoU 2), 질의 묶음 수(group_detr=13), IA-BCE 사용 여부(ia_bce_loss=True) 같은 것은 학습 인자가 아니라 모델 설정 쪽에 있고, 보통은 건드리지 않는다. 기본값들을 한 줄로 요약하면 “학습률 1e-4, 워밍업 없음, 기울기 0.1 로 자르기, 층별 감쇠 0.8, EMA 0.993” 으로, 11장 에서 본 논문 부록 A 의 설정과 같다. 학습률 스케줄도 논문의 “스케줄러 없는 학습” 그대로다. 설치판의 기본 스케줄(lr_scheduler="step")은 100 에폭 뒤에야 학습률을 1/10 로 내리는데, 기본 에폭 수가 100 이므로 학습 내내 학습률이 일정하다(이번 실험의 metrics.csv 에서도 일정했다).
실효 배치 크기
GPU 메모리가 작으면 한 번에 올릴 수 있는 그림 수가 적다. 그런데 배치가 너무 작으면 기울기가 그림 몇 장의 사정에 휘둘려 들쭉날쭉해진다. 11장 의 기울기 누적이 이 둘을 떼어 놓는다. 작은 배치로 순전파 · 역전파를 여러 번 하면서 기울기를 더해 두었다가, 한 번에 가중치를 고친다. 가중치를 한 번 고칠 때 본 그림의 수를 실효 배치 크기(effective batch size) 라고 한다.
\(B_{\text{eff}} = B \times A\)
\(B\) 는 batch_size(한 번에 GPU 에 올리는 그림 수), \(A\) 는 grad_accum_steps(기울기를 모으는 횟수), \(B_{\text{eff}}\) 가 실효 배치 크기다. 학습 그림이 \(N_{\text{train}}\) 장이면 한 에폭의 순전파 횟수와 가중치 갱신 횟수는
\(\text{순전파 횟수} = \frac{N_{\text{train}}}{B}, \qquad \text{갱신 횟수} = \frac{N_{\text{train}}}{B \times A} = \frac{N_{\text{train}}}{B_{\text{eff}}}\)
이번 실험에 넣어 본다. \(N_{\text{train}} = 1000\), \(B = 2\), \(A = 4\) 이므로
- 실효 배치 크기 \(B_{\text{eff}} = 2 \times 4 = 8\)
- 한 에폭에 순전파 \(1000 / 2 = 500\) 번, 가중치 갱신 \(1000 / 8 = 125\) 번
- 5 에폭이면 갱신은 모두 \(5 \times 125 = 625\) 번. 실제
metrics.csv의 마지막 줄의step이 624 이다(0 부터 세므로 625 번째).
메모리는 \(B\) 만 따라간다. batch_size=2 일 때 이번 학습이 쓴 GPU 메모리는 최대 1.61 GiB 였다. 같은 실효 배치 8 을 batch_size=8, grad_accum_steps=1 로 만들면 갱신 한 번의 내용은 (거의) 같지만 메모리는 몇 배가 든다.
- 배치를 어떻게 정할까
-
- 문서의 권고는 “먼저
batch_size를 GPU 에 들어가는 만큼 키우고, 그래도 모자랄 때만grad_accum_steps를 올리라” 이다. 누적은 메모리를 아껴 줄 뿐 시간을 아껴 주지는 않는다. -
batch_size="auto"(CUDA 전용)는 GPU 를 시험해 들어가는 배치를 찾고, 실효 배치가 16(auto_batch_target_effective의 기본값)에 닿도록 누적 횟수를 정한다. 이 장에서는 GPU 를 다른 작업과 나눠 쓰느라 쓰지 않았다. - RF-DETR 이 누적에 잘 견디는 것은 10장 에서 본 선택 덕분이다. 프로젝터의 배치 정규화를 층 정규화 로 바꿨기 때문에, 배치가 2장뿐이어도 정규화 통계가 흔들리지 않는다.
- 문서의 권고는 “먼저
부품마다 다른 학습률
“학습률 1e-4” 라고 했지만 모든 가중치가 그 값으로 배우는 것은 아니다. 설치판의 training/param_groups.py 와 models/backbone/backbone.py 를 읽어 보면 부품마다 이렇게 정해진다. \(\eta\) 는 lr, \(\eta_{\text{enc}}\) 는 lr_encoder, \(\rho\) 는 lr_component_decay(0.7), \(\lambda\) 는 lr_vit_layer_decay(0.8), \(L\) 은 백본에서 쓰는 블록 수에 1 을 더한 값(Nano 는 13), \(j\) 는 백본 블록 번호(0 – 11)이다.
| 부품 | 학습률 | Nano 기본값에서 |
| 프로젝터, 분류 · 박스 머리, 질의 임베딩 등 | \(\eta\) | \(1.0 \times 10^{-4}\) |
| 디코더 | \(\eta \cdot \rho\) | \(10^{-4} \times 0.7 = 7.0 \times 10^{-5}\) |
| 백본의 블록 \(j\) | \(\eta_{\text{enc}} \cdot \lambda^{\,L - j} \cdot \rho^2\) | 블록 11: \(4.70 \times 10^{-5}\) … 블록 0: \(4.04 \times 10^{-6}\) |
| 백본의 패치 · 위치 임베딩 | \(\eta_{\text{enc}} \cdot \lambda^{\,L + 1} \cdot \rho^2\) | \(3.23 \times 10^{-6}\) |
- 손으로 계산 — 백본 맨 위 블록과 맨 아래 임베딩의 학습률
\(\eta_{\text{enc}} \cdot \rho^2 = 1.5 \times 10^{-4} \times 0.7^2 = 1.5 \times 10^{-4} \times 0.49 = 7.35 \times 10^{-5}\)
백본 전체에 공통으로 곱해지는 부분이다. 부품 감쇠 0.7 이 디코더에는 한 번, 백본에는 두 번 곱해진다(출력에서 멀수록 작게).
\(\text{블록 } 11:\quad 7.35 \times 10^{-5} \times 0.8^{\,13 - 11} = 7.35 \times 10^{-5} \times 0.64 = 4.70 \times 10^{-5}\)
마지막 블록(\(j = 11\))은 감쇠가 두 번만 곱해진다.
\(\text{블록 } 0:\quad 7.35 \times 10^{-5} \times 0.8^{13} = 7.35 \times 10^{-5} \times 0.05498 = 4.04 \times 10^{-6}\)
첫 블록은 13번. \(0.8^{13} = 0.05498\) 이다(\(0.8^2 = 0.64\), \(0.8^4 = 0.4096\), \(0.8^8 = 0.16777\), \(0.8^{13} = 0.8^8 \cdot 0.8^4 \cdot 0.8 = 0.05498\)).
\(\text{임베딩}:\quad 7.35 \times 10^{-5} \times 0.8^{14} = 7.35 \times 10^{-5} \times 0.04398 = 3.23 \times 10^{-6}\)
패치 임베딩 · 위치 임베딩은 한 번 더 곱해져 가장 작다. 머리(1e-4)의 약 1/31 이다.
이 손계산은 실제 학습 기록과 맞다. metrics.csv 에는 옵티마이저의 매개변수 묶음 가운데 가장 큰 학습률과 가장 작은 학습률이 기록되는데, 이번 실행에서 lr_max 0.0001, lr_min 3.233e-06 이었다(뒤의 실행 출력). 위 표의 맨 윗줄과 맨 아랫줄이다.
왜 이렇게 할까? 11장 의 층별 학습률 감쇠 그대로다. 백본의 아래층은 DINOv2 가 1억 장이 넘는 그림에서 배운 “모서리 · 질감 · 모양” 같은 일반 지식을 담고 있어 조금만 고치는 것이 안전하고, 새로 만든 머리는 우리 데이터에 맞게 크게 고쳐야 한다. 미세 조정에서 사전 학습의 지식을 지키는 장치다.
머리 재초기화 경고
학습을 시작하면 로그에 이런 경고가 한 줄 지나간다.
[WARNING] rf-detr - Checkpoint has 90 classes but model is configured for 3. The detection head will be re-initialized to 3 classes.
오류가 아니라 바라던 일이 일어났다는 알림 이다. 사전 학습 가중치의 분류 머리는 COCO 용 91칸인데 우리 데이터의 클래스는 3개이다. 패키지는 데이터셋의 categories 를 세어 num_classes 를 3 으로 맞추고, 분류 머리를 클래스 수 + 1 = 4칸 짜리로 새로 만든다(reinitialize_detection_head). 미세 조정을 마친 모델의 머리를 찍어 보면 Linear(in_features=256, out_features=4, bias=True) 이다(뒤의 실행 출력).
- “다시 초기화” 의 실제 내용. 경고문만 보면 새 머리가 무작위 값으로 채워질 것 같지만, 설치판의 소스(
_resize_linear)는 그렇게 하지 않는다. 원래 머리의 91개 행 가운데 앞의 4개 행을 잘라 와 새 머리로 쓴다(클래스가 91개보다 많으면 반대로 행을 되풀이해 이어 붙인다). 직접 확인해 보면RFDETRNano(num_classes=3)의 분류 머리 가중치는 COCO 모델 머리의 0 – 3번 행과 차이가 정확히 0 이었고, 편향은 −4.4 ~ −4.7 로 10장 에서 본 “사전 확률 0.01” 초기화값 \(-\log(0.99/0.01) = -4.595\) 근처였다. 곧 우리의 “원” 은 COCO 의 쓰이지 않는 0번 칸에서, “사각형” 은 person 칸에서, “삼각형” 은 bicycle 칸에서 출발한다. 도형과 아무 상관 없는 값이므로 실질적으로는 새로 배워야 하는 머리 라는 점은 같다. 머리 아래의 모든 것(백본 · 프로젝터 · 디코더 · 박스 머리)은 사전 학습 가중치 그대로다. - 남는 한 칸(마지막 칸)은 쓰이지 않는 자리다. 정답이 그 칸을 가리키는 일이 없으므로 학습하면서 점수가 0 에 가까워진다. 다만
predict(threshold=0.0)처럼 문턱값을 아예 없애면 그 칸의 예측(class_id= 3)도 딸려 나온다. 그래서detections_to_prediction에num_classes로 걸러 내는 줄을 두었다. - 모델을 만들 때
RFDETRNano(num_classes=5)처럼 클래스 수를 직접 주면, 데이터셋과 달라도 내가 준 값이 유지 되고 경고만 나온다(소스의_align_num_classes_from_dataset). 특별한 이유가 없으면 주지 말고 패키지가 세게 두라.
학습 로그의 손실 이름
에폭이 끝날 때마다 출력 폴더의 metrics.csv 에 학습 손실과 검증 지표가 한 줄씩 쌓인다. 열 이름을 읽을 줄 알면 지금 모델의 어느 부분이 어떻게 배우고 있는지 보인다. 기본 설정(compact_train_metrics=True)에서는 보조 손실이 loss_ce_aux 처럼 하나로 합쳐져 기록되므로, 이 실습은 그것을 끄고 층별로 받았다.
| 열 이름( | 무엇인가 | 가중치 | 앞 장 |
| | 분류 손실. 이름은 ce(cross-entropy)지만 실제로는 IA-BCE( | 1 | |
| | 매칭된 예측 박스와 정답 박스의 L1 거리(정규화 좌표) | 5 | |
| | \(1 - \operatorname{GIoU}\) | 2 | |
| | 보조 손실: 디코더의 0번째(첫) 층 출력에 같은 손실을 건 것. Nano 는 디코더가 2층이라 | 같음 | |
| | 2단계 질의 선택에서 인코더(프로젝터) 출력이 낸 제안 에 건 손실. 디코더를 거치기 전의 예측이다 | 같음 | |
| | 위 9개를 가중치를 곱해 모두 더한 값. 역전파되는 것은 이 숫자 하나 | ||
| | 참고용 지표(손실에 들어가지 않음). 매칭된 질의의 클래스 오답률(%), 그리고 “점수 0.5 를 넘는 질의 수 − 정답 객체 수” 의 절댓값 | – | |
| | 학습률(앞 절) | – |
전체 손실은 식으로 쓰면 다음과 같다. \(\ell\) 은 손실을 거는 자리(마지막 디코더 층, 디코더 0층, 인코더 제안)를 가리키는 첨자다.
\(\mathcal{L} = \sum_{\ell \,\in\, \{\text{마지막},\ 0,\ \text{enc}\}} \Big( 1 \cdot \mathcal{L}^{(\ell)}_{\text{ce}} + 5 \cdot \mathcal{L}^{(\ell)}_{\text{bbox}} + 2 \cdot \mathcal{L}^{(\ell)}_{\text{giou}} \Big)\)
\(\mathcal{L}^{(\ell)}_{\text{ce}}\), \(\mathcal{L}^{(\ell)}_{\text{bbox}}\), \(\mathcal{L}^{(\ell)}_{\text{giou}}\) 가 자리 \(\ell\) 의 분류 · L1 · GIoU 손실이다. 기록된 값으로 이 식이 맞는지 확인할 수 있다. 첫 에폭의 값을 넣어 보면
- 분류: \(0.4325 + 0.7244 + 0.6895 = 1.8464\)
- L1: \(5 \times (0.0181 + 0.0198 + 0.0558) = 5 \times 0.0937 = 0.4685\)
- GIoU: \(2 \times (0.0515 + 0.0556 + 0.1499) = 2 \times 0.2570 = 0.5140\)
- 합: \(1.8464 + 0.4685 + 0.5140 = 2.8289\). 기록된
loss는 2.8288 이다(넷째 자리의 차이는 반올림). ✓
세 자리의 손실을 나란히 보는 것만으로도 구조가 읽힌다. 같은 에폭에서 분류 손실은 인코더 제안(0.6895)과 디코더 0층(0.7244)보다 마지막 층(0.4325)이 작고, 박스 손실은 인코더 제안(0.0558)이 디코더 층들(0.0198, 0.0181)의 약 세 배이다. 인코더의 거친 제안을 디코더가 층을 거치며 다듬는다는 8장 · 10장 의 그림 그대로다.
에폭별 결과
이제 실제로 돌린 결과다. 사전 학습 가중치에서 시작해 도형 세상 1,000장으로 5 에폭 학습했다. 아래는 metrics.csv 를 읽어 에폭마다 한 줄로 정리한 것이다(패키지가 화면에 찍는 긴 로그는 생략했다). 학습을 마친 뒤 그림을 다시 그리려고 한 번 더 실행한 출력이라 “건너뜀” 줄이 보인다. 처음 실행할 때는 그 자리에서 학습이 돌고 학습 끝: 18.2분, GPU 메모리 최대 1.61 GiB 가 찍힌다.
ch14_finetune.py · read-metrics
def read_metrics(output_dir: str) -> list[dict]:
    """output_dir/metrics.csv 를 에폭별 사전의 목록으로 읽는다.

    Lightning 의 CSV 기록은 에폭마다 두 줄(검증 지표 줄, 학습 손실 줄)을 쓰고 빈 칸은 비워 둔다.
    같은 에폭의 두 줄을 하나로 합친다. 열 이름은 "train/loss_ce", "val/mAP_50_95" 같은 식이다.
    """
    epochs: dict[int, dict] = {}
    with open(os.path.join(output_dir, "metrics.csv"), encoding="utf-8") as f:
        for row in csv.DictReader(f):
            merged = epochs.setdefault(int(row["epoch"]), {"epoch": int(row["epoch"])})
            for key, value in row.items():
                if key not in ("epoch", "step") and value not in ("", None):
                    merged[key] = float(value)
    return [epochs[k] for k in sorted(epochs)]
[2] 미세 조정 (a) 사전 학습 가중치에서 시작 → ch14_out_pretrained/
  설정: epochs=5, batch_size=2, grad_accum_steps=4, lr=0.0001, num_workers=2, seed=0, tensorboard=False, eval_base_model=True, compact_train_metrics=False, progress_bar=None
  ch14_out_pretrained/ 에 학습 결과가 있어 건너뜀 (--retrain 으로 다시 학습).
  그때의 기록: 18.2분, GPU 메모리 최대 1.61 GiB (torch 가 할당한 양)
  metrics.csv 의 손실 열: loss, loss_bbox, loss_bbox_0, loss_bbox_enc, loss_ce, loss_ce_0, loss_ce_enc, loss_giou, loss_giou_0, loss_giou_enc
  에폭 | loss    | loss_ce loss_bbox loss_giou | loss_ce_0 loss_ce_enc | val AP(일반) AP(EMA) AP50(EMA)
     1 |   2.829 |   0.433    0.0181    0.0515 |     0.724       0.689 |      0.9417  0.9476    0.9998
     2 |   2.072 |   0.243    0.0177    0.0524 |     0.464       0.440 |      0.9772  0.9792    1.0000
     3 |   1.530 |   0.189    0.0138    0.0419 |     0.349       0.328 |      0.9754  0.9816    0.9999
     4 |   1.425 |   0.182    0.0136    0.0409 |     0.278       0.321 |      0.9808  0.9832    0.9999
     5 |   1.513 |   0.178    0.0131    0.0394 |     0.348       0.327 |      0.9822  0.9839    0.9999
  첫 에폭의 손실 항목: loss 2.8288, loss_bbox 0.0181, loss_bbox_0 0.0198, loss_bbox_enc 0.0558, loss_ce 0.4325, loss_ce_0 0.7244, loss_ce_enc 0.6895, loss_giou 0.0515, loss_giou_0 0.0556, loss_giou_enc 0.1499
  cardinality_error (에폭별): 25.09, 28.98, 29.23, 29.03, 29.19 | lr_max 0.0001 lr_min 3.233e-06
  check: 1·Σloss_ce + 5·Σloss_bbox + 2·Σloss_giou = 1.513  vs  기록된 loss = 1.513
  출력 폴더: checkpoint_best_ema.pth (121 MB), checkpoint_best_regular.pth (242 MB), checkpoint_best_total.pth (121 MB), last.ckpt (483 MB), last_ema.pth (121 MB), metrics.csv, train_info.json, training_config.json
- 첫 에폭에 이미 끝나 있다. 가중치를 125번 고친 뒤의 검증 AP 가 0.9417(일반 가중치), 0.9476(EMA 가중치)이고 AP50 은 0.9998 이다. 미세 조정 전에는 도형을 냉장고라 부르던 모델이다. 5 에폭 뒤에는 0.9822 / 0.9839 이다.
- AP50 은 1 에 붙어 있고 AP 는 0.98 근처에서 천천히 오른다. 3장 에서 본 것처럼 AP@[.50:.95] 는 IoU 문턱값 0.95 까지 평균한 값이다. “대충 맞는 박스”(IoU 0.5)는 첫 에폭부터 거의 전부 맞고, 남은 차이는 “IoU 0.9 를 넘길 만큼 꼭 맞는가” 에서 난다. 박스 손실(
loss_bbox0.0181 → 0.0131,loss_giou0.0515 → 0.0394)이 조금씩 줄어드는 것이 그 과정이다. - EMA 가중치가 매번 조금 더 좋다(0.9476 대 0.9417, 0.9792 대 0.9772, …, 0.9839 대 0.9822). 차이는 0.002 – 0.006 으로 작지만 다섯 에폭 모두 같은 방향이다. 11장 에서 본 대로, 여러 스텝의 가중치를 평균하면 한 스텝 한 스텝의 흔들림이 지워진다. 일반 가중치의 AP 는 3 에폭에서 한 번 내려갔지만(0.9772 → 0.9754) EMA 쪽은 내려간 적이 없다.
- 전체 손실은 4 → 5 에폭에서 오히려 올랐다(1.425 → 1.513). 보조 손실
loss_ce_0이 0.278 → 0.348 로 튄 탓이다. 그런데 검증 AP 는 계속 올랐다. 학습 손실은 배치마다 해상도가 바뀌는 다중 스케일 · 증강이 걸린 값이고, 에폭 하나의 평균이 조금 오르내리는 것은 흔한 일이다. 모델을 고르는 기준은 학습 손실이 아니라 검증 AP 이다. - cardinality_error 가 29 근처인 까닭. 출력에는 싣지 않았지만
metrics.csv의 이 열은 2 에폭부터 29.0 – 29.2 에 머문다. 고장이 아니다. 학습 때는 9장 의 Group DETR 로 질의 묶음 13개가 함께 돌고, 묶음마다 객체 하나에 예측 하나씩을 낸다. 그림 한 장의 객체가 평균 \(2442/1000 = 2.44\) 개이므로 점수 0.5 를 넘는 질의는 약 \(13 \times 2.44\) 개, 정답 수와의 차이는 \(12 \times 2.44 = 29.3\) 이다. 관측값과 맞다. Group DETR 이 실제로 돌고 있다는 것을 로그 숫자 하나로 확인한 셈이다.
사전 학습의 힘
이렇게 쉽게 되는 것이 모델 구조 덕분일까, 사전 학습 덕분일까? 가려내는 방법은 하나다. 똑같은 설정으로, 사전 학습 가중치만 빼고 학습해 보는 것이다. RFDETRNano(pretrain_weights=None) 으로 만들면 가중치 파일을 읽지 않는다. 이때 패키지는 “Using patch size 16 instead of 14, which means we're not loading DINOv2 backbone weights and the backbone starts from random initialization” 이라고 알려 준다. Nano 는 패치가 16 이라 DINOv2 원본(패치 14)을 그대로 읽을 수도 없어서, 백본부터 머리까지 전부 무작위 초기화 로 시작한다. GPU 시간을 아끼려고 이 실행은 3 에폭만 돌렸다. 에폭 수 말고는 설정이 모두 같고 학습률도 내내 일정하므로, 같은 에폭끼리 견주면 공정한 비교다.
[3] 미세 조정 (b) 무작위 초기화에서 시작 (epochs=3, 나머지 설정은 같음) → ch14_out_scratch/
  ch14_out_scratch/ 에 학습 결과가 있어 건너뜀 (--retrain 으로 다시 학습).
  그때의 기록: 8.5분, GPU 메모리 최대 1.61 GiB (torch 가 할당한 양)
  metrics.csv 의 손실 열: loss, loss_bbox, loss_bbox_0, loss_bbox_enc, loss_ce, loss_ce_0, loss_ce_enc, loss_giou, loss_giou_0, loss_giou_enc
  에폭 | loss    | loss_ce loss_bbox loss_giou | loss_ce_0 loss_ce_enc | val AP(일반) AP(EMA) AP50(EMA)
     1 |   9.972 |   0.776    0.2797    0.5711 |     0.760       0.733 |      0.3384  0.3244    0.5972
     2 |   6.901 |   0.848    0.1534    0.3076 |     0.875       1.018 |      0.6059  0.6342    0.8311
     3 |   5.782 |   0.758    0.1173    0.2154 |     0.804       0.988 |      0.7532  0.7749    0.8902
  첫 에폭의 손실 항목: loss 9.9724, loss_bbox 0.2797, loss_bbox_0 0.2865, loss_bbox_enc 0.2747, loss_ce 0.7758, loss_ce_0 0.7599, loss_ce_enc 0.7331, loss_giou 0.5711, loss_giou_0 0.5793, loss_giou_enc 0.5989
  cardinality_error (에폭별): 2.52, 9.58, 18.62 | lr_max 0.0001 lr_min 3.233e-06
  check: 1·Σloss_ce + 5·Σloss_bbox + 2·Σloss_giou = 5.782  vs  기록된 loss = 5.782
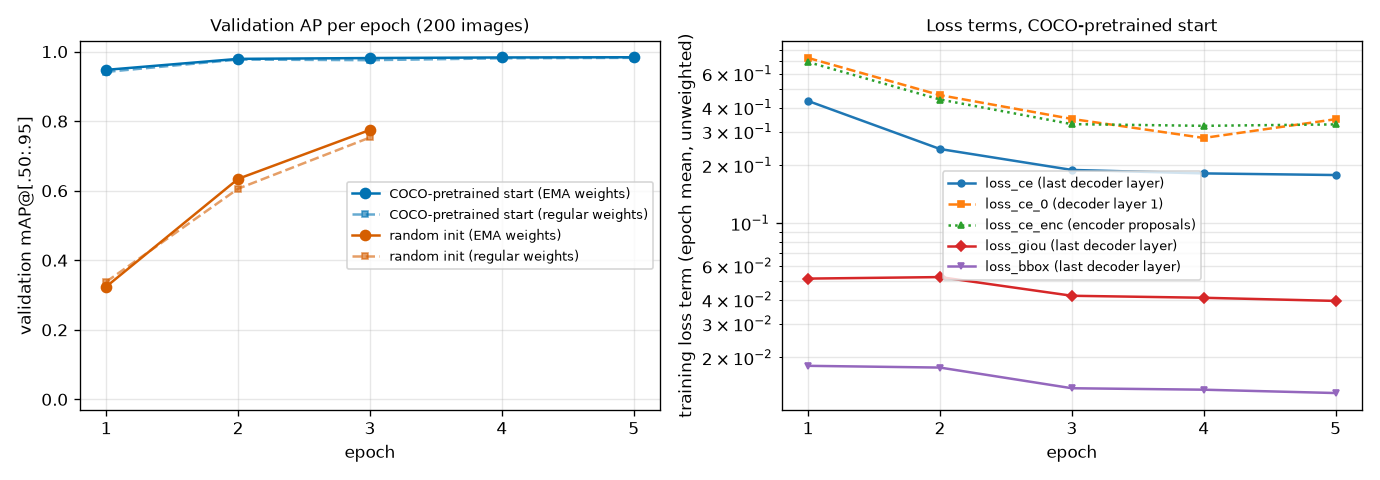
왼쪽은 에폭별 검증 AP@[.50:.95] 이다. 파랑은 사전 학습 가중치에서 시작, 주황은 무작위 초기화이고, 실선은 EMA 가중치, 점선은 일반 가중치다. 오른쪽은 사전 학습 시작 실행의 손실 항목별 곡선(가중치를 곱하기 전, 세로축 로그 눈금)이다.
두 실행을 같은 에폭끼리 나란히 놓으면 이렇다(검증 AP@[.50:.95], EMA 가중치).
| 에폭(갱신 횟수) | (a) 사전 학습에서 시작 | (b) 무작위 초기화에서 시작 | (b) 의 AP50 |
| 1 (125) | 0.9476 | 0.3244 | 0.5972 |
| 2 (250) | 0.9792 | 0.6342 | 0.8311 |
| 3 (375) | 0.9816 | 0.7749 | 0.8902 |
| 5 (625) | 0.9839 | (돌리지 않음) |
- 사전 학습 모델의 1 에폭이 무작위 초기화의 3 에폭을 크게 앞선다(0.948 대 0.775). 그림 14-4 왼쪽에서 파란 선은 처음부터 천장에 붙어 있고 주황 선은 바닥에서 올라오는 중이다.
- 차이는 박스에서 가장 크다. 첫 에폭의
loss_bbox가 (a) 0.0181, (b) 0.2797 로 15배,loss_giou가 0.0515 대 0.5711 로 11배이다. (a) 는 “물체에 박스를 두르는 법” 을 이미 알고 시작해 이름표만 새로 배우면 되고, (b) 는 모서리가 무엇인지부터 배워야 한다. (b) 의 AP50(0.89)과 AP(0.77)의 틈이 (a) 보다 훨씬 큰 것도 같은 이야기다 — 찾기는 하지만 꼭 맞게 두르지는 못한다. - 그래도 (b) 가 꽤 올라온다는 점도 정직하게 봐야 한다. 3 에폭, 가중치 갱신 375번 만에 0.77 이고 아직 오르는 중이다. 더 돌리면 틈은 더 좁혀질 것이다. 도형 세상이 그만큼 쉬운 데이터이기 때문이다(단색 배경, 뚜렷한 색, 세 클래스). 사진처럼 복잡한 데이터에서는 이야기가 다르다. LW-DETR 논문은 Objects365 사전 학습이 COCO 에서 +8.7 mAP 를 준다고 보고했고, RF-DETR 논문이 백본을 DINOv2 로 바꾼 이유도 “작은 데이터셋에서의 정확도” 였다(6장, 10장). 이 실험이 보여 주는 것은 그 크기가 아니라 방향이다: 같은 데이터 · 같은 시간이면 사전 학습에서 시작하는 쪽이 훨씬 멀리 간다.
- EMA 가 늘 이기는 것은 아니다. (b) 의 첫 에폭에서는 EMA 가중치(0.3244)가 일반 가중치(0.3384)보다 나쁘다. 모델이 빠르게 좋아지는 중에는 “지난 가중치들의 평균” 이 지금의 가중치보다 뒤처지기 때문이다. 2 · 3 에폭에서는 다시 EMA 가 앞선다(0.6342 대 0.6059, 0.7749 대 0.7532). 패키지가
checkpoint_best_total.pth를 만들 때 둘 가운데 나은 쪽을 고르는 이유다. - (b) 의 분류 손실
loss_ce는 0.776 → 0.848 → 0.758 로 거의 줄지 않는데 AP 는 오른다. 9장 의 IA-BCE 는 분류의 목표값을 예측 박스의 IoU 에 묶어 두므로, 박스가 좋아질수록 목표도 함께 높아진다. 손실 값 하나만으로 학습이 잘되는지 판단하기 어렵다는 점을 다시 보여 준다. - 학습 시간은 (a) 5 에폭에 18.2분, (b) 3 에폭에 8.5분이었고 GPU 메모리는 둘 다 최대 1.61 GiB 였다. 이 GPU 는 다른 학습 작업 여럿과 나눠 쓰는 중이었으므로 시간은 참고만 하라. 혼자 쓰면 더 빠르다.
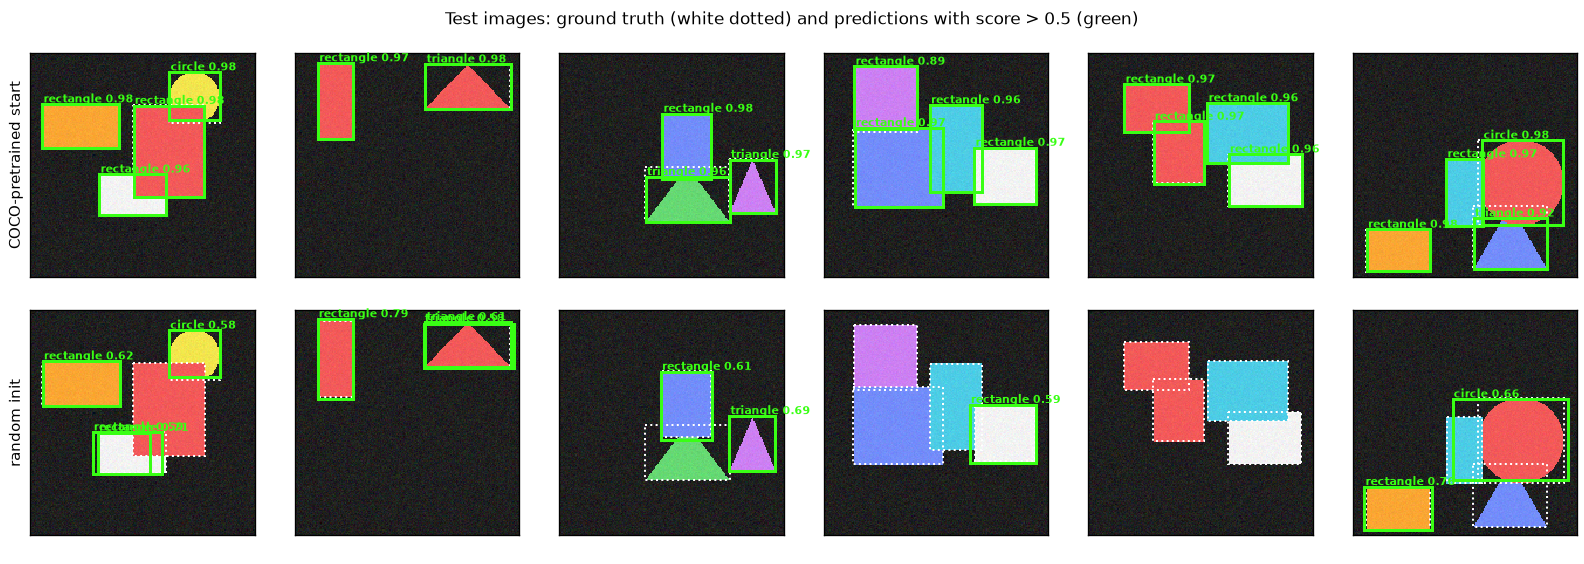
시험 그림 여섯 장(그림 14-2 와 같은 그림). 흰 점선이 정답, 초록 실선이 점수 0.5 를 넘는 예측이다. 위 줄은 사전 학습 가중치에서 시작한 모델, 아래 줄은 무작위 초기화에서 시작한 모델이다.
- 위 줄(사전 학습에서 시작). 여섯 장의 모든 도형에 박스가 하나씩, 정답(흰 점선)과 거의 겹쳐 그려졌고 점수는 0.89 – 0.98 이다. 서로 겹친 도형(넷째 · 다섯째 그림)도 따로따로 잡았다. 그림 14-2 에서 같은 그림들에 냉장고 · TV 라고 답하던 모델이 1,000장 · 18분의 미세 조정으로 여기까지 왔다.
- 아래 줄(무작위 초기화). 점수가 0.5 를 넘는 예측이 적고(다섯째 그림에는 하나도 없다) 넘더라도 0.5 – 0.8 사이로 낮다. 첫째 그림의 흰 사각형과 둘째 그림의 삼각형에는 박스가 두 개씩 겹쳐 그려졌다. “객체 하나에 예측 하나” 라는, 헝가리안 매칭이 가르치는 규칙(7장)을 아직 다 배우지 못한 모습이다. 여섯째 그림에서는 원의 박스가 옆의 사각형 쪽으로 넓게 퍼졌다.
- 아래 줄의 모델도 시험 AP 는 0.77 이다(다음 절). AP 는 점수의 순서 만 보기 때문에 점수가 전체적으로 낮아도 높게 나올 수 있다. 문턱값 0.5 로 잘라 쓰는 실제 사용에서는 그림처럼 많이 놓친다. 지표와 눈으로 본 결과를 함께 봐야 하는 이유다.
출력 폴더와 체크포인트
학습이 끝나면 output_dir 에 파일이 여럿 남는다. 학습 도중이나 끝의 가중치를 저장한 파일을 체크포인트(checkpoint) 라고 한다. 위 출력의 출력 폴더 줄에 나온 파일들을 열어 보고 정리한 것이 아래 표이다.
| 파일 | 크기 | 들어 있는 것 | 쓰임 |
| | 121 MB | 검증 AP 가 가장 좋았던 가중치. 일반과 EMA 가운데 더 나은 쪽(이번에는 EMA) + 모델 설정 · 클래스 이름 | 추론 · 내보내기용. 보통 이것만 있으면 된다 |
| | 121 MB | EMA 가중치의 검증 AP 가 가장 좋았던 에폭의 EMA 가중치 | 위 파일의 재료 |
| | 242 MB | 일반 가중치의 검증 AP 가 가장 좋았던 에폭의 일반 가중치(EMA 사본도 함께 들어 있어 큼) | 위 파일의 재료. |
| | 483 MB | 마지막 에폭의 일반 가중치(121) + EMA 가중치(121) + 옵티마이저 상태(241) | 학습 재개용 |
| | 121 MB | 마지막 에폭의 EMA 가중치 | |
| | 에폭별 손실 · 검증 지표 | 학습 곡선 그리기 | |
| | 이번 학습의 모든 설정과 클래스 이름 | 재현 · 기록 |
- 크기가 말해 주는 것. 가중치 한 벌이 121 MB 이다(매개변수 약 3,015만 개 × 4바이트).
last.ckpt가 그 네 배인 것은 AdamW 가 매개변수마다 값 두 개(기울기의 이동 평균과 기울기 제곱의 이동 평균, 4장)를 기억하기 때문이다. 옵티마이저 상태가 가중치의 두 배(241 MB)이다. - 학습이 끝난 뒤에는
rfdetr.from_checkpoint("…/checkpoint_best_total.pth")로 읽는다. 체크포인트에 모델 종류가 적혀 있어 알맞은 클래스(RFDETRNano)를 스스로 골라 주고, 클래스 이름도 복원된다.train()을 부른 그model객체로도 바로predict할 수 있지만, 다른 프로그램 · 다른 날에 다시 쓰려면 이 방법이 기본이다. -
checkpoint_<에폭>.ckpt는checkpoint_interval(기본 10) 에폭마다 남는다. 5 에폭짜리 이번 실행에는 없다. -
train_info.json은 패키지가 아니라 이 실습 코드가 걸린 시간과 메모리를 적어 둔 파일이다.
ch14_finetune.py · load
def load_finetuned(output_dir: str = OUT_PRETRAINED):
    """학습이 남긴 checkpoint_best_total.pth 를 읽어 추론할 수 있는 모델을 돌려준다.

    rfdetr.from_checkpoint 는 체크포인트에 적힌 모델 종류 · 해상도 · 클래스 이름을 읽어 알맞은 클래스(RFDETRNano)를
    스스로 고른다. 검증 AP 가 가장 좋았던 가중치(일반과 EMA 가운데 나은 쪽)가 들어 있다.
    """
    import rfdetr

    return rfdetr.from_checkpoint(os.path.join(output_dir, "checkpoint_best_total.pth"))
“EMA 가중치” 가 어떻게 만들어지는지도 설치판의 소스에서 확인할 수 있다. 가중치를 한 번 갱신할 때마다
\(\theta_{\text{EMA}} \leftarrow d_t\, \theta_{\text{EMA}} + (1 - d_t)\, \theta, \qquad d_t = d \cdot \big(1 - e^{-t/\tau_{\text{EMA}}}\big)\)
\(\theta\) 는 지금의 (일반) 가중치, \(\theta_{\text{EMA}}\) 는 EMA 가중치, \(t\) 는 지금까지의 갱신 횟수, \(d\) 는 ema_decay(0.993), \(\tau_{\text{EMA}}\) 는 ema_tau(100), \(d_t\) 는 \(t\) 번째 갱신의 실효 감쇠율이다. 11장 의 EMA 에 “처음에는 빨리 따라가게 하는” 보정이 붙은 꼴이다. \(t = 100\) 이면 \(d_t = 0.993 \times (1 - e^{-1}) = 0.993 \times 0.632 = 0.628\), 이번 실험의 마지막인 \(t = 625\) 이면 \(d_t = 0.993 \times (1 - e^{-6.25}) = 0.993 \times 0.998 = 0.991\) 이다. \(d_t\) 가 0.993 에 다가가면 EMA 는 대략 최근 \(1/(1 - 0.993) \approx 143\) 번의 갱신을 평균한 가중치가 된다. 이번 실험의 한 에폭(125번)보다 조금 긴 길이다.
조기 종료와 학습 재개
에폭 수를 넉넉히 잡아 두면 어느 순간부터 검증 AP 가 오르지 않는다. 그때 학습을 멈춰 시간을 아끼는 것이 조기 종료(early stopping) 이다. 설치판에서는 train(…, early_stopping=True) 로 켠다(기본은 꺼져 있다). 문서에 따르면 검증 AP(탐지는 val/mAP_50_95)가 early_stopping_patience(기본 10) 에폭 동안 early_stopping_min_delta(기본 0.001) 넘게 오르지 않으면 멈춘다. 이번 실험처럼 5 에폭짜리 학습에서는 쓸 일이 없어 돌려 보지는 않았다. 조기 종료를 쓰든 안 쓰든 checkpoint_best_total.pth 에는 검증 AP 가 가장 좋았던 가중치가 남으므로, “너무 오래 학습해서 나빠진 모델” 을 쓰게 될 걱정은 없다.
학습이 중간에 끊겼거나 에폭을 더 돌리고 싶으면 resume 에 last.ckpt 를 준다.
model = RFDETRNano()
model.train(dataset_dir="ch14_shapes_coco", output_dir="ch14_out_pretrained",
            epochs=8,                                   # 전체 에폭 수 (이미 돈 5 에폭 포함)
            resume="ch14_out_pretrained/last.ckpt",     # 가중치 · 옵티마이저 상태 · 에폭 번호를 이어받는다
            batch_size=2, grad_accum_steps=4)
-
epochs는 “더 돌릴 에폭 수” 가 아니라 전체 에폭 수 이다. 작은 데이터셋(60장)으로 확인해 보았다.epochs=1로 학습한 뒤 같은 출력 폴더에서resume=…/last.ckpt, epochs=2로 다시 부르니 둘째 에폭만 더 돌았고,metrics.csv에는 에폭 0(스텝 14)과 에폭 1(스텝 29)이 이어서 남았다. - 이어받을 수 있는 것은 옵티마이저 상태까지 든
last.ckpt(와checkpoint_<에폭>.ckpt)이다. 문서에 따르면 가벼운.pth파일들은 옵티마이저 상태가 없어, 그것으로 재개하면 가중치만 이어받는다. -
resume없이 학습을 마친model로train()을 또 부르면 이어서 학습하는 것이 아니다. 소스에 따르면 처음의 사전 학습 가중치에서 다시 시작하고, 그렇다는 경고를 낸다.
평가
패키지의 evaluate
검증 세트의 AP 는 가장 좋은 체크포인트를 고르는 데 이미 썼으므로, 최종 성적은 한 번도 보지 않은 시험 세트 로 매긴다(3장). 패키지에서는 model.evaluate(dataset_dir=…, split="test") 한 줄이고, 지표의 사전을 돌려준다.
| 돌려주는 키 | 뜻 | 3장의 이름 |
| | IoU 문턱값 0.50, 0.55, …, 0.95 의 AP 를 평균하고 클래스에 대해 평균한 값. COCO 의 대표 지표 | AP(= AP@[.50:.95], mAP) |
| | IoU 문턱값 0.5 하나만 쓴 AP | AP50 |
| | IoU 문턱값 0.75 하나만 쓴 AP | AP75 |
| | 그림당 예측을 500개( | 재현율의 평균 |
| | 점수 문턱값을 여러 값으로 훑어(sweep) F1 이 가장 좋은 지점에서의 F1 · 정밀도 · 재현율 | 정밀도 · 재현율 |
| | 시험 세트에서의 손실 |
이름은 mAP 지만 정의는 3장에서 손으로 계산한 것과 같다. 클래스마다 예측을 점수순으로 늘어놓아 정밀도 – 재현율 곡선을 그리고, 재현율 101개 지점에서 보간한 정밀도를 평균하고, 그것을 IoU 문턱값 10개와 클래스에 대해 평균한다. 계산은 COCO 공식 채점기(pycocotools)와 같은 결과를 내는 채점 라이브러리가 맡는다.
3장의 채점기와 맞대어 보기
패키지가 내놓는 숫자를 그냥 믿지 않고, 같은 모델의 예측을 우리 evaluate_ap 로 직접 채점해 견주어 본다. predict(threshold=0.0) 으로 그림마다 예측을 모두 받아 2장 형식으로 바꾸고(detections_to_prediction), load_coco_split 으로 읽은 정답과 함께 넣는다.
ch14_finetune.py · evaluate
def evaluate_both(model, dataset_dir: str, test_paths, test_targets) -> dict:
    """같은 모델 · 같은 시험 세트를 (가) 패키지의 evaluate() 와 (나) 3장의 evaluate_ap 로 채점한다."""
    # (가) 패키지: COCO 방식 채점기로 mAP@[.50:.95], [email protected], [email protected], mAR 등을 돌려준다.
    package = model.evaluate(dataset_dir=dataset_dir, split="test", batch_size=2, num_workers=2, progress_bar=None)
    # (나) 우리 것: predict 로 예측을 모두 받아(문턱값 0 → 그림마다 num_select 개) 직접 채점.
    predictions = predict_all(model, test_paths, threshold=0.0, num_classes=NUM_CLASSES)
    ours = evaluate_ap(predictions, test_targets, NUM_CLASSES)                    # 그림당 상위 100개 (3장 기본값)
    ours_500 = evaluate_ap(predictions, test_targets, NUM_CLASSES, max_dets=500)  # 패키지처럼 500개까지
    return {"package": package, "ours": ours, "ours_500": ours_500, "predictions": predictions}
[4] 시험 세트 채점: 패키지의 evaluate() 와 3장의 evaluate_ap
  from_checkpoint → RFDETRNano, class_names=['circle', 'rectangle', 'triangle'], 분류 머리 Linear(in_features=256, out_features=4, bias=True)
  (pretrained) 패키지 evaluate(): mAP50:95 0.9828, mAP50 1.0000, mAP75 0.9900, mAR 0.9864
  (pretrained) 우리 evaluate_ap : AP      0.9830, AP50  1.0000, AP75  0.9900  | max_dets=500 이면 AP 0.9830  | 클래스별 AP circle 0.989, rectangle 0.996, triangle 0.965
  예측 예 (시험 그림 0, 점수 상위 4개 / 돌려받은 277개):
    rectangle 점수 0.980  (cx, cy, w, h) = [0.225, 0.326, 0.34, 0.193]
    rectangle 점수 0.977  (cx, cy, w, h) = [0.618, 0.44, 0.315, 0.408]
    circle    점수 0.975  (cx, cy, w, h) = [0.732, 0.194, 0.225, 0.215]
    rectangle 점수 0.962  (cx, cy, w, h) = [0.456, 0.633, 0.296, 0.183]
    정답: ['circle', 'rectangle', 'rectangle', 'rectangle'] [[0.731, 0.2, 0.224, 0.224], [0.226, 0.327, 0.344, 0.193], [0.455, 0.632, 0.297, 0.182], [0.618, 0.44, 0.317, 0.411]]
  (scratch) 패키지 evaluate(): mAP50:95 0.7722, mAP50 0.8827, mAP75 0.8582, mAR 0.9132
  (scratch) 우리 evaluate_ap : AP      0.7738, AP50  0.8834, AP75  0.8569  | max_dets=500 이면 AP 0.7738  | 클래스별 AP circle 0.814, rectangle 0.752, triangle 0.754
| 모델 | 채점기 | AP50:95 | AP50 | AP75 |
| (a) 사전 학습에서 시작 | 패키지 | 0.9828 | 1.0000 | 0.9900 |
| 우리 | 0.9830 | 1.0000 | 0.9900 | |
| (b) 무작위 초기화 | 패키지 | 0.7722 | 0.8827 | 0.8582 |
| 우리 | 0.7738 | 0.8834 | 0.8569 |
- 두 채점기가 맞다. (a) 는 0.0002, (b) 는 0.0016 차이다. 3장에서 손으로 만든 채점기가 실제 패키지의 채점과 같은 것을 재고 있다는 뜻이다. 시험 세트의 AP(0.983)는 검증 세트의 AP(0.984)와도 거의 같아, 검증 세트에 맞춰 고른 체크포인트가 처음 보는 그림에서도 그대로 통했다.
- 완전히 같지 않은 까닭. 채점 규칙이 아니라 채점한 예측이 조금 다르기 때문으로 보인다.
evaluate()는 학습 때와 같은 경로로 순전파하는데, 로그의Using bfloat16 Automatic Mixed Precision (AMP)가 말하듯 16비트 혼합 정밀도로 계산한다. 우리 쪽 예측은predict()가 FP32 로 계산한 것이다. 박스 좌표가 소수 몇째 자리에서 달라지면 IoU 가 문턱값(특히 0.90, 0.95)을 아슬아슬하게 넘거나 못 넘는 예측이 몇 개 생기고, AP 의 끝자리가 움직인다. 박스가 덜 정확한 (b) 에서 차이가 더 큰 것도 그렇게 설명된다. (이 설명은 따로 실험해 확인하지는 않았다.) - 그림당 예측 수 제한은 영향이 없었다. 패키지는 그림당 500개까지(
eval_max_dets), 3장의 기본값은 100개까지 채점에 넣는데, 우리 채점기를 500 으로 바꿔도 AP 가 같았다(0.9830). 객체가 그림당 많아야 4개라 상위 100개 밖에는 쓸모 있는 예측이 없기 때문이다. - 클래스별로 보면 (a) 는 사각형 0.996, 원 0.989, 삼각형 0.965 이다. AP50 이 1.0 이니 놓치거나 잘못 부른 것은 거의 없고, 차이는 높은 IoU 문턱값에서 박스가 얼마나 꼭 맞는가에서 난다. 삼각형의 박스가 조금 덜 꼭 맞는 셈이다.
- 예측을 직접 보면 시험 그림 0번에서 점수 상위 네 개가 정답 네 개와 하나씩 대응한다. 예를 들어 예측
(0.225, 0.326, 0.34, 0.193)과 정답(0.226, 0.327, 0.344, 0.193)은 좌표가 0.004 안쪽으로 같다. 돌려받은 예측은 277개인데,num_select300개 가운데 쓰이지 않는 넷째 칸의 예측 23개를 걸러 낸 수이다.
추론 설정 바꿔 보기
학습이 끝난 모델도 쓰는 방법 에 따라 결과가 달라진다. 가중치는 그대로 두고 추론 설정 세 가지를 바꿔 본다. 모두 미세 조정한 모델 (a) 와 시험 세트 200장으로 잰 것이다.
ch14_finetune.py · knobs
def threshold_sweep(predictions, targets, thresholds, iou_threshold: float = 0.5):
    """점수 문턱값을 올리며 남는 예측 수 · 정밀도 · 재현율을 센다 (IoU 0.5 기준, 3장의 match_detections)."""
    num_gt = sum(len(t["labels"]) for t in targets)
    rows = []
    for threshold in thresholds:
        kept = tp = 0
        for pred, target in zip(predictions, targets):
            keep = pred["scores"] > threshold  # 패키지와 같이 "문턱값보다 큰 것" 만 남긴다
            boxes, scores, labels = box_cxcywh_to_xyxy(pred["boxes"][keep]), pred["scores"][keep], pred["labels"][keep]
            kept += int(keep.sum())
            for cls in range(NUM_CLASSES):
                gt = box_cxcywh_to_xyxy(target["boxes"][target["labels"] == cls])
                tp += int(match_detections(boxes[labels == cls], scores[labels == cls], gt, iou_threshold).sum())
        rows.append({"threshold": threshold, "kept": kept, "precision": tp / max(kept, 1), "recall": tp / num_gt})
    return rows

def resolution_sweep(model, paths, targets, sizes):
    """predict(shape=(H, W)) 로 추론 해상도만 바꿔 AP 를 잰다. H, W 는 patch_size × num_windows 의 배수여야 한다."""
    rows = []
    for size in sizes:
        start = time.time()
        predictions = predict_all(model, paths, threshold=0.0, num_classes=NUM_CLASSES, shape=(size, size))
        seconds = time.time() - start
        result = evaluate_ap(predictions, targets, NUM_CLASSES)
        rows.append({"size": size, "AP": result["AP"], "AP50": result["AP50"], "AP75": result["AP75"],
                     "ms_per_image": 1000 * seconds / len(paths)})
    return rows
[5] 추론 설정 바꿔 보기 (미세 조정한 모델 (a), 시험 세트 200장)
  문턱값 | 남는 예측 수 | 정밀도 | 재현율   (IoU 0.5 기준, 정답 483개)
    0.05 |          517 | 0.9342 | 1.0000
    0.10 |          489 | 0.9877 | 1.0000
    0.20 |          484 | 0.9979 | 1.0000
    0.30 |          483 | 1.0000 | 1.0000
    0.40 |          483 | 1.0000 | 1.0000
    0.50 |          483 | 1.0000 | 1.0000
    0.60 |          481 | 1.0000 | 0.9959
    0.70 |          481 | 1.0000 | 0.9959
    0.80 |          480 | 1.0000 | 0.9938
    0.90 |          476 | 1.0000 | 0.9855
    0.95 |          463 | 1.0000 | 0.9586
  num_select | 그림당 돌려받은 예측 수(평균) | AP     | AP50
         300 |                        250.7 | 0.9830 | 1.0000
         100 |                         87.0 | 0.9830 | 1.0000
          20 |                         18.0 | 0.9830 | 1.0000
           5 |                          4.6 | 0.9819 | 1.0000
           2 |                          2.0 | 0.7116 | 0.7129
  predict(shape=(S, S)) | AP     | AP50   | AP75   | 그림당 시간(ms, 파일 읽기 포함 · 참고용)
                    128 | 0.8921 | 0.9973 | 0.9652 | 11.5
                    192 | 0.9566 | 0.9997 | 0.9864 | 12.1
                    256 | 0.9810 | 1.0000 | 0.9900 | 15.8
                    320 | 0.9835 | 1.0000 | 0.9899 | 15.1
                    384 | 0.9830 | 1.0000 | 0.9900 | 24.9
                    448 | 0.9825 | 1.0000 | 0.9869 | 40.9
                    512 | 0.9826 | 1.0000 | 0.9899 | 46.7
                    640 | 0.9833 | 1.0000 | 0.9867 | 42.3
  shape=(400, 400) 은 거절된다: shape must have both dimensions divisible by 32 (patch_size=16 * num_windows=2), got (400, 400).
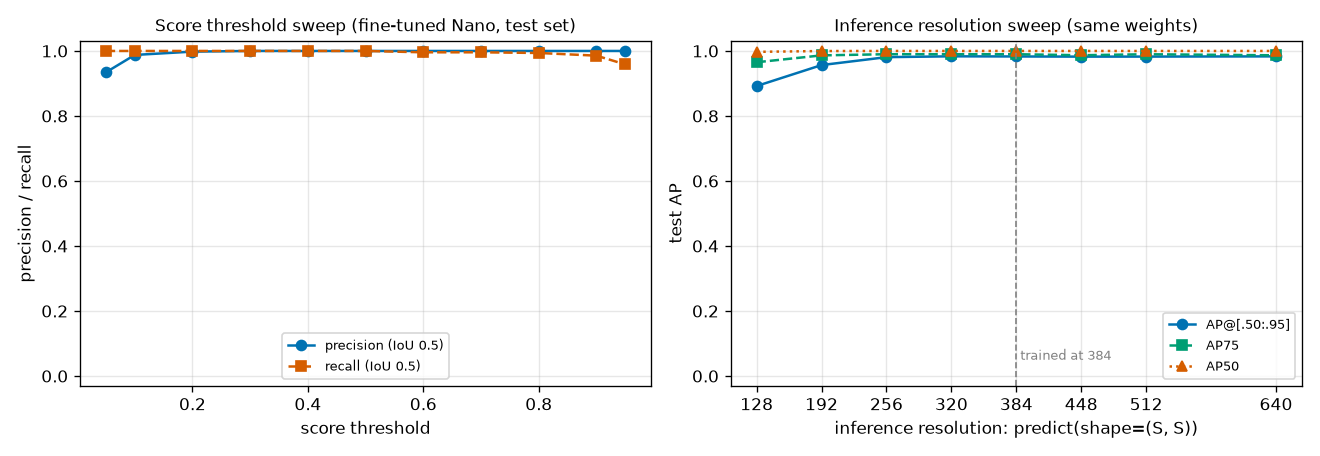
왼쪽은 점수 문턱값을 올릴 때의 정밀도(파랑 실선)와 재현율(주황 점선)로, IoU 0.5 기준이다. 오른쪽은 predict(shape=(S, S)) 로 추론 해상도만 바꿨을 때의 시험 AP · AP50 · AP75 이고, 회색 세로선이 학습 해상도 384 다.
점수 문턱값
predict(threshold=…) 는 점수가 그 값보다 큰 예측만 남긴다. 문턱값을 올리면 틀린 예측이 줄고(정밀도 ↑) 놓치는 객체가 늘어난다(재현율 ↓). 3장 의 그 맞바꿈이다.
- 0.3 – 0.5 에서는 완벽하다. 남는 예측이 정확히 483개로 정답 객체 수와 같고, 정밀도와 재현율이 모두 1.0000 이다(IoU 0.5 기준). 기본값 0.5 가 이 데이터에서는 잘 맞는다.
- 낮추면 거짓 양성이 섞인다. 0.05 에서는 예측이 517개로 늘고 그 가운데 34개가 틀려 정밀도가 \(483/517 = 0.934\) 이다. 재현율은 이미 1 이라 더 얻을 것이 없다.
- 올리면 놓친다. 0.9 에서 476개(재현율 0.986), 0.95 에서 463개(재현율 0.959). 모델이 맞게 찾고도 점수를 0.95 까지는 주지 않은 객체가 20개 있다는 뜻이다.
- 점수가 양 끝으로 갈려 있다는 것도 읽을 수 있다. 그림 200장에서 나온 수만 개의 예측 가운데 0.05 를 넘는 것이 517개뿐이고, 0.2 와 0.8 사이에서는 수가 거의 변하지 않는다(484 → 480). 그림 14-6 왼쪽의 두 선이 넓은 구간에서 1 에 붙어 있는 까닭이다.
실제 데이터에서는 이렇게 넓고 평평한 구간이 나오지 않는다. 검증 세트에서 이런 표를 만들어 “거짓 경보가 더 나쁜가, 놓치는 것이 더 나쁜가” 에 따라 문턱값을 정하라. 문턱값은 AP 에는 영향을 주지 않는다(AP 는 모든 문턱값을 훑어 계산한 값이다). 설명문에 따르면 threshold 에 ClassThresholds 를 주어 클래스마다 다른 문턱값을 쓸 수도 있다(돌려 보지는 않았다).
남기는 예측 수 num_select
후처리가 남기는 (질의, 클래스) 쌍의 수이다. 만든 뒤에도 model.model.postprocess.num_select = K 로 바꿀 수 있다.
- 300 → 20 으로 줄여도 AP 가 그대로다(0.9830). 그림마다 객체가 많아야 4개이고, 그 예측들이 점수 순위의 맨 앞에 있기 때문이다. 5 로 줄여도 0.9819 이다.
- 2 로 줄이면 무너진다(AP 0.7116). 객체가 3 – 4개인 그림에서 두 개밖에 답하지 못하니 당연하다.
num_select는 “그림 한 장에 나올 수 있는 객체 수의 상한” 보다 넉넉히 커야 한다. - 300개를 달라고 했는데 평균 250.7개가 돌아온 것 은 우리
detections_to_prediction이 쓰이지 않는 넷째 칸의 예측을 걸러 냈기 때문이다. 상위 300 쌍 가운데 평균 49개쯤이 그 칸이었다.
num_select 를 줄여도 신경망의 계산량은 줄지 않는다(질의 300개는 그대로 디코더를 지난다). 줄어드는 것은 후처리와 결과의 크기뿐이다. 계산량까지 줄이는 것은 12장 의 “질의 수” 손잡이인데, 그것은 모델 구조를 바꾸는 일이라 이 장에서는 다루지 않았다.
추론 해상도
predict(shape=(H, W)) 는 이번 호출에서만 입력 해상도를 바꾼다. 가중치도 모델 설정도 그대로다.
- 256 부터 640 까지 AP 가 거의 같다(0.981 – 0.9835, 차이 0.003 안쪽). 모델은 “384 로 학습” 했지만 실제로는 다중 스케일 학습으로 224 – 544 의 여러 크기를 보았고, 위치 임베딩은 크기에 맞춰 보간된다. 학습 때 본 적 없는 640 에서도 0.9833 이다. 12장 에서 해상도를 “학습 뒤에 돌릴 수 있는 손잡이” 로 다룬 것이 실제 모델에서도 통한다.
- 너무 낮추면 떨어진다. 192 에서 0.957, 128 에서 0.892. 그런데 128 에서도 AP50 은 0.997 이다. 객체를 놓치는 것이 아니라 박스가 덜 정밀해지는 것이다(AP75 0.965). 128 에서는 패치가 \(8 \times 8 = 64\) 개뿐이라, 384 의 576개에 견주어 한 변의 눈금이 세 배 거친다.
- 올린다고 좋아지지도 않는다. 원본 그림이 192 픽셀이라 384 넘게 키워 봐야 새 정보가 없다. 작은 객체가 많은 큰 사진이라면 결과가 다를 것이다.
- 오른쪽 끝 열의 시간은 파일 읽기가 섞이고 GPU 를 나눠 쓰는 중에 잰 값이라 참고용이다(512 가 640 보다 느리게 나올 만큼 흔들린다). 그래도 해상도를 따라 커지는 경향(128 에서 11.5 ms, 384 에서 24.9 ms, 640 에서 42.3 ms)은 보인다. 낮은 해상도는 “조금 덜 정확하고 더 빠른” 선택지다.
- 32 의 배수가 아닌 400 은 앞에서 본 대로 거절된다(출력의 마지막 줄).
- 해상도를 바꿀 수 없는 경우
-
model.inference()로 만든 추론 전용 스냅숏과 내보낸 ONNX 파일은 해상도가 고정된다. 다른 해상도로 쓰려면 그 해상도로 다시 만들거나 내보내야 한다.
내보내기와 배포
학습을 마친 모델은 PyTorch 안에서만 돈다. 실제 서비스나 기기에서는 PyTorch 없이, 그 하드웨어에 맞게 다듬은 실행기로 돌리는 일이 많다. 모델을 다른 실행기가 읽을 수 있는 파일로 바꾸는 일을 내보내기(export) 라고 한다. ch14_export.py 가 미세 조정한 Nano 를 내보내고, 다른 실행기로 돌려 보고, 속도를 잰다.
ONNX 로 내보내기
ONNX(Open Neural Network Exchange) 는 신경망을 “표준 연산들이 이어진 그래프” 로 적어 두는 파일 형식이다. PyTorch 로 만든 모델을 ONNX 파일로 써 두면, ONNX 를 읽을 줄 아는 여러 실행기(ONNX Runtime, TensorRT, OpenVINO …)가 그것을 돌릴 수 있다. 서로 다른 도구 사이의 공용어인 셈이다. 표준 연산의 목록은 판(버전)마다 조금씩 늘어나는데, 그 판 번호를 opset(operator set version) 이라고 한다.
패키지에서는 model.export() 한 줄이다. 설치판의 기본 인자는 format="onnx", opset_version=17, batch_size=1, output_dir="output" 이고, 내보낸 파일의 경로를 돌려준다.
ch14_export.py · export
print(f"[2] ONNX 로 내보내기 → {EXPORT_DIR}/")
start = time.time()
onnx_path = model.export(output_dir=EXPORT_DIR, verbose=False)  # 기본값: format="onnx", opset_version=17, batch_size=1
print(f"  model.export() 가 돌려준 경로: {onnx_path}  ({time.time() - start:.1f}초,"
      f" {os.path.getsize(onnx_path) / 2**20:.1f} MB)")
graph = onnx.load(str(onnx_path))
print(f"  opset {graph.opset_import[0].version}, 노드 {len(graph.graph.node)}개")
options = ort.SessionOptions()
options.intra_op_num_threads = CPU_THREADS  # 연산 하나를 몇 개의 스레드로 나눠 계산할 것인가
session = ort.InferenceSession(str(onnx_path), options, providers=["CPUExecutionProvider"])
for tensor in session.get_inputs():
    print(f"  입력  {tensor.name!r}: 모양 {tensor.shape}, {tensor.type}")
for tensor in session.get_outputs():
    print(f"  출력  {tensor.name!r}: 모양 {tensor.shape}, {tensor.type}")
meta = json.loads({p.key: p.value for p in graph.metadata_props}["rfdetr_inference"])
shown = ("input_shape", "means", "stds", "channel_order", "resize_interpolation", "resize_antialias",
         "outputs", "box_format", "class_names", "num_select")
print("  파일에 함께 적힌 메타데이터(일부):", json.dumps({k: meta[k] for k in shown}, ensure_ascii=False))
[0] 환경: rfdetr 1.12.1, torch 2.15.0+cu132, onnx 1.23.2, onnxruntime 1.32.0 (실행 제공자 ['AzureExecutionProvider', 'CPUExecutionProvider'])
  GPU: NVIDIA RTX PRO 2000 Blackwell Generation Laptop GPU | CPU: Intel(R) Core(TM) Ultra 7 255H (코어 16개)
[1] 모델: fine-tuned Nano (Shape World, 3 classes), 입력 해상도 384×384
[2] ONNX 로 내보내기 → ch14_export/
  model.export() 가 돌려준 경로: ch14_export/rfdetr-nano.onnx  (8.6초, 102.7 MB)
  opset 17, 노드 1422개
  입력  'input': 모양 [1, 3, 384, 384], tensor(float)
  출력  'dets': 모양 [1, 300, 4], tensor(float)
  출력  'labels': 모양 [1, 300, 4], tensor(float)
  파일에 함께 적힌 메타데이터(일부): {"input_shape": [1, 3, 384, 384], "means": [0.485, 0.456, 0.406], "stds": [0.229, 0.224, 0.225], "channel_order": "RGB", "resize_interpolation": "bilinear", "resize_antialias": false, "outputs": {"pred_boxes": "dets", "pred_logits": "labels"}, "box_format": "cxcywh_normalized", "class_names": ["circle", "rectangle", "triangle"], "num_select": 300}
- 산출물. 파일 하나,
rfdetr-nano.onnx(102.7 MB)이다. 저장소의 문서(개발판)에는inference_model.onnx라는 이름이 나오지만 1.12.1 은 모델 종류를 따서 이름을 지었다. 이름을 미리 짐작하지 말고export()가 돌려준 경로를 쓰라. - 입력 은 이름
input, 모양[1, 3, 384, 384], float32. 배치 크기 1 과 해상도 384 가 그래프에 고정 되어 있다. 설명문(docstring)에 따르면 다른 배치 크기는export(batch_size=4)나export(dynamic_batch=True), 다른 해상도는export(shape=(H, W))로 다시 내보낸다(나누어떨어짐 제약은 같다). - 출력 은 두 개,
dets(박스,[1, 300, 4])와labels(클래스 로짓,[1, 300, 4])이다. 앞에서 본 날출력pred_boxes·pred_logits그대로이고, 전처리도 후처리도 그래프 안에 들어 있지 않다. 리사이즈 · 정규화 · 상위 K 고르기는 쓰는 쪽이 해야 한다. - 메타데이터. 그래서 패키지는 전처리 · 후처리에 필요한 정보(평균 · 표준편차, 채널 순서, 보간 방식, 출력 이름, 박스 형식, 클래스 이름,
num_select)를 ONNX 파일 안에 함께 적어 둔다. 파일 하나만 건네받아도 어떻게 써야 하는지 알 수 있다.
- 출력은 모양이 아니라 이름으로 구별하라
- 우리 모델의 두 출력은 모양이 똑같이
[1, 300, 4]이다. 박스는 좌표가 4개라서, 로짓은 클래스 3개 + 1칸이라서 4 이다. “마지막 차원이 4 인 것이 박스” 라는 식으로 모양을 보고 고르는 코드는 클래스가 정확히 3개일 때만 조용히 틀린다(공식 문서도 이 함정을 경고한다).session.run(["dets", "labels"], …)처럼 이름으로 꺼내라.
onnxruntime 으로 돌려 PyTorch 와 비교
ONNX Runtime(onnxruntime) 은 ONNX 그래프를 실행하는 엔진이다. 어떤 하드웨어로 계산할지는 “실행 제공자(execution provider)” 로 고른다. rfdetr[onnx] 로 설치되는 기본판 onnxruntime 에는 GPU 제공자가 없다(위 출력 첫 줄의 제공자 목록에 CUDA 가 없다). GPU 로 돌리려면 onnxruntime-gpu 가 따로 필요하다. 이 장은 CPU 제공자만 썼다.
내보낸 모델이 원래 모델과 같은 계산 을 하는지부터 확인해야 한다. 같은 입력 텐서를 PyTorch 모델과 ONNX 모델에 넣고 날출력을 수치로 비교한다. 전처리는 앞에서 본 preprocess 함수로 직접 한다.
ch14_export.py · parity
print("[3] onnxruntime 추론 vs PyTorch 순전파 (같은 입력 텐서)")
image = np.asarray(Image.open(test_paths[0]).convert("RGB"))  # (192, 192, 3) uint8
height, width = image.shape[:2]
reference = model.predict(test_paths[0], threshold=0.5)        # 비교 기준. (처음 부를 때 모델이 GPU 로 옮겨진다)
x = preprocess(image, size, model.means, model.stds)           # (1, 3, 384, 384)
dets, logits = session.run(["dets", "labels"], {"input": x})   # 이름으로 꺼낸다: 둘 다 (1, 300, 4) 일 수 있다!
net = model.model.model.eval()                                  # 실제 nn.Module. eval() 을 잊지 않는다
with torch.no_grad():
    out = net(torch.from_numpy(x).to(model.model.device))      # {"pred_boxes": (1, 300, 4), "pred_logits": (1, 300, C)}
torch_boxes = out["pred_boxes"].float().cpu().numpy()[0]        # (300, 4)
torch_logits = out["pred_logits"].float().cpu().numpy()[0]      # (300, C)
box_diff = np.abs(dets[0] - torch_boxes).max(axis=1)            # 질의마다의 박스 차이 (300,)
logit_diff = np.abs(logits[0] - torch_logits).max(axis=1)
best = (1.0 / (1.0 + np.exp(-logits[0]))).max(axis=1)           # 질의마다의 최고 점수 (300,)
confident = best > 0.05                                         # "쓸모 있는" 질의
differ = box_diff > 1e-3
r, g, b = (int(v) for v in image[0, 0])
print(f"  전처리 예: 왼쪽 위 픽셀 RGB ({r}, {g}, {b}) → 정규화 뒤 {[round(float(v), 4) for v in x[0, :, 0, 0]]}"
      f"  (R 채널 손계산: ({r}/255 − 0.485)/0.229 = {(r / 255 - 0.485) / 0.229:.4f})")
print(f"  입력 {x.shape} → dets {dets.shape}, labels {logits.shape}")
print(f"  check (점수 0.05 초과 질의 {int(confident.sum())}개): 박스 최대 차이 {box_diff[confident].max():.1e},"
      f" 로짓 최대 차이 {logit_diff[confident].max():.1e}  (PyTorch {device} vs onnxruntime CPU)")
print(f"  질의 300개 전체: 박스 최대 차이 {box_diff.max():.1e}, 로짓 최대 차이 {logit_diff.max():.1e}"
      f" | 박스 차이가 1e-3 을 넘는 질의 {int(differ.sum())}개, 그 질의들의 최고 점수 {best[differ].max() if differ.any() else 0.0:.3f}")
diff_boxes, diff_logits = float(box_diff[confident].max()), float(logit_diff[confident].max())
[3] onnxruntime 추론 vs PyTorch 순전파 (같은 입력 텐서)
  전처리 예: 왼쪽 위 픽셀 RGB (30, 17, 39) → 정규화 뒤 [-1.6042, -1.7381, -1.1247]  (R 채널 손계산: (30/255 − 0.485)/0.229 = -1.6042)
  입력 (1, 3, 384, 384) → dets (1, 300, 4), labels (1, 300, 4)
  check (점수 0.05 초과 질의 4개): 박스 최대 차이 7.8e-05, 로짓 최대 차이 1.3e-02  (PyTorch cuda vs onnxruntime CPU)
  질의 300개 전체: 박스 최대 차이 1.0e+00, 로짓 최대 차이 2.3e+00 | 박스 차이가 1e-3 을 넘는 질의 185개, 그 질의들의 최고 점수 0.013
출력의 check 두 줄을 차례로 읽는다.
- 객체를 잡은 질의에서는 같다. 점수가 0.05 를 넘는 질의 4개(이 그림의 객체 4개)에서 박스의 최대 차이는 \(7.8 \times 10^{-5}\)(정규화 단위; 192 픽셀 그림에서 0.015 픽셀), 로짓의 최대 차이는 0.013 이다. 완전히 0 이 아닌 것은 정상이다. 한쪽은 GPU 의 PyTorch, 한쪽은 CPU 의 ONNX Runtime 이라 같은 수식을 서로 다른 순서 · 다른 라이브러리로 계산하고, float32 는 유효 숫자가 7자리쯤이라 층을 수십 개 거치며 끝자리가 조금씩 달라진다. 로짓 0.013 의 차이는 점수 0.98 근처에서 0.0003 쯤의 차이다.
- 그런데 300개 전체를 비교하면 크게 다르다. 박스 최대 차이 1.0, 로짓 최대 차이 2.3. 차이가 \(10^{-3}\) 을 넘는 질의가 185개나 된다. 내보내기가 잘못된 것일까? 아니다. 그 185개 질의의 점수는 가장 높은 것도 0.013 이다. 모두 “아무것도 없다” 고 답한 배경 질의다.
- 왜 배경 질의만 달라지나. 10장 의 2단계 질의 선택을 떠올리면 짐작할 수 있다. 인코더 출력의 576개 위치(24 × 24)가 낸 제안 가운데 점수 상위 300개가 질의의 기준 박스가 된다. 도형 세상의 배경은 어디나 비슷해서 배경 위치들의 제안 점수가 서로 거의 같고, 계산 순서가 달라 끝자리가 조금만 바뀌어도 그 순위가 뒤바뀐다. 그러면 같은 번호의 질의가 서로 다른 제안을 받아 출력이 통째로 달라진다. 객체 위의 제안은 점수가 뚜렷이 높아 순위가 바뀌지 않는다. (이 설명은 관측과 맞는 추정이고, 제안의 순위를 직접 비교해 확인한 것은 아니다.)
- 내보낸 모델을 검증할 때
- 날출력 텐서를 통째로
np.allclose로 비교하면 멀쩡한 모델도 “다르다” 고 나올 수 있다. 쓸모 있는 예측끼리(점수가 문턱값을 넘는 것) 비교하거나, 다음 절처럼 후처리를 마친 탐지 결과를 비교하라. 가장 확실한 것은 내보낸 모델로 검증 세트 전체의 AP 를 다시 재는 것이다. 쓸모 있는 예측에서도 차이가 0.1 처럼 크다면 전처리(RGB 순서, 정규화, 보간 방식)가 다르거나eval()을 빠뜨린 것이다.
날출력을 직접 후처리하기
이제 ONNX 가 준 dets · labels 를 앞에서 만든 postprocess 함수에 넣어 탐지 결과로 바꾸고, model.predict() 가 준 결과와 비교한다. 전처리 → ONNX 순전파 → 후처리의 세 토막을 모두 우리 손으로 한 것이므로, 이것이 맞으면 PyTorch 도 rfdetr 패키지도 없는 곳에서(예를 들어 다른 언어로 짠 서버에서) 같은 결과를 낼 수 있다는 뜻이다.
[4] 날출력을 직접 후처리 vs model.predict()
  로짓 (Q, C) = (300, 4) → 쌍 1200개 가운데 상위 300개 → 문턱값 0.5 를 넘는 것 4개
    질의   1 · 클래스 1 (rectangle): 점수 0.9796, xyxy [10.5, 44.1, 75.8, 81.1]
    질의   0 · 클래스 1 (rectangle): 점수 0.9768, xyxy [88.4, 45.3, 148.8, 123.6]
    질의   2 · 클래스 0 (circle): 점수 0.9751, xyxy [118.9, 16.7, 162.1, 58.0]
    질의   3 · 클래스 1 (rectangle): 점수 0.9624, xyxy [59.2, 103.9, 116.1, 139.1]
  check: predict() 와 개수 같음 True, 클래스 같음 True, 박스 최대 차이 9.0e-03 픽셀, 점수 최대 차이 3.7e-05
  질의마다 가장 높은 점수의 분포: 0.5 초과 4개, 0.05 이하 296개 (질의 300개 가운데)
- 직접 한 후처리가
predict()와 같다. 탐지 4개, 클래스가 같고, 박스의 최대 차이 0.009 픽셀, 점수의 최대 차이 \(3.7 \times 10^{-5}\). 앞 절에서 본 PyTorch(GPU)와 ONNX Runtime(CPU)의 계산 차이가 그대로 넘어온 크기다. 1,200개의 (질의, 클래스) 쌍에서 300개를 고르고, 그 가운데 문턱값 0.5 를 넘는 것이 4개였다. - 점수는 양 끝으로 갈려 있다. 질의 300개 가운데 최고 점수가 0.5 를 넘는 것이 4개, 0.05 이하가 296개이고 그 사이에는 하나도 없다. NMS 없이도 중복이 없고(7장) 문턱값을 0.3 으로 하든 0.5 로 하든 결과가 같았던 까닭이다. 또 객체를 잡은 질의의 번호가 0, 1, 2, 3 인 것은 우연이 아니다. 2단계 질의 선택이 인코더 제안을 점수가 높은 순으로 뽑아 질의 0, 1, 2 … 에 차례로 배정하기 때문에(10장), 객체가 있는 자리의 제안이 맨 앞 번호를 받는다.
- 더 편한 길도 있다.
RFDETRInference("…/rfdetr-nano.onnx").predict(그림)처럼 ONNX 파일을 패키지의 추론기로 읽으면, 파일에 적힌 메타데이터로 전처리 · 후처리를 알아서 하고Detections를 돌려준다 (1.12.1 에서 같은 박스가 나오는 것을 확인했다). rfdetr 패키지를 설치할 수 있는 환경이라면 이쪽이 안전하다.
지연 시간 재기
12장 에서 지연 시간은 NAS 의 한 축이었다. 그런데 지연 시간은 AP 와 달리 재는 방법에 따라 값이 몇 배씩 달라지는 숫자다. RF-DETR 논문(4절, 부록 K)이 측정 방법을 따로 공들여 적은 까닭이다. 먼저 무엇을 재는지부터 정해야 한다.
- 순전파만(model only): 전처리된 텐서가 GPU 에 올라가 있는 상태에서 신경망을 한 번 통과시키는 시간. 논문과 README 의 표가 이 값이다.
- 처음부터 끝까지(end to end): 그림을 받아 전처리 → 순전파 → 후처리해 결과를 돌려주기까지. 쓰는 사람이 실제로 기다리는 시간이다.
그리고 재는 요령이 있다. 아래 measure 함수가 그것을 담고 있다.
ch14_export.py · timer
def measure(run, warmup: int, repeats: int, sync=None, sleep: float = 0.0) -> np.ndarray:
    """run() 을 warmup 번 헛돌린 뒤 repeats 번 재서, 한 번마다 걸린 시간(ms)의 배열을 돌려준다.

    sync:  GPU 는 명령을 "예약" 만 하고 바로 돌아오므로, 재기 전후에 torch.cuda.synchronize 로 끝나기를 기다려야 한다.
    sleep: 순전파 사이에 쉬는 시간(초). 논문은 GPU 가 전력 제한에 걸리지 않게 200 ms 를 쉬었다.
    """
    for _ in range(warmup):
        run()
    if sync:
        sync()
    times = np.zeros(repeats)
    for i in range(repeats):
        if sleep:
            time.sleep(sleep)
        start = time.perf_counter()
        run()
        if sync:
            sync()
        times[i] = (time.perf_counter() - start) * 1000.0
    return times

def summarize(times: np.ndarray) -> dict:
    return {"median": float(np.median(times)), "p10": float(np.percentile(times, 10)),
            "p90": float(np.percentile(times, 90)), "mean": float(times.mean()), "n": int(len(times))}
- 예열 실행을 버린다. 처음 몇 번은 메모리 할당, 연산 구현 고르기, 캐시 채우기 같은 준비 때문에 훨씬 느리다. 이 값을 평균에 넣으면 안 된다. 이 실습은 구성을 바꿀 때마다 몇 번을 헛돌린 뒤 잰다.
- GPU 를 기다린다. PyTorch 의 GPU 연산은 “일을 맡기고 바로 돌아오는” 방식이다.
torch.cuda.synchronize()로 일이 끝나기를 기다리지 않고 시계를 보면, 맡기는 데 걸린 시간만 재게 되어 터무니없이 빠른 값이 나온다. - 여러 번 재서 분포를 본다. 한 번의 값은 그 순간 다른 프로그램이 무엇을 했는지에 흔들린다. 구성마다 200번(CPU 구성은 40번)을 재서 중앙값 을 대푯값으로 쓰고, 10% · 90% 분위수로 퍼진 정도를 함께 적는다(평균은 가끔 튀는 큰 값에 끌려간다).
- 배치 1. 실시간 탐지의 지연 시간은 그림 한 장이 들어와 결과가 나올 때까지의 시간이므로 배치 크기 1 로 잰다.
- 견줄 구성들은 번갈아 잰다. 기계를 다른 작업과 나눠 쓰면 부하가 시시각각 변한다. 구성 A 를 다 재고 나서 B 를 재면 “그때 기계가 한가했는가” 가 결과에 섞인다. 이 실습은 모든 구성을 조금씩(GPU 구성 20번, CPU 구성 4번) 재는 것을 한 라운드로 삼아 10 라운드를 돌린다. 그러면 부하의 변화가 모든 구성에 고르게 묻는다. 물론 가장 좋은 것은 아무것도 돌지 않는 기계에서 재는 것이다.
논문이 지적한 측정의 함정은 세 가지이다. 다른 사람의 지연 시간 숫자를 읽을 때 늘 확인할 것들이기도 하다.
| 함정 | 무슨 일인가 | 논문의 처방 |
| 전력 제한(스로틀링) | 쉬지 않고 순전파를 돌리면 GPU 가 뜨거워져 스스로 속도를 낮추고, 측정값이 흔들린다 | 순전파 사이에 200 ms 쉬기. 200 ms 넘게 쉬어도 차이가 없었다고 한다 |
| 정밀도 섞어 보고하기 | 정확도는 FP32 모델로, 지연 시간은 FP16(half precision, 16-bit floating point) 엔진으로 재서 한 표에 적는다. 그런데 FP16 으로 바꾸면 정확도가 달라질 수 있다 — 논문은 D-FINE 을 그대로 FP16 으로 바꾸면 AP 가 0.5 로 무너졌다고 적는다 | 정확도와 지연 시간을 같은 산출물(같은 FP16 엔진)로 재서 보고 |
| NMS 빼고 재기 | YOLO 계열은 신경망 뒤에 NMS 가 꼭 필요한데, 그 시간을 빼고 재는 경우가 많다 | NMS 가 필요한 모델은 그 시간을 넣어 비교. DETR 계열은 NMS 가 없다 |
여기서 FP16 은 수 하나를 16비트로 적는 부동소수점(반정밀도)이다. 보통 쓰는 FP32(32비트, 유효 숫자 약 7자리)에 견주어 유효 숫자가 3 – 4자리로 줄지만, 메모리가 절반이고 GPU 에서 더 빨리 계산된다. 가중치와 중간 계산값을 이렇게 더 적은 비트의 수로 바꿔 모델을 작고 빠르게 만드는 일을 통틀어 양자화(quantization) 라고 한다(FP32 → FP16, 더 나아가 8비트 정수 INT8). 그리고 표의 “엔진” 은 TensorRT(NVIDIA TensorRT) 가 만든 것이다. TensorRT 는 NVIDIA 의 추론 최적화 도구로, ONNX 그래프를 받아 특정 GPU 에 맞게 연산을 합치고 정밀도를 고르고 가장 빠른 구현을 골라 “엔진” 파일로 컴파일한다. 논문의 지연 시간은 모두 T4 GPU 에서 TensorRT 10.4 로 만든 FP16 엔진으로 잰 것이다.
이 노트북에서 잰 결과
미세 조정한 Nano(384 × 384)를 이 튜토리얼의 노트북(NVIDIA RTX PRO 2000 Blackwell 노트북 GPU 8GB, Intel Core Ultra 7 255H 16코어)에서 쟀다. 먼저 밝혀 둘 것이 있다. 이 측정은 다른 학습 작업들이 같은 GPU 와 CPU 를 쓰고 있는 중에 했다. 지연 시간을 재기에는 나쁜 조건이지만, 덕분에 “측정값이 조건에 얼마나 흔들리는가” 를 숫자로 볼 수 있다.
ch14_export.py · latency
print("[5] 지연 시간 (배치 1, 그림 1장당 ms)")
rounds = 2 if args.quick else 10              # 구성들을 이 횟수만큼 번갈아 돌며 잰다
gpu_n, cpu_n = (5, 2) if args.quick else (20, 4)  # 한 라운드에서 구성 하나를 재는 횟수 (GPU, CPU)
x_cpu = torch.from_numpy(x)
default_threads = torch.get_num_threads()     # PyTorch 의 기본 스레드 수 (보통 코어 수)
configs = []                                  # 잴 구성의 목록: 이름 · 실행할 함수 · 한 라운드의 횟수 …

def add(label, key, run, n, device_kind="gpu", sleep=0.0, threads=None):
    configs.append({"label": label, "key": key, "run": run, "n": n, "device": device_kind, "sleep": sleep,
                    "threads": threads})

if device == "cuda":
    x_gpu = x_cpu.cuda()

    def forward_fp16():
        with torch.autocast("cuda", dtype=torch.float16):  # 자동 혼합 정밀도: 되는 연산은 FP16 으로
            return net(x_gpu)

    with torch.no_grad():
        out16 = forward_fp16()
    keep = torch.from_numpy(confident).to(x_gpu.device)  # 점수 0.05 초과 질의만 비교 (이유는 [3] 과 같다)
    print(f"  FP16 과 FP32 의 출력 차이 (점수 0.05 초과 질의):"
          f" 박스 최대 {float((out16['pred_boxes'].float() - out['pred_boxes'])[0][keep].abs().max()):.1e},"
          f" 로짓 최대 {float((out16['pred_logits'].float() - out['pred_logits'])[0][keep].abs().max()):.1e}")
    add("PyTorch GPU FP32, forward only", "torch_gpu_fp32", lambda: net(x_gpu), gpu_n)
    add("PyTorch GPU FP16 autocast, forward only", "torch_gpu_fp16", forward_fp16, gpu_n)
    add("PyTorch GPU FP32, forward only, 200 ms sleep between", "torch_gpu_fp32_sleep", lambda: net(x_gpu),
        max(2, gpu_n // 4), sleep=0.2)
    add("PyTorch GPU FP32, model.predict() end to end", "torch_gpu_predict",
        lambda: model.predict(image, threshold=0.5, include_source_image=False), gpu_n)
    # 패키지가 권하는 추론 전용 스냅숏: 고정 배치 · 고정 해상도로 추적(trace)해 CUDA 그래프로 재생한다.
    # 준비가 길어(분 단위) --quick 에서는 건너뛴다.
    for dtype, tag in (() if args.quick else (("float32", "FP32"), ("float16", "FP16"))):
        start = time.time()
        predictor = model.inference(dtype=dtype)  # RFDETRInference 를 돌려준다 (원래 model 은 그대로)
        print(f"  model.inference(dtype={dtype!r}) 준비 {time.time() - start:.1f}초")
        add(f"PyTorch GPU {tag}, model.inference() predictor end to end", f"torch_gpu_predictor_{tag.lower()}",
            lambda predictor=predictor: predictor.predict(image, threshold=0.5), gpu_n)
        if dtype == "float16":
            half = predictor.predict(image, threshold=0.5)
            print(f"  FP16 스냅숏의 예측: {len(half)}개, predict() 와 박스 최대 차이"
                  f" {float(np.abs(half.xyxy - reference.xyxy).max()) if len(half) == len(reference) else float('nan'):.2f} 픽셀")
net_cpu = net if device == "cpu" else copy.deepcopy(net).cpu()
add(f"onnxruntime CPU FP32 ({CPU_THREADS} threads), forward only", "ort_cpu_fp32",
    lambda: session.run(["dets", "labels"], {"input": x}), cpu_n, "cpu")
add(f"PyTorch CPU FP32 ({CPU_THREADS} threads), forward only", "torch_cpu_fp32", lambda: net_cpu(x_cpu), cpu_n, "cpu",
    threads=CPU_THREADS)
if default_threads != CPU_THREADS:
    add(f"PyTorch CPU FP32 ({default_threads} threads = default), forward only", "torch_cpu_fp32_default",
        lambda: net_cpu(x_cpu), 1, "cpu", threads=default_threads)

# 기계를 다른 작업과 나눠 쓰면 부하가 시시각각 변한다. 구성 A 를 다 재고 B 를 재면 "그때 기계가 한가했는가" 가
# 결과에 섞인다. 그래서 A, B, C … 를 조금씩 번갈아(라운드) 재서, 부하의 변화가 모든 구성에 고르게 묻게 한다.
print(f"  라운드 {rounds}번 · 구성 {len(configs)}개를 번갈아 잰다. 시작할 때: load average {os.getloadavg()[0]:.1f}"
      f" (CPU 코어 {os.cpu_count()}개), GPU 사용률 · 메모리 {gpu_utilization() or '-'}")
sync = torch.cuda.synchronize if device == "cuda" else None
collected = {c["key"]: [] for c in configs}
with torch.no_grad():
    for _ in range(rounds):
        for c in configs:
            if c["threads"]:
                torch.set_num_threads(c["threads"])
            is_gpu = c["device"] == "gpu"
            collected[c["key"]].append(measure(c["run"], 3 if is_gpu else 1, c["n"], sync if is_gpu else None, c["sleep"]))
torch.set_num_threads(default_threads)
print(f"  끝났을 때: load average {os.getloadavg()[0]:.1f}, GPU 사용률 · 메모리 {gpu_utilization() or '-'}")
# 라운드마다의 중앙값을 표로: 행 = 구성, 열 = 라운드. 어떤 라운드에서 모든 구성이 함께 느려졌다면 기계가 붐빈 것이다.
medians = np.array([[np.median(t) for t in collected[c["key"]]] for c in configs])  # (구성 수, 라운드 수)
relative = medians / np.median(medians, axis=1, keepdims=True)  # 구성마다 자기 중앙값으로 나눠 단위를 없앤다
quiet = int(relative.mean(axis=0).argmin())                     # 모든 구성이 전체적으로 가장 빨랐던 라운드
print("  라운드별 중앙값 (ms): " + " ".join(f"{'R' + str(r + 1):>8s}" for r in range(rounds)))
for c, row in zip(configs, medians):
    print(f"    {c['key']:22s}" + " ".join(f"{v:8.1f}" for v in row))
print(f"  가장 한가했던 라운드: R{quiet + 1}")
rows = []
print(f"  {'구성':58s} 전체 중앙값 |      10% |      90% | R{quiet + 1} 의 중앙값 | n")
for c, row in zip(configs, medians):
    times = np.concatenate(collected[c["key"]])
    stats = summarize(times)
    rows.append({"label": c["label"], "key": c["key"], "device": c["device"], "times": times.tolist(),
                 "round_medians": row.tolist(), "quiet": float(row[quiet]), **stats})
    print(f"  {c['label']:58s} {stats['median']:10.2f} | {stats['p10']:8.2f} | {stats['p90']:8.2f} |"
          f" {row[quiet]:12.2f} | {stats['n']}")
[5] 지연 시간 (배치 1, 그림 1장당 ms)
  FP16 과 FP32 의 출력 차이 (점수 0.05 초과 질의): 박스 최대 3.4e-05, 로짓 최대 4.7e-03
  model.inference(dtype='float32') 준비 85.6초
  model.inference(dtype='float16') 준비 88.7초
  FP16 스냅숏의 예측: 4개, predict() 와 박스 최대 차이 0.07 픽셀
  라운드 10번 · 구성 9개를 번갈아 잰다. 시작할 때: load average 4.8 (CPU 코어 16개), GPU 사용률 · 메모리 97 %, 3472 MiB
  끝났을 때: load average 13.7, GPU 사용률 · 메모리 70 %, 3474 MiB
  라운드별 중앙값 (ms):       R1       R2       R3       R4       R5       R6       R7       R8       R9      R10
    torch_gpu_fp32            15.2     16.9     17.5     16.9     16.7     16.9     16.7     16.9     17.2     17.3
    torch_gpu_fp16            14.1     12.0     14.0     11.3     15.5     14.8     14.1     12.6     15.9     11.7
    torch_gpu_fp32_sleep      18.1     18.6     20.8     19.7     20.4     19.4     19.5     20.9     21.2     18.1
    torch_gpu_predict         19.5     21.6     23.9     19.6     19.4     19.5     21.8     21.8     19.5     19.8
    torch_gpu_predictor_fp32    16.9     16.3     14.5     14.2     14.2     14.8     15.8     11.6     15.2     14.7
    torch_gpu_predictor_fp16    10.1     10.1      7.0     10.4     10.4      9.6     10.1     11.0     10.0     10.1
    ort_cpu_fp32             113.6    113.1    112.5    111.9    112.1    112.1    112.1    112.5    112.0    111.7
    torch_cpu_fp32           154.7    147.6    147.0    151.8    146.2    148.1    148.1    146.7    147.5    154.9
    torch_cpu_fp32_default  3428.0   3072.9   3082.1   2900.0   2939.1   3110.0   2940.0   3144.9   3007.1   3109.0
  가장 한가했던 라운드: R4
  구성                                                         전체 중앙값 |      10% |      90% | R4 의 중앙값 | n
  PyTorch GPU FP32, forward only                                  16.91 |    14.87 |    17.61 |        16.86 | 200
  PyTorch GPU FP16 autocast, forward only                         13.83 |    11.31 |    17.02 |        11.32 | 200
  PyTorch GPU FP32, forward only, 200 ms sleep between            19.67 |    17.09 |    21.94 |        19.71 | 50
  PyTorch GPU FP32, model.predict() end to end                    20.35 |    17.50 |    24.32 |        19.63 | 200
  PyTorch GPU FP32, model.inference() predictor end to end        14.61 |    12.28 |    17.77 |        14.24 | 200
  PyTorch GPU FP16, model.inference() predictor end to end        10.13 |     7.84 |    12.85 |        10.35 | 200
  onnxruntime CPU FP32 (8 threads), forward only                 112.29 |   111.67 |   115.56 |       111.95 | 40
  PyTorch CPU FP32 (8 threads), forward only                     147.96 |   146.46 |   160.51 |       151.78 | 40
  PyTorch CPU FP32 (16 threads = default), forward only         3077.49 |  2935.22 |  3173.22 |      2899.97 | 10
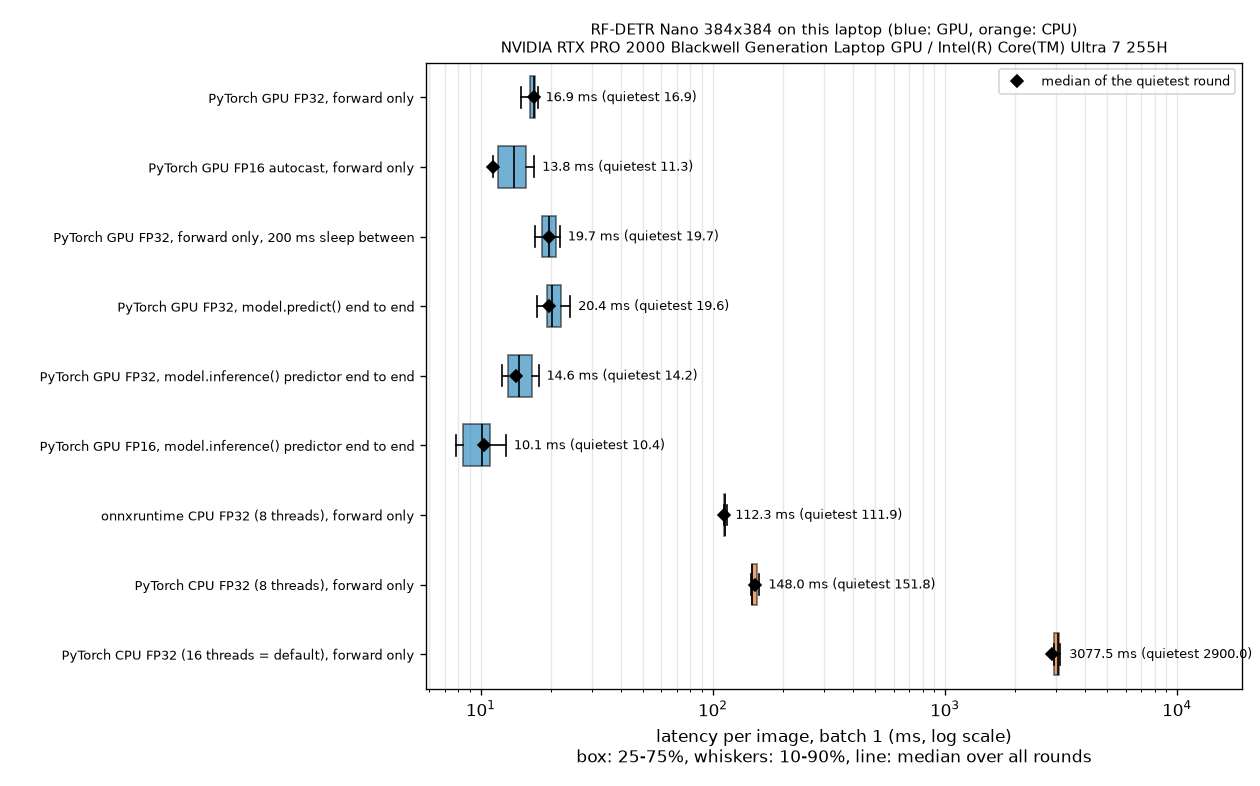
같은 모델 · 같은 그림 한 장을 구성만 바꿔 잰 지연 시간의 상자 그림(가로축은 로그 눈금). 상자는 25 – 75%, 수염은 10 – 90%, 상자 안의 선이 전체 중앙값이고, 검은 마름모는 기계가 가장 한가했던 라운드의 중앙값이다. 파랑은 GPU, 주황은 CPU 구성이다. GPU 구성은 수 – 수십 ms 에 모여 있고, CPU 구성은 그보다 훨씬 오른쪽에서 상자가 넓게 퍼져 있다.
출력의 위쪽 표는 라운드마다의 중앙값이다. 행(구성)마다 열 방향으로 값이 고르면 재는 동안 기계의 사정이 크게 변하지 않았다는 뜻이고, 이번 실행이 그랬다. 아래쪽 표를 정리하면 이렇다.
| 구성 | 잰 범위 | 중앙값(ms) | 10% – 90% |
| PyTorch GPU, FP32 | 순전파만 | 16.9 | 14.9 – 17.6 |
| PyTorch GPU, FP16 자동 혼합 정밀도 | 순전파만 | 13.8 | 11.3 – 17.0 |
| PyTorch GPU, FP32, 사이에 200 ms 쉬기 | 순전파만 | 19.7 | 17.1 – 21.9 |
| | 처음부터 끝까지 | 20.4 | 17.5 – 24.3 |
| | 처음부터 끝까지 | 14.6 | 12.3 – 17.8 |
| | 처음부터 끝까지 | 10.1 | 7.8 – 12.9 |
| onnxruntime CPU, FP32, 8 스레드 | 순전파만 | 112.3 | 111.7 – 115.6 |
| PyTorch CPU, FP32, 8 스레드 | 순전파만 | 148.0 | 146.5 – 160.5 |
| PyTorch CPU, FP32, 16 스레드(기본값) | 순전파만 | 3,077 | 2,935 – 3,173 |
- 무엇을 재느냐에 따라 3.4 ms 가 다르다. 같은 FP32 모델인데 순전파만 재면 16.9 ms,
predict()전체를 재면 20.4 ms 이다. 전처리 · 후처리 · 결과를 CPU 로 가져오는 일이 전체의 17% 이다. “지연 시간 몇 ms” 라는 말에는 늘 “어디서 어디까지” 가 따라붙어야 한다. - FP16 은 빠르고, 출력은 조금 달라진다. 자동 혼합 정밀도만 켜도 순전파가 16.9 → 13.8 ms 로 18% 줄었다. 그 대신 출력이 달라진다. 객체를 잡은 질의에서 박스 최대 \(3.4 \times 10^{-5}\), 로짓 최대 0.0047. 이 모델에서는 무시할 크기지만, 논문의 D-FINE 사례처럼 FP16 에서 정확도가 무너지는 모델도 있다. FP16 으로 쓸 것이면 FP16 으로 AP 를 다시 재야 하는 이유다.
- 추론 전용 스냅숏이 가장 빠르다.
model.inference()로 만든 추론기는 전처리 · 후처리를 다 넣고도 14.6 ms 로, 일반 모듈의 순전파만(16.9 ms)보다 빠르다. FP16 스냅숏은 10.1 ms 로predict()의 절반이다. 결과는predict()와 박스 최대 0.07 픽셀 차이였다. 대가는 준비 시간(이번 실행에서 85.6초와 88.7초; GPU 가 한가할 때는 12.7초, 붐빌 때는 3분까지 걸렸다)과, 배치 크기 · 해상도가 고정된다는 것이다. - 200 ms 를 쉬었더니 오히려 느려졌다(16.9 → 19.7 ms). 논문의 T4 에서는 쉬지 않고 돌릴 때 전력 제한에 걸려 측정이 흔들렸기 때문에 쉬었다. 이 노트북에서는 반대로, 쉬는 사이에 GPU 가 절전 상태로 내려가거나 다른 작업이 그 틈을 차지해 다음 순전파가 느려진 것으로 보인다(원인을 따로 확인하지는 않았다). 어느 쪽이 “맞는” 값인지는 쓰임새가 정한다. 동영상처럼 쉬지 않고 들어오면 앞의 값, 가끔 한 장씩 들어오면 뒤의 값이 실제에 가깝다. 그래서 측정 방법을 함께 적어야 한다.
- CPU 는 GPU 보다 한 자릿수 느리고, 실행기에 따라 다르다. 같은 8 스레드에서 onnxruntime 112 ms, PyTorch 148 ms 로 onnxruntime 이 1.3배 빠르다. GPU 순전파(16.9 ms)의 6.6배이다.
- 스레드 수의 함정. PyTorch 는 기본으로 코어 수(16)만큼 스레드를 쓴다. 그 기본값으로 재면 한 장에 3.1초, 8 스레드(148 ms)의 21배가 걸렸다. 열 라운드 모두 2.9 – 3.4초였다. 다른 작업이 코어 몇 개를 쓰고 있었고(load average 5 – 14), 이 CPU 는 성능이 다른 코어가 섞여 있어, 16개 스레드가 서로를 기다리며 헛도는 것으로 보인다. 아무것도 돌지 않는 기계에서는 이렇게까지 되지 않을 수 있지만(확인하지 못했다), “스레드가 많을수록 빠르다” 는 믿을 수 없다. CPU 로 배포한다면
torch.set_num_threads나 onnxruntime 의intra_op_num_threads를 직접 정하고 재 보라. - 기계가 붐비면 모든 것이 흔들린다. 같은 스크립트를 다른 작업이 한창일 때(load average 25) 돌린 앞선 실행에서는, GPU FP32 순전파의 라운드별 중앙값이 8.7 ms 에서 58.4 ms 까지, onnxruntime CPU 가 113 ms 에서 634 ms 까지 움직였다. 그때 가장 빨랐던 라운드의 8.7 ms 가 GPU 를 혼자 쓸 때의 값에 가까울 것이고, 위 표의 16.9 ms 는 GPU 를 다른 학습과 나눠 쓴 값이다. 논문이 전용 T4 에서 편차 0.1 ms 를 이야기하는 것과 견주면, 이 표의 숫자는 첫 자리 정도만 믿을 수 있다.
- 이 숫자들을 논문 · README 의 2.3 ms 와 견주면 안 된다
- 논문 표 2 와 README 의 “Nano 2.3 ms” 는 NVIDIA T4 + TensorRT + FP16, 순전파만, 배치 1 의 값이다. 위 표와는 다음이 모두 다르다.
- 하드웨어: 서버용 T4 와 노트북 GPU 는 다른 기계다. 게다가 이 측정은 GPU 를 다른 학습 작업과 나눠 쓰는 중에 했다.
- 실행기: 컴파일된 TensorRT 엔진과 일반 PyTorch 모듈(또는 CPU 의 ONNX Runtime)은 같은 모델도 전혀 다른 속도로 돌린다. 이 튜토리얼은 TensorRT 엔진을 만들어 보지 않았다.
- 정밀도: FP16 엔진과 FP32 순전파.
- 범위: 순전파만 잰 값과, 전처리 · 후처리까지 넣은 값.
- 지연 시간은 같은 기계에서 같은 방법으로 잰 것끼리만 비교할 수 있다. 내 서비스에 필요한 숫자는 내 하드웨어에서, 실제로 쓸 실행기와 정밀도로, 처음부터 끝까지 재야 한다.
그 밖의 내보내기 형식
export(format=…) 은 ONNX 말고도 여러 형식을 받는다. 아래 표는 설치판의 export() 설명문(docstring)과 패키지의 추가 묶음 목록, 공식 문서를 정리한 것이다. 이 튜토리얼에서 직접 돌려 본 것은 ONNX 뿐 이고, 나머지는 문서 기준이다.
| | 산출물 | 추가 설치 | 어디에 쓰나(문서 기준) |
| | | | ONNX Runtime 등 여러 실행기. 직접 확인 |
| | | | NVIDIA GPU 에서 가장 낮은 지연 시간. ONNX 를 거쳐 변환하고 기본이 FP16( |
| | OpenVINO IR( | | Intel CPU · GPU · NPU |
| | | | 모바일 · 에지. ONNX → TensorFlow → TFLite 로 변환 |
| | | | 위와 같은 파일 형식을 ONNX · TensorFlow 없이 PyTorch 에서 바로 |
| | | | 기기 위의 PyTorch 실행기. |
| | | | Apple 기기(Xcode) |
| | | | Apple Core AI(문서: iOS · iPadOS · macOS 27 이상) |
- 설명문은 TFLite · ExecuTorch · CoreML · LiteRT 내보내기가 실험적 이며 바뀔 수 있다고 경고한다.
- INT8 양자화는
export(quantization="int8", calibration_data=…)로 한다(ONNX · OpenVINO · TensorRT). 8비트로 바꾸려면 중간 계산값이 어느 범위에 있는지 알아야 해서, 실제 쓰일 그림과 비슷한 보정용 그림 이 꼭 필요하다. 문서는 ONNX INT8 이 COCO 일부(500장)에서 Nano 의 mAP 를 2.65 떨어뜨렸다고 적고 “배포 전에 자기 데이터로 재 보라” 고 한다. - 어느 형식이든 원칙은 이 절에서 한 것과 같다. 내보낸 뒤에는 꼭 원래 모델과 출력을 비교하고, 내보낸 그 산출물로 정확도와 지연 시간을 함께 잰다.
분할과 키포인트 모델
13장 에서 만든 분할 머리를 단 모델 RF-DETR-Seg, 그리고 사람의 관절 같은 점들을 찾는 키포인트 모델(미리보기)도 같은 패키지에 있다. 이 절은 공식 문서와 설치판의 소스를 읽고 정리한 것이며 직접 돌려 보지는 않았다.
| 탐지 | 인스턴스 분할 | 키포인트(미리보기) | |
| 클래스 | | | |
| 쓰는 법 | 같다: | ||
| | | | |
| 데이터셋 주석 | | | |
| 설정(설치판) | Nano: 384 / 패치 16 / 질의 300 | SegNano: 312 / 패치 12 / 윈도 1 / 디코더 4층 / 질의 100 | 576 / 패치 12 / 디코더 4층 / 질의 100 |
| 더해지는 손실 | – | 마스크 BCE · 다이스 손실( | 키포인트 손실 |
| 가장 좋은 체크포인트를 고르는 기준 | 박스 mAP | 마스크 mAP | 키포인트 AP(OKS 기준) |
분할 모델을 쓸 때 탐지와 달라지는 것은 사실상 두 가지이다. 데이터셋 주석에 segmentation 이 있어야 하고, 결과에 detections.mask 가 더 들어 있다는 것. 패치가 12 라서 해상도는 24 의 배수(SegNano 는 12 의 배수)여야 한다는 점도 기억해 두라. 마스크가 어떻게 만들어지는지(질의 임베딩과 픽셀 임베딩의 내적), 왜 해상도의 1/4 크기로 계산하는지는 13장 에서 직접 만들어 보았다.
실전 요령과 흔한 문제
이 장의 실험과 설치판의 소스 · 문서에서 확인한 것만 모았다.
- 메모리가 모자랄 때 (CUDA out of memory)
-
-
batch_size를 줄이고 그만큼grad_accum_steps를 늘려 실효 배치 크기를 지킨다(4 × 4 → 2 × 8). 이 장의batch_size=2학습은 Nano 에서 최대 1.61 GiB 를 썼다. - 더 작은 모델(Nano)이나 더 낮은
resolution을 쓴다. 토큰 수는 해상도의 제곱에 비례한다(384 → 576개, 512 → 1,024개). - 문서는
gradient_checkpointing=True(모델을 만들 때 주는 설정)도 메모리를 줄이는 방법으로 든다. 속도와 맞바꾸는 방법이고, 이 장에서는 써 보지 않았다. -
num_workers가 크면 GPU 가 아니라 주 메모리(RAM) 가 모자랄 수 있다.
-
- 작은 객체가 안 잡힐 때
- 해상도를 올리는 것이 첫 번째 처방이다. Nano 의 384 에서 패치 하나는 16 × 16 픽셀이므로, 원본에서 그보다 한참 작은 객체는 패치 하나의 일부에 지나지 않는다.
model.train(resolution=512, …)처럼patch_size × num_windows의 배수로 올리거나, 처음부터 해상도가 높은 크기(Small 512, Medium 576, Large 704)를 고른다. 12장 에서 본 것처럼 정확도는 해상도와 패치 크기 각각보다 “한 변의 패치 수” 와 더 관계가 깊었다.
- 자주 걸리는 곳
-
- 해상도가 거절된다. 한 변이
patch_size × num_windows(Nano 32)의 배수가 아니면ValueError이다. 학습 · 추론 · 내보내기 모두 같다. - 클래스 번호가 하나씩 밀린 것 같다. 미세 조정한 모델의
class_id는 JSON 의category_id가 아니라 id 순으로 0 부터 다시 매긴 번호다. COCO 사전 학습 모델만 1 – 90 의 범주 id 를 그대로 쓴다. - 클래스 수가 안 맞는다는 경고. “Checkpoint has 90 classes but model is configured for 3” 은 정상이다. 반대로 모델에
num_classes를 직접 줬다면 데이터셋과 맞는지 확인하라. - 색이 이상한 결과. numpy 배열은 RGB 순서여야 한다. OpenCV 로 읽었다면 BGR 을 뒤집어 넣는다.
- 검증 폴더 이름.
val/이 아니라valid/, 주석 파일은_annotations.coco.json이다. - 같은 모델로 train() 을 또 부르면. 소스에 따르면 이어서 학습하는 것이 아니라 처음의 사전 학습 가중치에서 다시 시작 하고, 그렇다는 경고를 낸다. 이어서 하려면
resume=을 쓴다. - ONNX 출력을 모양으로 구별. 클래스가 3개면 박스와 로짓의 모양이 같다. 이름(
dets,labels)으로 꺼낸다. - 직접 순전파할 때 eval().
model.model.model(실제nn.Module)을 꺼내 쓸 때는.eval()을 직접 불러야 한다.predict()는 알아서 한다. - 남의 지연 시간 표. 하드웨어 · 실행기 · 정밀도 · 측정 범위가 적혀 있지 않은 지연 시간은 비교에 쓸 수 없다.
- 해상도가 거절된다. 한 변이
- 어디서부터 시작할까
-
- 사전 학습 모델로 내 그림 몇 장을
predict해 본다(이미 되는 일이라면 학습이 필요 없다). - 데이터를 COCO 형식으로 만들고, 저장한 주석을 다시 읽어 그림 위에 그려 본다(그림 14-3 처럼). 주석이 틀리면 뒤의 모든 것이 헛일이다.
- 가장 작은 모델(Nano)로, 기본 설정으로, 몇 에폭만 돌려 검증 AP 가 오르는지 본다.
- 시험 세트로 채점하고 예측을 눈으로 본다. 모자라면 그때 해상도 · 모델 크기 · 에폭 수를 올린다.
- 내보내고, 원래 모델과 출력을 비교하고, 실제 쓸 기계에서 지연 시간을 잰다.
- 사전 학습 모델로 내 그림 몇 장을
정리
-
rfdetr패키지(이 장은 1.12.1)는 크기별 클래스(RFDETRNano…)와 네 메서드predict·train·evaluate·export로 쓰인다. 학습에는rfdetr[train], ONNX 에는rfdetr[onnx]가 더 필요하다. 탐지 Nano – Large 와 분할 모델은 Apache 2.0, Atto · Femto · Pico · XLarge · 2XLarge 탐지는 PML 1.0(rfdetr[plus])이다. -
predict는 그림을 모델 해상도로 리사이즈 · 정규화해 넣고, 날출력을 시그모이드 → (질의 × 클래스) 쌍 전체에서 상위num_select개 → 문턱값 순으로 후처리해supervision.Detections(원본 픽셀의xyxy,confidence,class_id)로 돌려준다. NMS 는 없다. - 데이터는
train/ valid/ test/폴더마다_annotations.coco.json을 둔 COCO 형식으로 준비한다.bbox는 픽셀[x, y, w, h](왼쪽 위 모서리 기준)이고, 정규화 \((c_x, c_y, w, h)\) 와는 \(x^{\text{px}} = (c_x - w/2)W\), \(y^{\text{px}} = (c_y - h/2)H\) 로 오간다. 클래스 번호는 범주 id 순서대로 0 부터 다시 매겨진다. - 미세 조정은
model.train(dataset_dir=…)한 줄이고, 그 안에서 11장의 학습 고리가 돈다. 실효 배치 크기는batch_size × grad_accum_steps, 학습률은 머리 1e-4 에서 백본 맨 아래 3.2e-6 까지 부품 · 층마다 다르다. 로그의loss_ce·loss_bbox·loss_giou는 마지막 디코더 층,_0은 보조 손실,_enc는 인코더 제안의 손실이다. - 이 튜토리얼의 실험에서 사전 학습 가중치에서 시작한 Nano 는 도형 세상 1,000장으로 첫 에폭에 검증 AP 0.95, 5 에폭에 0.984(시험 0.983)에 이르렀고, 같은 조건의 무작위 초기화는 3 에폭에 0.77(시험 0.772) 이었다. 미세 조정의 힘은 사전 학습에서 온다.
- 패키지의
mAP_50_95는 3장의 AP@[.50:.95] 와 같은 정의다. 같은 예측을 우리evaluate_ap로 채점한 값과 0.002 안쪽으로 맞았다(0.9828 대 0.9830, 0.7722 대 0.7738). - 내보낸 ONNX 는 전처리 · 후처리가 빠진 날출력(
dets,labels)을 낸다. 내보낸 뒤에는 원래 모델과 출력을 수치로 비교하고, 지연 시간은 예열 · 동기화 · 여러 번 측정의 중앙값으로, 같은 기계 · 같은 실행기 · 같은 정밀도 · 같은 범위 끼리만 비교한다.
확인 문제
- 1. 너비 640, 높이 480 인 그림에서 정규화 박스 \((c_x, c_y, w, h) = (0.25,\ 0.5,\ 0.5,\ 0.25)\) 를 COCO 의
bbox로 바꾸라. 그리고 그bbox를 2장의 모서리 표현 \((x_0, y_0, x_1, y_1)\) 픽셀로도 적어 보라. - \(x^{\text{px}} = (0.25 - 0.25) \times 640 = 0\), \(y^{\text{px}} = (0.5 - 0.125) \times 480 = 180\), \(w^{\text{px}} = 0.5 \times 640 = 320\), \(h^{\text{px}} = 0.25 \times 480 = 120\). 따라서
bbox = [0, 180, 320, 120]이고, 모서리 표현은 \((0,\ 180,\ 0 + 320,\ 180 + 120) = (0, 180, 320, 300)\) 이다. COCO 의 뒤 두 숫자는 모서리 좌표가 아니라 너비 · 높이라는 점, 가로 값에는 너비 640 을 세로 값에는 높이 480 을 곱한다는 점이 요점이다.
- 2. 학습 그림이 2,400장이고
batch_size=4,grad_accum_steps=4,epochs=20으로 학습한다. 실효 배치 크기, 한 에폭의 순전파 횟수와 가중치 갱신 횟수, 전체 갱신 횟수를 구하라. GPU 메모리가 모자라batch_size를 2 로 줄여야 한다면 같은 실효 배치 크기를 지키려면 무엇을 어떻게 바꾸는가? - 실효 배치 크기 \(4 \times 4 = 16\). 한 에폭에 순전파 \(2400/4 = 600\) 번, 갱신 \(2400/16 = 150\) 번. 전체 갱신 \(20 \times 150 = 3{,}000\) 번.
batch_size=2로 줄이면grad_accum_steps=8로 올려 \(2 \times 8 = 16\) 을 지킨다. 한 에폭의 순전파는 1,200 번으로 늘지만 갱신 횟수는 150 번 그대로다. 메모리는 줄고 시간은 줄지 않는다.
- 3. (가) RF-DETR Nano(
patch_size=16,num_windows=2)에 쓸 수 있는 해상도를 400, 416, 500, 640 가운데서 고르라. (나) 분할 모델 RFDETRSegSmall(patch_size=12,num_windows=2)에는 384, 400, 432 가운데 어느 것을 쓸 수 있는가? (다) Nano 를 640 으로 돌리면 패치 토큰은 몇 개이고 384 일 때의 몇 배인가? - (가) \(16 \times 2 = 32\) 의 배수여야 한다. \(416 = 32 \times 13\), \(640 = 32 \times 20\) 은 되고, \(400/32 = 12.5\), \(500/32 = 15.625\) 는 안 된다. (나) \(12 \times 2 = 24\) 의 배수: \(384 = 24 \times 16\), \(432 = 24 \times 18\) 은 되고 \(400/24 = 16.67\) 은 안 된다. (다) \(640/16 = 40\) 이므로 \(40 \times 40 = 1{,}600\) 개. 384 일 때는 \(24 \times 24 = 576\) 개이므로 \(1600/576 \approx 2.78\) 배이다. 해상도는 \(640/384 = 1.67\) 배인데 토큰은 그 제곱만큼 는다.
- 4. 클래스 3개로 미세 조정한 Nano 의 날출력
labels는 모양이(300, 4)이다. (가) 후처리가 순위를 매기는 (질의, 클래스) 쌍은 모두 몇 개인가? (나) 편 번호 \(i = 1001\) 은 몇 번 질의의 몇 번 클래스인가? (다) 질의 7 의 로짓이 \((3.0,\ 0.2,\ -4.0,\ -6.0)\) 이고 다른 질의의 점수는 모두 0.1 아래라면,threshold=0.5에서 질의 7 로부터 나오는 탐지는 몇 개이고 무엇인가? - (가) \(300 \times 4 = 1{,}200\) 개. 이 가운데 상위 300개가 뽑힌다. (나) \(q = \lfloor 1001/4 \rfloor = 250\), \(c = 1001 \bmod 4 = 1\). 질의 250 의 클래스 1(사각형). (다) 점수는 \(\sigma(3.0) = 0.953\), \(\sigma(0.2) = 0.550\), \(\sigma(-4.0) = 0.018\), \(\sigma(-6.0) = 0.002\). 0.5 를 넘는 것이 둘이므로 같은 박스가 두 번 나온다: 클래스 0(원) 점수 0.953, 클래스 1(사각형) 점수 0.550. 질의마다 클래스 하나만 고르는 소프트맥스 방식과 달리, 시그모이드 점수는 칸마다 독립이라 이런 일이 생길 수 있다. 문턱값을 0.6 으로 올리면 하나만 남는다.
- 5. 기본 설정(
lr_encoder=1.5e-4,lr_vit_layer_decay=0.8,lr_component_decay=0.7)의 Nano 에서 백본 블록 6 의 학습률을 구하라. 그리고 EMA 의 실효 감쇠율 \(d_t = 0.993\,(1 - e^{-t/100})\) 를 \(t = 50\) 과 \(t = 500\) 에서 계산해, 학습 초반과 후반에 EMA 가 어떻게 다르게 움직이는지 설명하라. - 학습률: \(1.5 \times 10^{-4} \times 0.7^2 \times 0.8^{13 - 6} = 7.35 \times 10^{-5} \times 0.8^7 = 7.35 \times 10^{-5} \times 0.2097 = 1.54 \times 10^{-5}\). EMA: \(t = 50\) 이면 \(1 - e^{-0.5} = 0.3935\) 이므로 \(d = 0.993 \times 0.3935 = 0.391\). \(t = 500\) 이면 \(1 - e^{-5} = 0.9933\) 이므로 \(d = 0.986\). 초반(\(d \approx 0.39\))에는 새 가중치를 61% 나 받아들여 EMA 가 빠르게 따라가고, 후반(\(d \approx 0.99\))에는 1% 남짓만 받아들여 천천히, 매끄럽게 움직인다. 처음부터 \(d = 0.993\) 이면 EMA 가 쓸모없는 초기 가중치에 오래 붙들려 있게 되는데,
ema_tau가 그것을 막아 준다.
- 6. 동료가 “README 에는 Nano 가 2.3 ms 라는데, 내 노트북에서
model.predict()를 재 보니 수십 ms 가 나온다. 뭔가 잘못 설치한 것 같다” 고 한다. 잘못 설치한 것이 아닐 수 있는 이유를 네 가지 이상 들고, 동료의 측정에서 확인해 볼 것을 적어 보라. - 두 숫자는 재는 조건이 다르다. ① 하드웨어: README 는 NVIDIA T4, 동료는 노트북 GPU(또는 CPU). ② 실행기: README 는 TensorRT 로 컴파일한 엔진, 동료는 일반 PyTorch 모듈(
model.inference()도 쓰지 않은 상태). ③ 정밀도: README 는 FP16,predict()는 FP32. ④ 범위: README 는 순전파만,predict()는 그림 읽기 · 전처리 · 후처리 · 결과 복사까지. 확인할 것: 예열 실행을 버렸는가, GPU 라면torch.cuda.synchronize()로 끝나기를 기다렸는가, 한 번이 아니라 여러 번 재서 중앙값을 봤는가, 정말 GPU 에서 돌고 있는가(model.model.device), 다른 프로그램이 GPU 를 쓰고 있지 않은가, 파일을 읽는 시간이 섞이지 않았는가.
여기까지가 본론이다. 박스 하나의 좌표에서 출발해, 직접 만든 부품들로 RF-DETR 을 조립하고, 마지막으로 진짜 RF-DETR 을 내 데이터에 맞춰 내보내 보았다. 마지막 15장(부록) 에는 학습이 잘 안 될 때 살펴볼 점검표, 이 튜토리얼에 나온 용어와 기호를 한데 모은 용어집, 그리고 여기서 더 나아가려는 분을 위한 읽을거리를 모아 두었다.
See also
- RF-DETR:Tutorial
- RF-DETR
- RF-DETR:Review
- RF-DETR:Troubleshooting:SlowTraining
- DINOv2
- COCO
- PyTorch
- Object detection
Favorite site
- 14. 실전: rfdetr 패키지
- roboflow/rf-detr - 공식 저장소(README, LICENSE, CHANGELOG)
- roboflow/supervision -
Detections를 정의한 라이브러리 - ONNX Runtime
- RF-DETR: Neural Architecture Search for Real-Time Detection Transformers (arXiv:2511.09554)