WorldModels:Tutorial:06-FirstWorldModel
lastmod 2026-11-18created 2026-11-172 edits
첫 번째 World Model은 World Model 튜토리얼의 6장이다. 진자(Pendulum)가 따르는 운동 방정식을 뉴턴 법칙에서 유도해 정답을 확보한 뒤, 그 법칙을 한 번도 보여 주지 않은 MLP 에게 (상태, 행동, 다음 상태) 데이터만 주고 같은 법칙을 배우게 한다. 표준화, 변화량 예측, MSE 와 가우시안 최대우도의 관계, 열린 고리 롤아웃의 오차 누적과 다스텝 손실을 다루며, 여기서 만든 DynamicsModel 은 7장의 계획(MPC)이 그대로 가져다 쓴다.
- 원문: 06. 첫 번째 World Model
- 실습 코드:
code/ch06_dynamics.py,code/wm_envs.py(노트북 CPU 4스레드에서 약 46초.--quick은 5초 남짓. 학습한 모델은ch06_model.pt로 저장된다) - 이전: 05. 강화학습 기초 / 다음: 07. MPC 와 CEM
큰 그림
World Model 은 "지금 상태에서 이 행동을 하면 다음에 무슨 일이 일어날지 예측하는 학습된 시뮬레이터"다. 이 장은 그 정의를 가장 단순한 형태로 구현한다.
- 관측은 숫자 3개 \(o_t = [\cos\theta_t,\ \sin\theta_t,\ \dot\theta_t]\), 행동은 숫자 1개(토크 \(a_t = u_t\))다.
- 진짜 환경(
wm_envs.py의step()세 줄)과 World Model \(f_\theta\) (MLP, 매개변수 34,180 개)는 같은 입력 \((o_t, a_t)\) 를 받아 같은 종류의 출력 \((o_{t+1}, r_t)\) 를 낸다. - 환경에서 모은 데이터 \(\mathcal{D}\) (전이 10,000 개)로 모델 출력 \(\hat o\) 가 환경 출력 \(o\) 에 가까워지도록 학습한다. 모델은 물리 법칙을 볼 수 없다.
순서는 (1) 환경의 법칙 유도, (2) 그 법칙의 이산 시간 계산, (3) 문제 정식화와 데이터 수집, (4) 모델 구성과 학습, (5) 1스텝 예측과 다스텝 상상의 정확도 측정이다.
진자의 물리 법칙
기호와 설정
막대는 한쪽 끝이 회전축에 고정되어 돈다. 각도는 위쪽 수직선에서 잰다.
| 기호 | 뜻 |
| \(\theta\) | 위쪽 수직선에서 잰 각도 [rad]. 0 이면 똑바로 선 자세, \(\pm\pi\) 면 매달린 자세다. |
| \(\dot\theta,\ \ddot\theta\) | 각속도 [rad/s], 각가속도 |
| \(m = 1\ \mathrm{kg},\ l = 1\ \mathrm{m}\) | 막대의 질량과 길이 |
| \(g = 10\ \mathrm{m/s^2}\) | 중력 가속도 |
| \(u \in [-2, 2]\) | 축에 거는 모터 토크 |
| \(I\) | 관성 모멘트(moment of inertia). 돌리기 어려운 정도다. |
| \(\tau\) | 토크(torque). 돌리는 힘이다. |
회전의 뉴턴 법칙
직선 운동의 \(F = ma\) 에 대응하는 회전 운동의 법칙은 다음과 같다.
\(\tau = I\,\ddot{\theta}\)
| 직선 운동 | 회전 운동 | 뜻 |
| 힘 \(F\) | 토크 \(\tau\) | 밀거나(직선) 돌리는(회전) 정도 |
| 질량 \(m\) | 관성 모멘트 \(I\) | 움직임을 바꾸기 어려운 정도 |
| 가속도 \(a\) | 각가속도 \(\ddot\theta\) | 속도가 1초에 얼마나 바뀌는지 |
토크는 "힘 × 지렛대 팔"이다. 회전축에서 힘이 걸리는 점까지의 벡터를 \(\vec r\), 힘을 \(\vec F\) 라 하면 \(\vec\tau = \vec r \times \vec F\) 이고 크기는 다음과 같다.
\(\lvert\tau\rvert = \lvert\vec r\rvert\,\lvert\vec F\rvert\,\sin\alpha\)
\(\alpha\) 는 \(\vec r\) 과 \(\vec F\) 사이의 각이다. 힘 가운데 팔에 수직인 성분 \(\lvert\vec F\rvert\sin\alpha\) 만 돌리는 데 쓰이고, 팔과 나란한 성분은 축을 밀거나 당길 뿐이다. 같은 값을 "힘 × (회전축에서 힘의 작용선까지의 수직 거리)"로 읽을 수 있고, 이 수직 거리 \(\lvert\vec r\rvert\sin\alpha\) 를 지렛대 팔이라 부른다.
관성 모멘트
질량 \(m\) 인 점 하나가 축에서 거리 \(r\) 에 있으면 \(I = mr^2\) 이다(점에 수직으로 힘을 주면 \(F = m\,r\ddot\theta\), \(\tau = rF = mr^2\ddot\theta\)). 끝을 축으로 도는 균일한 막대는 \(n\) 개 조각으로 잘라 각 조각의 \(m_i r_i^2\) 을 더한다. 조각 질량은 \(m_i = m/n\), 거리는 \(r_i = i\,l/n\) 이다.
\(\begin{align} I &\approx \sum_{i=1}^{n} \frac{m}{n}\left(\frac{i\,l}{n}\right)^2 = \frac{m\,l^2}{n^3}\sum_{i=1}^{n} i^2 = \frac{m l^2}{n^3}\cdot\frac{n(n+1)(2n+1)}{6} \\ &= \frac{ml^2}{6}\left(1+\frac{1}{n}\right)\left(2+\frac{1}{n}\right) \ \xrightarrow{\ n\to\infty\ }\ \frac{1}{3}ml^2 \end{align}\)
\(m = l = 1\) 일 때 \(n = 4\) 는 0.46875, \(n = 10\) 은 0.385, \(n = 100\) 은 0.33835, \(n = 1000\) 은 0.33383 으로 \(1/3\) 에 다가간다. 적분으로 쓰면 조각 질량이 \(dm = \frac{m}{l}dr\) 이므로 한 줄이다.
\(I = \int_0^l r^2\,dm = \int_0^l r^2\,\frac{m}{l}\,dr = \frac{m}{l}\Big[\frac{r^3}{3}\Big]_0^l = \frac{1}{3}ml^2\)
이 진자는 \(m = l = 1\) 이므로 \(I = \frac13\) 이다.
중력 토크
균일한 막대에서 중력의 효과는 질량 중심(축에서 \(l/2\))에 전체 무게 \(mg\) 가 걸린 것과 같다. 중력의 작용선은 질량 중심을 지나는 수직선이고, 회전축에서 이 수직선까지의 거리는 질량 중심의 수평 위치 \(\frac{l}{2}\sin\theta\) 다.
\(\tau_g = \frac{l}{2}\, m g\, \sin\theta\)
부호는 \(+\) 다. \(\theta \gt 0\) 이면 중력이 \(\theta\) 가 커지는 쪽으로 막대를 돌린다. \(\theta = 0\) 에서는 토크가 0 이지만 조금만 기울어도 더 쓰러지는 쪽으로 토크가 생기므로, 서 있는 자세는 불안정하다.
운동 방정식
막대에 걸리는 토크는 중력 토크 \(\tau_g\) 와 모터 토크 \(u\) 두 가지다(\(u\) 도 \(\theta\) 가 커지는 방향이 \(+\) 다).
\(\begin{align} I\,\ddot\theta &= \tau_g + u \\ \frac{1}{3}ml^2\,\ddot\theta &= \frac{l}{2}mg\sin\theta + u \\ \ddot\theta &= \frac{3}{ml^2}\left(\frac{l}{2}mg\sin\theta + u\right) = \frac{3g}{2l}\sin\theta + \frac{3}{ml^2}u \\ \ddot\theta &= 15\sin\theta + 3u \qquad (g=10,\ m=l=1) \end{align}\)
wm_envs.py 의 3.0 * self.g / (2.0 * self.l) * np.sin(th) + 3.0 / (self.m * self.l**2) * u 가 이 식이다.
한 번에 들어 올릴 수 없는 이유
막대가 수평(\(\theta = \pi/2\))일 때 중력 항은 15 이고 모터 항은 최대 \(3 \times 2 = 6\) 이다. 수평에 붙잡아 두려면 \(15 + 3u = 0\), 곧 \(u = -5\) 가 필요한데 토크 한계가 2 라서 불가능하다. 에이전트는 그네처럼 앞뒤로 흔들어 운동 에너지를 모은 뒤 그 기세로 올라가야 한다. "지금 당장 각도를 줄이는 행동"이 아니라 "잠시 반대로 가는 행동"이 필요하고, 이것이 7장에서 여러 스텝 앞을 내다보는 계획이 필요한 이유다.
오일러 적분
운동 방정식은 미분 방정식(differential equation)이다. 컴퓨터는 시간을 \(\Delta t = 0.05\) 초 간격으로 잘라 한 칸씩 계산한다. 미분의 정의에서 \(\Delta t\) 를 0 으로 보내지 않고 작은 값으로 두면 갱신식이 나온다.
\(\begin{align} \dot\theta(t) &\approx \frac{\theta(t+\Delta t) - \theta(t)}{\Delta t} \\ \theta(t+\Delta t) &\approx \theta(t) + \dot\theta(t)\,\Delta t \\ \dot\theta(t+\Delta t) &\approx \dot\theta(t) + \ddot\theta(t)\,\Delta t \end{align}\)
명시적 오일러와 반암시적 오일러
두 식을 적용하는 순서에 따라 두 방법이 있다.
| 방법 | 각속도 갱신 | 각도 갱신 | 차이 |
| 명시적 오일러 (explicit) | \(\dot\theta_{t+1} = \dot\theta_t + \ddot\theta_t\,\Delta t\) | \(\theta_{t+1} = \theta_t + \dot\theta_{t}\,\Delta t\) | 각도를 옛 속도로 갱신한다. |
| 반암시적 오일러 (semi-implicit) | \(\dot\theta_{t+1} = \dot\theta_t + \ddot\theta_t\,\Delta t\) | \(\theta_{t+1} = \theta_t + \dot\theta_{t+1}\,\Delta t\) | 각도를 새 속도로 갱신한다. |
토크 없이(\(u=0\)) \(\theta_0 = 2.0\), \(\dot\theta_0 = 0\) 에서 200 스텝(10초)을 돌리며 역학적 에너지 \(E = \frac12 I\dot\theta^2 + mg\frac{l}{2}\cos\theta\) 를 잰 결과는 다음과 같다(적분 방법만 비교하려고 각속도 자르기는 뺐다). 마찰이 없으므로 에너지는 보존되어야 한다.
- 명시적 오일러: \(-2.081 \to 18.015\). 에너지가 저절로 불어나 진자가 점점 더 크게 휘돈다.
- 반암시적 오일러: \(-2.081 \to -2.292\). 처음 값 근처에 머문다.
그래서 Gym 의 진자와 wm_envs.py 는 반암시적 오일러를 쓴다.
환경 코드와의 대응
    def step(self, action) -> tuple[np.ndarray, float, bool]:
        u = float(np.clip(np.asarray(action, dtype=np.float64).reshape(-1)[0], -self.max_torque, self.max_torque))
        th, thdot = self.th, self.thdot

        # 보상은 '움직이기 전' 상태로 계산한다 (Gym 과 같다).
        cost = angle_normalize(th) ** 2 + 0.1 * thdot**2 + 0.001 * u**2

        # 물리: θ̈ = (3g / 2l)·sin θ + (3 / m l²)·u     (6장에서 유도한다)
        # 오일러 적분: 속도를 먼저 갱신하고, 새 속도로 각도를 갱신한다 (semi-implicit Euler).
        thdot_new = thdot + (3.0 * self.g / (2.0 * self.l) * np.sin(th) + 3.0 / (self.m * self.l**2) * u) * self.dt
        thdot_new = float(np.clip(thdot_new, -self.max_speed, self.max_speed))
        th_new = th + thdot_new * self.dt

        self.th, self.thdot = th_new, thdot_new
        self.t += 1
        done = self.t >= self.max_steps
        return self._obs(), float(-cost), done
| 수식 | 코드 |
| \(u \leftarrow \mathrm{clip}(a_t, -2, 2)\) | |
| \(r_t = -(\theta_t^2 + 0.1\dot\theta_t^2 + 0.001u^2)\) | |
| \(\dot\theta_{t+1} = \dot\theta_t + \left(\frac{3g}{2l}\sin\theta_t + \frac{3}{ml^2}u\right)\Delta t\) | |
| \(\dot\theta_{t+1} \leftarrow \mathrm{clip}(\dot\theta_{t+1}, -8, 8)\) | |
| \(\theta_{t+1} = \theta_t + \dot\theta_{t+1}\Delta t\) | |
- 클래스 상수는
max_speed = 8.0,max_torque = 2.0,dt = 0.05(200 스텝 = 10초),g = 10.0,m = 1.0,l = 1.0이다.reset()은 각도를 \([-\pi, \pi]\), 각속도를 \([-1, 1]\) 에서 무작위로 고른다. - 보상식의 \(\theta_t\) 는 \([-\pi, \pi)\) 로 접은 각도다. 환경 안의
th는 여러 바퀴 돌면 \(2\pi\) 를 넘어 계속 커지므로angle_normalize로 접어 똑바로 선 자세에서 벗어난 정도만 잰다. 보상은 움직이기 전 상태로 계산한다. - \(\Delta t = 0.05\) 는 꽤 큰 간격이라 오일러 적분에 오차가 있고, 각속도를 \(\pm 8\) 에서 자르는 것도 진짜 물리에는 없는 규칙이다. World Model 관점에서는 상관없다. 모델이 배워야 할 "세상"은 이 코드 자체이고, 모델은 진짜 물리가 아니라 이 환경이 만들어 내는 데이터를 흉내 낸다.
관측을 (cos θ, sin θ, θ̇) 로 주는 이유
각도에는 이음매가 있다. \(\theta = 3.1\) 과 \(\theta = -3.1\) 은 둘 다 거의 매달린 자세라 물리적으로 가깝지만(실제 각도 차이는 \(6.2 - 2\pi \approx -0.083\)) 숫자로는 6.2 떨어져 있다. 비슷한 두 입력에 비슷한 출력을 내야 하는 신경망에게 불리하다. \((\cos\theta, \sin\theta)\) 로 바꾸면 두 자세의 거리가 실제 각도 차이를 반영한다.
\(\begin{align} d^2 &= (\cos a - \cos b)^2 + (\sin a - \sin b)^2 \\ &= (\cos^2 a + \sin^2 a) + (\cos^2 b + \sin^2 b) - 2(\cos a\cos b + \sin a\sin b) \\ &= 2 - 2\cos(a-b) = 4\sin^2\frac{a-b}{2} \\ d &= 2\left\lvert\sin\frac{a-b}{2}\right\rvert \end{align}\)
뺄셈 공식 \(\cos(a-b) = \cos a\cos b + \sin a \sin b\) 와 반각 공식 \(1 - \cos x = 2\sin^2\frac{x}{2}\) 를 썼다. \(a - b\) 가 \(2\pi\) 의 배수만큼 달라져도 값이 같으므로 이 거리에는 이음매가 없다. \(a = 3.1\), \(b = -3.1\) 이면 \(d = 2\lvert\sin 3.1\rvert = 2 \times 0.04158 = 0.0832\) 로 실제 각도 차이와 같다. 관측에서 각도를 되살릴 때는 atan2(sin θ, cos θ) 를 쓴다. 두 값의 부호까지 보고 \([-\pi, \pi]\) 의 각도를 돌려준다.
지도 학습 문제로 바꾸기
환경과 상호작용해 전이(transition) 데이터를 모은다.
\(\mathcal{D} = \big\{ (o_t,\ a_t,\ o_{t+1},\ r_t) \big\}\)
입력 \(x = [o_t,\ a_t]\) (숫자 4개)를 받아 정답 \(y = [o_{t+1},\ r_t]\) (숫자 4개)에 가까운 값을 내는 함수를 찾는다. 실제 신경망은 표준화한 변화량을 출력하며, \(f_\theta\) 는 그 후처리까지 포함한 모델 전체를 가리킨다.
\(f_\theta:\ \underbrace{[\cos\theta_t,\ \sin\theta_t,\ \dot\theta_t,\ u_t]}_{\text{입력 4개}} \ \longmapsto\ \underbrace{[\hat o_{t+1},\ \hat r_t]}_{\text{출력 4개}}\)
이것은 지도 학습(supervised learning)의 회귀 문제 그대로다. World Model 이 특별한 이유는 문제가 어려워서가 아니라, 배운 함수를 계속 이어 붙여 미래를 상상하는 데 쓴다는 점에 있다.
보상 함수 \(r = -(\theta^2 + 0.1\dot\theta^2 + 0.001u^2)\) 는 직접 정한 과제라서 대개 알고 있다. 이 장에서는 연습 삼아 보상까지 예측하게 하고, 7장의 계획에서는 알고 있는 보상 함수(pendulum_reward)를 쓴다. 그림을 관측으로 받는 8장 이후처럼 보상을 상태에서 바로 계산할 수 없을 때는 보상도 반드시 배워야 한다.
데이터 모으기
좋은 정책이 아직 없으므로 행동은 \([-2, 2]\) 에서 무작위로 고른다. 학습용 50 에피소드(10,000 전이)와 시드를 달리한 검증용 10 에피소드(2,000 전이)를 따로 모은다.
def episodes_to_arrays(episodes):
    """에피소드 목록 → 전이(transition) 배열 네 개.

    에피소드 하나의 obs 는 (T+1, 3) 이라서, 앞의 T 개가 o_t, 뒤의 T 개가 o_{t+1} 이 된다.
    """
    obs = np.concatenate([ep["obs"][:-1] for ep in episodes])  # (N, 3)  o_t
    act = np.concatenate([ep["action"] for ep in episodes])  # (N, 1)  a_t
    next_obs = np.concatenate([ep["obs"][1:] for ep in episodes])  # (N, 3)  o_{t+1}
    rew = np.concatenate([ep["reward"] for ep in episodes])  # (N,)    r_t
    return obs, act, next_obs, rew


def make_inputs_targets(obs, act, next_obs, rew):
    """신경망의 입력 x = [o_t, a_t], 정답 y = [o_{t+1} − o_t, r_t]."""
    inputs = np.concatenate([obs, act], axis=1)  # (N, 4)
    targets = np.concatenate([next_obs - obs, rew[:, None]], axis=1)  # (N, 4)
    return inputs.astype(np.float32), targets.astype(np.float32)
에피소드 하나의 obs 는 시작 관측을 포함해 길이가 \(T+1 = 201\) 이다. ep["obs"][:-1] 이 \(o_t\), ep["obs"][1:] 이 \(o_{t+1}\) 이 되어 한 칸씩 어긋난 짝이 만들어진다. 수집은 collect_episodes(Pendulum(seed=args.seed), args.episodes, seed=args.seed) 와 검증용 collect_episodes(Pendulum(seed=args.seed + 1000), 10, seed=args.seed + 1000) 로 한다.
- 무작위 데이터의 한계
- 무작위 행동으로는 진자를 세울 수 없어서 "위에서 천천히 균형 잡는 상태"가 거의 없다. 학습 데이터에서 \(\lvert\theta\rvert \lt 0.3\) 이고 \(\lvert\dot\theta\rvert \lt 1\) 인 전이는 1.45% 뿐이고, 아래쪽(\(\lvert\theta\rvert \gt \pi - 0.5\))은 28.6% 다. 모델은 데이터가 많은 곳에서 정확하고 드문 곳에서 부정확하다. 7장에서는 모델로 계획한 행동으로 새 데이터를 모아 이 빈틈을 메운다.
학습을 쉽게 만드는 두 요령
표준화
입력과 정답의 크기가 열마다 다르다. 학습 데이터의 정답 표준편차는 다음과 같다(입력 쪽도 \(\cos\theta\) 0.67, \(\dot\theta\) 3.67 로 다르다).
| 정답 열 | \(\Delta\cos\theta\) | \(\Delta\sin\theta\) | \(\Delta\dot\theta\) | 보상 |
| 표준편차 | 0.125 | 0.134 | 0.538 | 3.756 |
이대로 MSE 를 쓰면 제곱 오차가 \(3.756^2 \approx 14.1\) 대 \(0.125^2 \approx 0.016\) 으로 약 900 배 차이가 나서, 모델이 보상만 맞히고 \(\cos\theta\) 의 변화는 무시한다. 그래서 열마다 평균을 빼고 표준편차로 나누는 표준화(standardization)를 한다.
\(\tilde{x} = \frac{x - \mu}{\sigma}, \qquad \mu = \frac1N\sum_{i=1}^N x_i, \qquad \sigma = \sqrt{\frac1N\sum_{i=1}^N (x_i - \mu)^2}\)
표준화한 값의 평균은 0, 분산은 1 이다.
\(\begin{align} \frac1N\sum_{i=1}^N \tilde x_i &= \frac{1}{\sigma}\left(\frac1N\sum_{i=1}^N x_i - \frac{N\mu}{N}\right) = \frac{1}{\sigma}(\mu - \mu) = 0 \\ \frac1N\sum_{i=1}^N (\tilde x_i - 0)^2 &= \frac{1}{\sigma^2}\cdot\frac1N\sum_{i=1}^N (x_i-\mu)^2 = \frac{1}{\sigma^2}\cdot\sigma^2 = 1 \end{align}\)
- 예: 보상 열의 평균은 \(-5.965\), 표준편차는 3.756 이므로 보상 \(-1.0\) 은 \(\frac{-1.0 - (-5.965)}{3.756} = 1.32\) 가 된다.
- 모델은 표준화된 공간에서 배우고, 예측할 때는 \(x = \tilde x\,\sigma + \mu\) 로 되돌린다.
- \(\mu\), \(\sigma\) 는 학습 데이터로만 구하고 검증과 실제 사용 때도 같은 값을 쓴다. 검증 데이터의 통계를 쓰면 정보가 학습에 새어 들어가 성능을 실제보다 좋게 착각한다.
- 값이 늘 같은 열은 \(\sigma = 0\) 이라 0 으로 나누게 되므로 코드에서는 \(\sigma + 10^{-6}\) 으로 나눈다.
다음 상태 대신 변화량 예측
\(\Delta t = 0.05\) 초 동안 진자는 많이 움직이지 않아 \(o_{t+1}\) 은 \(o_t\) 와 매우 비슷하다. \(o_{t+1}\) 을 통째로 내게 하면 "입력을 거의 그대로 베끼기"와 "작은 변화 더하기"를 함께 배워야 하는데, 중요한 정보는 작은 변화 쪽에 있다. 그래서 변화량 \(\Delta o_t = o_{t+1} - o_t\) 를 예측하게 하고 다음 관측은 더해서 만든다.
\(\hat o_{t+1} = o_t + \widehat{\Delta o}_t\)
\(\dot\theta_t = 5.0\), \(\dot\theta_{t+1} = 5.3\) 인 경우, \(o_{t+1}\) 을 통째로 예측하며 1% 오차를 내면 0.053 이 틀리고 이는 실제 변화 0.3 의 약 18% 다. 변화량을 예측하며 1% 오차를 내면 0.003 만 틀린다. ResNet 의 잔차 연결(residual connection)과 같은 생각이며 거의 모든 동역학 모델이 쓴다.
MLP 동역학 모델
class DynamicsModel(nn.Module):
    """(o_t, a_t) → (Δo_t, r_t) 를 예측하는 MLP. 이것이 우리의 첫 World Model 이다."""

    def __init__(self, obs_dim: int = 3, act_dim: int = 1, hidden: int = 128):
        super().__init__()
        self.obs_dim, self.act_dim = obs_dim, act_dim
        self.net = nn.Sequential(
            nn.Linear(obs_dim + act_dim, hidden),
            nn.SiLU(),
            nn.Linear(hidden, hidden),
            nn.SiLU(),
            nn.Linear(hidden, hidden),
            nn.SiLU(),
            nn.Linear(hidden, obs_dim + 1),  # Δo 3개 + 보상 1개
        )
        # 표준화 통계. buffer 로 두면 학습은 되지 않지만 .to(device) · 저장 때 함께 따라간다.
        self.register_buffer("in_mean", torch.zeros(obs_dim + act_dim))
        self.register_buffer("in_std", torch.ones(obs_dim + act_dim))
        self.register_buffer("out_mean", torch.zeros(obs_dim + 1))
        self.register_buffer("out_std", torch.ones(obs_dim + 1))

    def set_normalizer(self, inputs: np.ndarray, targets: np.ndarray) -> None:
        """학습 데이터로 열마다 평균 μ 와 표준편차 σ 를 구해 둔다 (x̃ = (x − μ) / σ)."""
        dev = self.in_mean.device
        self.in_mean.copy_(torch.as_tensor(inputs.mean(0), device=dev))
        self.in_std.copy_(torch.as_tensor(inputs.std(0) + 1e-6, device=dev))
        self.out_mean.copy_(torch.as_tensor(targets.mean(0), device=dev))
        self.out_std.copy_(torch.as_tensor(targets.std(0) + 1e-6, device=dev))

    def forward_normalized(self, obs: torch.Tensor, act: torch.Tensor) -> torch.Tensor:
        """표준화된 공간에서의 예측 ỹ (학습할 때 쓴다). obs (B, 3), act (B, 1) → (B, 4)."""
        x = torch.cat([obs, act], dim=-1)
        x = (x - self.in_mean) / self.in_std
        return self.net(x)

    def predict(self, obs: torch.Tensor, act: torch.Tensor):
        """원래 단위의 예측: 다음 관측 ô_{t+1} = o_t + Δô_t 와 보상 r̂_t."""
        y = self.forward_normalized(obs, act) * self.out_std + self.out_mean
        next_obs = obs + y[..., : self.obs_dim]
        reward = y[..., self.obs_dim]
        return next_obs, reward
-
self.net: 입력 4개 → 너비 128 인 은닉층 3개 → 출력 4개(\(\Delta o\) 3개 + 보상 1개)의 MLP 다. 활성 함수는 SiLU(Sigmoid Linear Unit, Swish) \(\mathrm{SiLU}(x) = x\cdot\sigma(x) = \frac{x}{1+e^{-x}}\) 다. ReLU 와 비슷하지만 0 근처에서 매끄러워 매끄러운 물리 법칙을 흉내 내기에 알맞다. - 매개변수 수: 첫 층 \(4\times128 + 128 = 640\), 둘째와 셋째 층 각각 \(128\times128 + 128 = 16{,}512\), 마지막 층 \(128\times4 + 4 = 516\), 합계 \(640 + 16{,}512 \times 2 + 516 = 34{,}180\) 개다.
-
register_buffer: 표준화 통계 \(\mu_x, \sigma_x, \mu_y, \sigma_y\) 를 모델 안에 보관한다. 경사 하강법으로 바뀌지 않지만model.to("cuda")나torch.save때 가중치와 함께 따라다닌다. -
forward_normalized: 표준화된 입력 \(\tilde x\) 에서 표준화된 출력 \(\tilde y\) 를 낸다. 학습은 이 공간에서 한다. -
predict: 사용할 때의 함수다. \(\hat o_{t+1} = o_t + [\tilde y\odot\sigma_y + \mu_y]_{1:3}\), \(\hat r_t = [\tilde y\odot\sigma_y + \mu_y]_4\) 를 돌려준다.
- cos² + sin² = 1 이 깨진다
- 모델이 \(\cos\theta\) 와 \(\sin\theta\) 를 따로 예측하므로 \(\hat c^2 + \hat s^2\) 이 정확히 1 이 아닐 수 있고, 여러 스텝 이어 붙이면 차이가 커질 수 있다. 이 장에서는 그대로 두고 각도를 되살릴 때 두 값의 비율만 보는
atan2를 써서 영향을 줄인다. 예측 뒤에 \((\hat c, \hat s)\) 를 길이 1 로 나눠 주는 방법도 있다.
손실 함수: MSE 는 가우시안 최대우도다
손실은 표준화된 공간의 평균 제곱 오차(mean squared error, MSE)다.
\(\mathcal{L}(\theta) = \frac{1}{N D}\sum_{i=1}^{N}\sum_{d=1}^{D} \big(\tilde y_{i,d} - f_\theta(\tilde x_i)_d\big)^2 \qquad (D = 4)\)
제곱을 쓰는 이유는 2장의 최대우도에서 나온다. "진짜 값 = 모델의 예측 + 가우시안 잡음"이라고 가정한다.
\(\tilde y = f_\theta(\tilde x) + \epsilon, \qquad \epsilon \sim \mathcal{N}(0, \sigma^2)\)
그러면 \(p_\theta(\tilde y \mid \tilde x) = \mathcal{N}\big(\tilde y;\ f_\theta(\tilde x),\ \sigma^2\big)\) 이고, 음의 로그 가능도(NLL)는 다음과 같이 풀린다(\(\hat y_i := f_\theta(\tilde x_i)\), 출력 한 차원 기준).
\(\begin{align} p_\theta(\tilde y_i \mid \tilde x_i) &= \frac{1}{\sqrt{2\pi\sigma^2}}\exp\left(-\frac{(\tilde y_i - \hat y_i)^2}{2\sigma^2}\right) \\ -\log p_\theta(\tilde y_i \mid \tilde x_i) &= \frac12\log(2\pi\sigma^2) + \frac{(\tilde y_i - \hat y_i)^2}{2\sigma^2} \\ \mathrm{NLL}(\theta) &= \frac{1}{2\sigma^2}\sum_{i=1}^N(\tilde y_i - \hat y_i)^2 + \frac{N}{2}\log(2\pi\sigma^2) \\ \operatorname*{arg\,min}_\theta \mathrm{NLL}(\theta) &= \operatorname*{arg\,min}_\theta \sum_{i=1}^N (\tilde y_i - \hat y_i)^2 = \operatorname*{arg\,min}_\theta\ \mathrm{MSE}(\theta) \end{align}\)
\(\sigma\) 를 고정하면 둘째 항은 \(\theta\) 와 무관한 상수이고 \(\frac{1}{2\sigma^2}\) 은 양수 배율이라 최솟값의 위치가 바뀌지 않는다. 출력이 \(D\) 차원이고 차원마다 독립인 같은 크기의 잡음을 가정하면 \(\sum_d\) 가 하나 더 붙을 뿐 결론은 같다.
- MSE 를 쓰면 "잡음은 가우시안이고 그 크기는 모든 곳에서 같다"고 가정한 것이다. 진자는 결정적이라 이 가정이 크게 문제 되지 않는다. 7장에서는 \(\sigma\) 까지 모델이 예측하는 확률적 모델로 넓힌다.
- 기울기는 \(\frac{\partial}{\partial \hat y}(\hat y - y)^2 = 2(\hat y - y)\) 다. 예측이 정답보다 0.3 크면 기울기는 0.6 이고, 많이 틀릴수록 많이 고친다.
학습
train_model 은 먼저 model.set_normalizer(inputs, targets) 로 학습 데이터의 통계를 정하고, 정답도 같은 통계로 표준화해 y = (targets - model.out_mean) / model.out_std 를 만든다. 아래는 그 뒤의 학습 루프다(전체는 ch06_dynamics.py 의 train 구간).
    opt = torch.optim.Adam(model.parameters(), lr=lr)
    history = {"train": [], "val": []}
    n = len(o)
    for epoch in range(1, epochs + 1):
        model.train()
        perm = torch.randperm(n, device=device)  # 매 에폭 순서를 섞는다
        total = 0.0
        for i in range(0, n, batch_size):
            idx = perm[i : i + batch_size]
            pred = model.forward_normalized(o[idx], a[idx])  # (B, 4)
            loss = ((pred - y[idx]) ** 2).mean()  # MSE
            opt.zero_grad()
            loss.backward()
            opt.step()
            total += loss.item() * len(idx)
        history["train"].append(total / n)
| 항목 | 값 |
| 최적화 | Adam, |
| 에폭 | 100 ( |
| 배치 크기 | 256. 10,000 개면 에폭당 40번 갱신한다. |
| 손실 | 표준화된 공간의 1스텝 MSE |
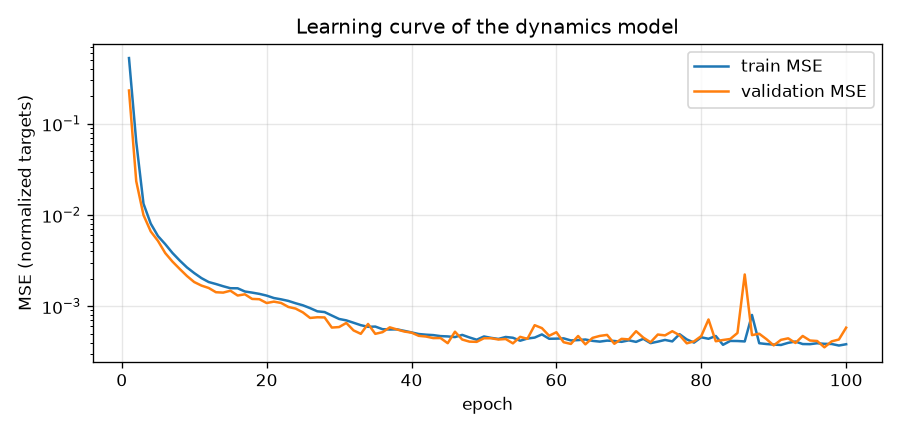
| 검증 | 학습에 쓰지 않은 검증 데이터의 MSE 를 매 에폭 잰다. 학습 손실만 줄고 검증 손실이 늘면 과적합(overfitting)이다. |
epoch    1 | train MSE 0.52619 | val MSE 0.23190
epoch   10 | train MSE 0.00231 | val MSE 0.00184
epoch   20 | train MSE 0.00131 | val MSE 0.00108
epoch   30 | train MSE 0.00073 | val MSE 0.00059
epoch   40 | train MSE 0.00052 | val MSE 0.00051
epoch   50 | train MSE 0.00047 | val MSE 0.00045
epoch   60 | train MSE 0.00044 | val MSE 0.00052
epoch   70 | train MSE 0.00042 | val MSE 0.00043
epoch   80 | train MSE 0.00046 | val MSE 0.00047
epoch   90 | train MSE 0.00038 | val MSE 0.00037
epoch  100 | train MSE 0.00038 | val MSE 0.00058
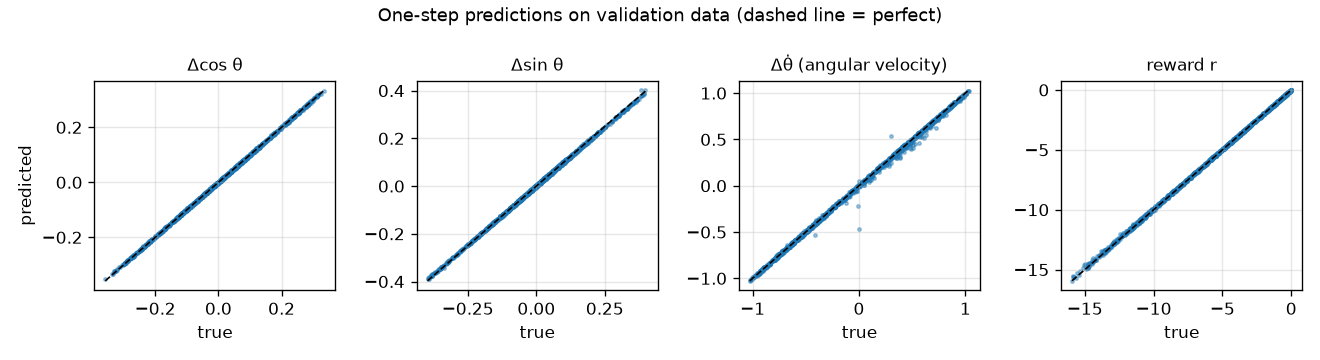
one-step accuracy on validation data:
  d_cos    RMSE 0.00161  (target std 0.1412)  R^2 0.99987
  d_sin    RMSE 0.00275  (target std 0.1470)  R^2 0.99965
  d_thdot  RMSE 0.02024  (target std 0.5686)  R^2 0.99873
  reward   RMSE 0.06770  (target std 4.0399)  R^2 0.99972
표준화된 정답의 분산이 1 이므로 평균만 내는 모델의 MSE 가 약 1 이다. 100 에폭 뒤 MSE 는 0.0004 안팎으로, 분산의 0.04% 만 설명하지 못한다. 검증 손실이 학습 손실을 따라가므로 과적합은 보이지 않는다. 검증 손실의 작은 출렁임은 Adam 의 스텝이 들쭉날쭉해서 생긴다.
1스텝 예측의 정확도
\(y_i\) 는 정답, \(\hat y_i\) 는 예측, \(\bar y\) 는 정답의 평균이다.
\(\mathrm{RMSE} = \sqrt{\frac1N\sum_{i}(\hat y_i - y_i)^2}, \qquad R^2 = 1 - \frac{\sum_i (\hat y_i - y_i)^2}{\sum_i (y_i - \bar y)^2}\)
RMSE 는 평균적으로 틀리는 정도를 원래 단위로 나타낸다. \(R^2\) 의 분모는 평균 \(\bar y\) 하나로 모두 찍었을 때의 오차, 분자는 모델의 오차다. \(R^2 = 1\) 이면 오차가 없고 \(R^2 = 0\) 이면 평균 찍기와 같은 수준이다.
- \(\Delta\dot\theta\) 의 RMSE 는 0.020 으로, 검증 정답의 표준편차 0.569 에 비해 작아 \(R^2 = 0.9987\) 이다. 보상도 \(R^2 = 0.9997\) 이다. 모델은 물리 법칙을 보지 않고 데이터만으로 운동 방정식을 거의 그대로 흉내 냈다.
- \(\Delta\dot\theta\) 에서 벗어난 점의 상당수는 각속도가 \(\pm 8\) 에서 잘리는 순간이다. 검증 데이터 2,000 개 가운데 이런 순간 18개의 평균 오차는 0.114 로 나머지(0.008)의 약 15배이고, 오차가 가장 큰 20개 가운데 8개가 여기에 속한다. 잘림은 매끄럽지 않은 규칙이라 MLP 가 흉내 내기 어렵다.
- 그림: 검증 데이터의 정답 대 예측 산점도 네 개. 점이 거의 모두 대각선 위에 놓인다
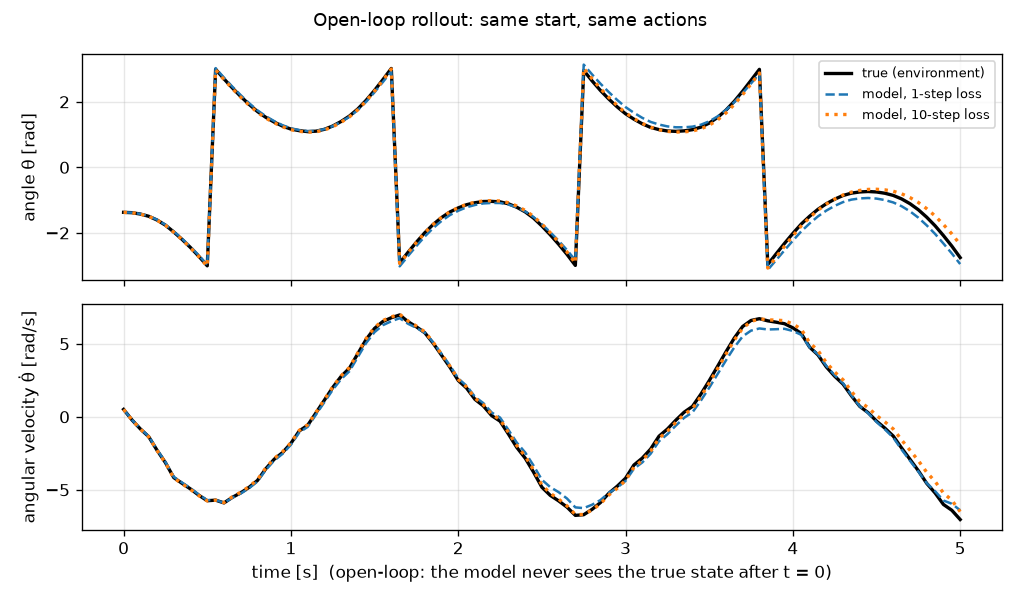
열린 고리 롤아웃
World Model 의 쓰임새는 여러 스텝 앞을 상상하는 것이다. 시작 관측 \(o_0\) 하나와 행동열 \(a_0, \dots, a_{H-1}\) 만 주고 모델의 예측을 다시 모델의 입력으로 넣어 \(H\) 스텝을 굴린다.
\(\hat o_1 = f_\theta(o_0, a_0),\quad \hat o_2 = f_\theta(\hat o_1, a_1),\quad \dots,\quad \hat o_H = f_\theta(\hat o_{H-1}, a_{H-1})\)
중간에 진짜 관측을 다시 보지 않으므로 열린 고리 롤아웃(open-loop rollout)이라 한다. 매 스텝 진짜 관측을 보고 다시 시작하는 것은 닫힌 고리(closed-loop), 곧 되먹임(feedback)이 있는 방식이다. 진짜 관측은 처음에만 쓰이므로 한 번 생긴 오차가 다음 스텝으로 넘어간다.
@torch.no_grad()
def rollout(model, obs0, actions):
    """열린 고리(open-loop) 롤아웃: 시작 관측과 행동열만 주고, 모델의 예측을 다시 입력으로 넣어 H 스텝을 상상한다.

    obs0 (B, 3), actions (B, H, 1) → 예측 관측 (B, H+1, 3), 예측 보상 (B, H)
    진짜 관측은 시작할 때 한 번만 본다. 그 뒤로는 모델이 만든 '상상' 만 이어진다.
    """
    o = obs0
    obs_seq, rew_seq = [o], []
    for k in range(actions.shape[1]):
        o, r = model.predict(o, actions[:, k])
        obs_seq.append(o)
        rew_seq.append(r)
    return torch.stack(obs_seq, dim=1), torch.stack(rew_seq, dim=1)
o, r = model.predict(o, actions[:, k]) 에서 o 가 자기 자신의 예측으로 덮어씌워지는 것이 핵심이다. 배치 차원 B 로 여러 롤아웃을 한꺼번에 계산하고, @torch.no_grad() 로 기울기 기록을 끈다.
검증 에피소드 하나를 100 스텝(5초) 열린 고리로 굴리면 처음 2초쯤까지는 진짜 궤적과 거의 겹치고, 그 뒤 1스텝 손실 모델부터 조금씩 벌어진다.
오차 누적 분석
롤아웃이 길어질수록 진짜와 멀어지는 현상을 오차 누적(compounding error)이라 한다. 행동을 생략하고 진짜 환경을 \(s_{k+1} = f(s_k)\), 모델을 \(\hat s_{k+1} = \hat f(\hat s_k)\), \(k\) 스텝 뒤의 오차를 \(e_k = \lVert\hat s_k - s_k\rVert\) 로 쓴다. 가정은 두 가지다.
- 1스텝 오차가 작다: 모든 \(s\) 에서 \(\lVert\hat f(s) - f(s)\rVert \le \varepsilon\).
- 모델이 립시츠 연속이다: 모든 \(s, s'\) 에서 \(\lVert\hat f(s) - \hat f(s')\rVert \le L\,\lVert s - s'\rVert\). \(L\) 을 립시츠 상수(Lipschitz constant)라 한다. \(L \gt 1\) 이면 작은 차이가 한 스텝마다 최대 \(L\) 배로 커질 수 있고, \(L \lt 1\) 이면 줄어든다.
점화식
같은 값 \(\hat f(s_k)\) 를 빼고 더해 오차를 "출발점이 달라서 생긴 부분"과 "모델이 틀려서 생긴 부분"으로 나눈 뒤 삼각 부등식을 쓴다.
\(\begin{align} e_{k+1} &= \lVert\hat f(\hat s_k) - f(s_k)\rVert \\ &= \lVert\hat f(\hat s_k) - \hat f(s_k) + \hat f(s_k) - f(s_k)\rVert \\ &\le \lVert\hat f(\hat s_k) - \hat f(s_k)\rVert + \lVert\hat f(s_k) - f(s_k)\rVert \\ &\le L\,e_k + \varepsilon \end{align}\)
상한
점화식을 차례로 대입하면 \(e_0\) 앞에는 \(L^k\), 그 뒤에 \(\varepsilon\) 이 \(L^{k-1}, \dots, L, 1\) 배로 붙는다. 등비수열의 합 \(S = \sum_{j=0}^{k-1}L^j\) 는 \(LS - S = L^k - 1\) 에서 구한다.
\(\begin{align} e_k &\le L^k e_0 + \varepsilon\sum_{j=0}^{k-1}L^j \\ &= L^k e_0 + \varepsilon\,\frac{L^k - 1}{L - 1} \qquad (L \ne 1) \end{align}\)
롤아웃은 진짜 관측에서 출발하므로 보통 \(e_0 = 0\) 이고, 상한은 1스텝 오차 \(\varepsilon\) 에 증폭 계수 \(\frac{L^k-1}{L-1}\) 을 곱한 값이다.
| 경우 | 상한 | 뜻 | 예: \(\varepsilon = 0.01\), \(k = 20\) |
| \(L \lt 1\) (차이를 줄이는 모델) | \(\varepsilon\frac{1 - L^k}{1-L} \lt \frac{\varepsilon}{1-L}\) | 오차가 일정 값 아래에 머문다. | \(L = 0.9\): \(0.01\times\frac{1-0.9^{20}}{0.1} = 0.088\) |
| \(L = 1\) | \(k\,\varepsilon\) | 오차가 스텝 수에 비례해 늘어난다. | \(0.01\times 20 = 0.2\) |
| \(L \gt 1\) (차이를 키울 수 있는 모델) | \(\varepsilon\frac{L^k - 1}{L-1}\) | 오차가 지수적으로 커진다. | \(L = 1.1\): \(0.01\times\frac{1.1^{20}-1}{0.1} = 0.573\) |
\(1.1^{20} \approx 6.727\), \(0.9^{20} \approx 0.122\) 다. 같은 1스텝 오차라도 \(L = 1.1\) 이면 20 스텝 뒤 상한이 \(L = 0.9\) 일 때의 6배가 넘는다. 오차 누적은 모델이 나빠서만이 아니라 세상 자체가 작은 차이를 키우는 성질을 가질 때 특히 심해진다.
진자가 작은 차이를 키우는 정도
똑바로 선 자세 근처(\(\theta \approx 0\))에서 \(\sin\theta \approx \theta\), \(u = 0\) 으로 두면 반암시적 오일러 한 스텝은 다음과 같다(\(15\Delta t = 0.75\)).
\(\dot\theta_{t+1} = \dot\theta_t + 0.75\,\theta_t, \qquad \theta_{t+1} = \theta_t + 0.05\,\dot\theta_{t+1} = 1.0375\,\theta_t + 0.05\,\dot\theta_t\)
\(\begin{pmatrix}\theta_{t+1}\\ \dot\theta_{t+1}\end{pmatrix} = A\begin{pmatrix}\theta_t\\ \dot\theta_t\end{pmatrix}, \qquad A = \begin{pmatrix}1.0375 & 0.05\\ 0.75 & 1\end{pmatrix}\)
작은 차이가 여러 스텝에 걸쳐 한 스텝마다 평균 몇 배씩 되는지는 \(A\) 의 고윳값이 알려 준다.
\((1.0375 - \lambda)(1 - \lambda) - 0.05\times0.75 = 0 \ \Rightarrow\ \lambda^2 - 2.0375\lambda + 1 = 0 \ \Rightarrow\ \lambda = \frac{2.0375 \pm 0.3891}{2}\)
- 위에 선 자세: \(\lambda_1 \approx 1.2133\), \(\lambda_2 \approx 0.8242\). 작은 차이가 길게 보면 한 스텝마다 약 1.21 배 커지고, 20 스텝(1초) 뒤면 \(1.2133^{20} \approx 47.8\) 배다.
- 매달린 자세(\(\theta \approx \pi\)): \(\lambda^2 - 1.9625\lambda + 1 = 0\) 이 되고 판별식 \(1.9625^2 - 4 \lt 0\) 이라 두 고윳값은 크기가 정확히 1 인 복소수다. 차이가 커지지도 줄지도 않고 진동한다.
- 그래서 같은 모델이라도 진자를 세우는 순간을 상상할 때 오차가 가장 빨리 커진다. 잘 배운 모델도 진짜 진자의 이 성질을 그대로 흉내 낸다.
- 고윳값과 립시츠 상수는 같은 것이 아니다. \(L\) 은 한 스텝에서 최악의 경우 몇 배까지 커질 수 있는가이고(보통의 벡터 길이로 재면 위 \(A\) 에서 약 1.48, 매달린 자세에서도 약 1.41), 고윳값은 여러 스텝을 이어 갈 때 실제로 한 스텝마다 평균 몇 배씩 커지는가다. 상한 \(\varepsilon\frac{L^k-1}{L-1}\) 은 넉넉하게 잡은 값이고, 길게 굴릴 때 오차가 실제로 불어나는 속도는 고윳값이 정한다.
실험
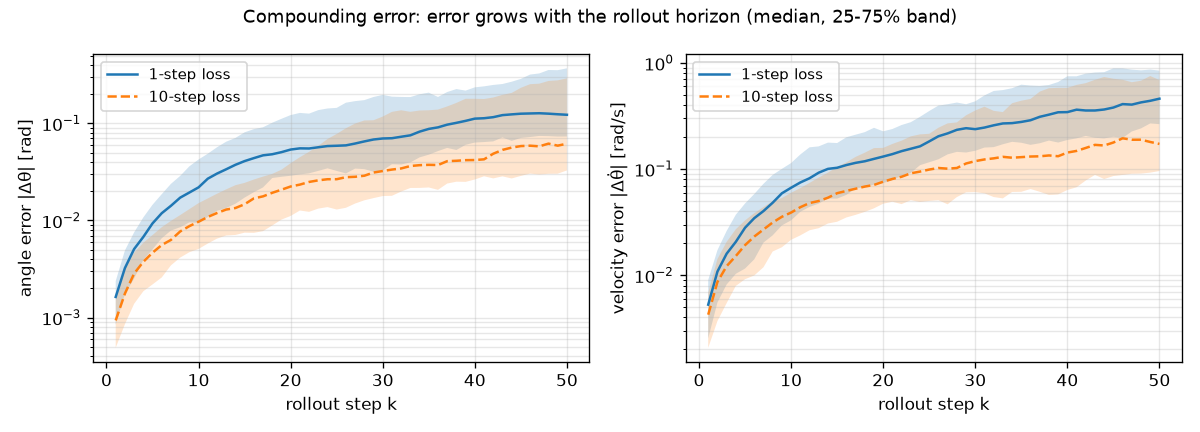
검증 에피소드의 임의 시점 300곳에서 출발해 기록된 행동으로 50 스텝 롤아웃하고, 각 스텝 \(k\) 에서 각도 오차 \(\lvert\hat\theta - \theta\rvert\) 와 각속도 오차를 잰다(horizon_errors, horizon=50, n_starts=300). 각도는 np.arctan2(obs[..., 1], obs[..., 0]) 로 되살리고, 차이는 angle_normalize 로 \([-\pi, \pi)\) 에 접어서 잰다.
| 스텝 \(k\) | 1스텝 손실: 각도 [rad] | 1스텝 손실: 각속도 | 10스텝 손실: 각도 [rad] | 10스텝 손실: 각속도 |
| 1 | 0.0016 | 0.0053 | 0.0009 | 0.0043 |
| 5 | 0.0093 | 0.0280 | 0.0047 | 0.0192 |
| 10 | 0.0219 | 0.0667 | 0.0097 | 0.0389 |
| 20 | 0.0538 | 0.1311 | 0.0224 | 0.0760 |
| 30 | 0.0700 | 0.2375 | 0.0323 | 0.1188 |
| 50 | 0.1228 | 0.4600 | 0.0618 | 0.1724 |
값은 모두 중앙값이다. 1스텝 손실 모델의 각속도 오차는 1 스텝에서 0.0053 이지만 50 스텝에서 0.46 으로 약 87배 커졌다. 25–75% 구간의 띠가 넓은데, 출발점에 따라(특히 위쪽 자세를 지나는지에 따라) 오차의 증가 속도가 크게 다르기 때문이다. 7장의 계획은 25 스텝 정도를 내다보므로 이 정도 오차라면 대략 맞는 상상으로 쓸 수 있다.
오차 누적을 줄이는 방법
다스텝 손실
1스텝 손실로 학습할 때 모델은 늘 진짜 관측을 입력으로 받지만 롤아웃할 때는 자기 예측을 입력으로 받는다. 조금씩 어긋난 입력에서의 동작을 배운 적이 없다. 그래서 학습할 때도 롤아웃을 하고 그 오차를 직접 줄인다.
\(\mathcal{L}_{k\text{-step}}(\theta) = \frac{1}{k}\sum_{j=1}^{k}\left[\ \big\lVert\, (\hat o_{t+j} - o_{t+j}) \oslash \sigma_{\Delta o} \big\rVert^2 + \Big(\frac{\hat r_{t+j-1} - r_{t+j-1}}{\sigma_r}\Big)^2\ \right]\)
\(\hat o_{t+j} = f_\theta(\hat o_{t+j-1}, a_{t+j-1}),\qquad \hat o_t = o_t\)
\(\oslash\) 는 원소별 나눗셈이다. 오차를 \(\Delta o\) 의 표준편차 단위로 재서 1스텝 손실과 크기를 맞췄고, 코드에서는 여기에 4 로 나눈 평균을 쓴다. \(k = 1\) 이면 1스텝 손실과 같다. \(\hat o_{t+j}\) 가 모델 자신의 예측이고 그 예측을 거쳐 기울기도 흐른다. "지금 조금 틀리면 몇 스텝 뒤에 크게 틀린다"는 정보가 앞 스텝의 가중치 갱신에 전달된다.
    ow, aw, rw = (to_tensor(x, device) for x in make_windows(train_eps, k))
    scale_o, scale_r = model.out_std[:3], model.out_std[3]

    opt = torch.optim.Adam(model.parameters(), lr=lr)
    history = []
    n = len(ow)
    for epoch in range(1, epochs + 1):
        perm = torch.randperm(n, device=device)
        total = 0.0
        for i in range(0, n, batch_size):
            idx = perm[i : i + batch_size]
            o = ow[idx, 0]  # 진짜 관측은 첫 스텝에서만 쓴다
            loss = 0.0
            for j in range(k):
                o, r = model.predict(o, aw[idx, j])  # 예측을 다음 입력으로 (기울기도 그대로 흐른다)
                err_o = (o - ow[idx, j + 1]) / scale_o
                err_r = (r - rw[idx, j]) / scale_r
                loss = loss + (err_o.pow(2).sum(-1) + err_r.pow(2)).mean() / 4
            loss = loss / k
            opt.zero_grad()
            loss.backward()
            opt.step()
            total += loss.item() * len(idx)
make_windows(episodes, k) 는 에피소드를 길이 \(k\) 의 조각으로 잘라 관측 (N, k+1, 3), 행동 (N, k, 1), 보상 (N, k) 를 만든다. 본문 실험은 train_multistep(model_ms, train_eps, k=10, ...) 로, 같은 데이터, 같은 모델 크기, 같은 에폭이다.
- 50 스텝 뒤 오차 중앙값이 각도 \(0.123 \to 0.062\), 각속도 \(0.46 \to 0.17\) 로 줄어든다. 각도는 절반쯤, 각속도는 3분의 1 남짓이다. 1 스텝 오차도 조금 줄었다.
- 학습 한 스텝에 모델을 \(k\) 번 통과하므로 학습 시간이 대략 \(k\) 배 든다.
그 밖의 방법
- 짧게 상상하고 자주 다시 보기: 짧은 구간만 상상하고 매 스텝 진짜 관측으로 다시 시작한다. 7장의 MPC 가 이 방법이다.
- 불확실성을 알기: 모델이 잘 모르는 곳을 표현할 수 있으면 그런 곳의 상상을 덜 믿을 수 있다. 7장 후반의 확률적 앙상블이다.
- 필요한 곳의 데이터 더 모으기: 모델을 써서 행동하며 데이터를 모으면 실제로 가게 될 상태(위로 선 자세 등) 주변의 데이터가 늘어난다(7장).
- 좋은 잠재 공간에서 예측하기: 관측 대신 압축된 잠재 상태에서 예측하면 예측 대상이 단순해진다. 8–12장의 주제다.
이 모델의 쓰임새
학습한 모델은 진자의 시뮬레이터 역할을 하며, 진짜 환경과 달리 다음이 가능하다.
- 한 번에 수백 개의 미래를 배치로 동시에 상상할 수 있다.
- 실패해도 진자가 부서지지 않는다. 실제 로봇이라면 중요한 성질이다.
- 신경망이라 미분할 수 있어서 기울기를 이용한 최적화에 쓸 수 있다(12장의 Dreamer).
7장에서는 수백 개의 행동열을 상상으로 시험하고 가장 좋은 것을 골라 실행하는 계획으로 진자를 세운다.
바꿔 볼 실험
-
--episodes 5로 데이터를 1/10 로 줄여 1스텝 오차와 다스텝 오차의 변화를 본다. -
make_inputs_targets의 정답을next_obs - obs대신next_obs로 바꾸고predict에서obs +를 지워 다음 상태를 통째로 예측하게 한 뒤 1스텝 RMSE 를 비교한다. -
set_normalizer에서 표준화를 끄고(평균 0, 표준편차 1 로 고정) 학습 곡선을 비교한다. -
train_multistep의k를 1, 3, 20 으로 바꿔 지평별 오차 그림의 변화를 본다.
정리
- 진자의 운동 방정식 \(\ddot\theta = \frac{3g}{2l}\sin\theta + \frac{3}{ml^2}u\) 는 \(\tau = I\ddot\theta\), \(I = \frac13ml^2\), 중력 토크 \(\frac{l}{2}mg\sin\theta\) 에서 나온다. 환경은 이것을 반암시적 오일러로 \(\Delta t = 0.05\) 씩 계산한다.
- World Model 학습은 \([o_t, a_t] \mapsto [o_{t+1}, r_t]\) 의 회귀 문제다. 각도는 이음매가 없는 \((\cos\theta, \sin\theta)\) 로 다룬다.
- 표준화(열마다 평균 0, 표준편차 1)와 변화량 \(\Delta o\) 예측이 학습을 쉽게 한다. 통계는 학습 데이터로만 구한다.
- MSE 최소화는 분산이 고정된 가우시안 잡음을 가정한 최대우도 학습과 같다.
- 매개변수 34,180 개의 MLP 가 1스텝을 \(R^2 \approx 0.999\) 로 맞혔지만 열린 고리 롤아웃에서는 오차가 쌓인다. 상한은 \(e_k \le \varepsilon\frac{L^k - 1}{L - 1}\) 로 \(L \gt 1\) 이면 지수적으로 커질 수 있고, 실제로는 불안정한 곳(진자가 서 있는 자세, 고윳값 약 1.21)에서 가장 빨리 커진다.
- 다스텝 손실로 학습하면 롤아웃 오차가 절반 안팎으로 줄어든다. 짧게 상상하고 자주 다시 보는 MPC 는 7장에서 다룬다.
확인 문제
- 반암시적 오일러 한 스텝
- \(\theta_0 = \pi/2\), \(\dot\theta_0 = 0\), \(u = 0\), \(\Delta t = 0.05\) 이면 \(\ddot\theta_0 = 15\), \(\dot\theta_1 = 0.75\), \(\theta_1 = 1.5708 + 0.0375 = 1.6083\) 이다. 명시적 오일러였다면 \(\theta_1 = 1.5708\) 로 각도가 그대로다.
- 가운데를 축으로 하는 막대의 관성 모멘트
- \(I = \int_{-l/2}^{l/2} r^2\frac{m}{l}dr = \frac{m}{l}\cdot\frac13\left(\frac{l^3}{8} + \frac{l^3}{8}\right) = \frac{1}{12}ml^2\). 끝을 축으로 할 때의 \(\frac14\) 로, 질량이 축 가까이 모일수록 돌리기 쉽다.
- 막대를 붙잡아 둘 수 있는 각도 (\(\lvert u\rvert \le 2\))
- \(15\sin\theta + 3u = 0\) 에서 \(u = -5\sin\theta\) 이므로 \(\lvert\sin\theta\rvert \le 0.4\) 여야 한다. \(\arcsin 0.4 \approx 0.4115\) rad \(\approx 23.6^\circ\) 이므로 똑바로 선 자세에서 약 \(\pm 23.6^\circ\) 이내이거나 매달린 자세에서 약 \(\pm 23.6^\circ\) 이내(\(\lvert\theta\rvert \ge \pi - 0.4115\))다. 그 사이 각도에서는 흔들어서 지나가야 한다.
- 표준화 되돌리기 (\(\mu = 2\), \(\sigma = 0.5\), \(\tilde y = -1.2\), 표준화 공간 MSE 0.0004)
- \(y = -1.2\times0.5 + 2 = 1.4\). 오차는 \(e = \tilde e\,\sigma\) 관계이므로 원래 단위의 RMSE 는 \(\sqrt{0.0004}\times0.5 = 0.01\) 이다.
- 오차 상한 (\(\varepsilon = 0.005\), \(L = 1.2\), \(e_0 = 0\), 10 스텝)
- \(e_{10} \le 0.005\times\frac{1.2^{10}-1}{1.2-1} = 0.005\times\frac{5.19}{0.2} \approx 0.13\). 1스텝 오차의 약 26배다.
- 1스텝 오차가 작은데도 롤아웃 오차가 커지는 이유
- 학습 때의 입력은 언제나 진짜 관측 \(o_t\) 이고 롤아웃할 때의 입력은 조금씩 틀린 자기 예측 \(\hat o_t\) 다. 모델은 어긋난 입력의 분포를 학습 때 보지 못했으므로 거기서의 정확도가 보장되지 않고, 어긋남이 다음 스텝으로 넘어가며 커진다(학습 분포와 사용 분포의 차이, distribution shift). 다스텝 손실은 학습 때도 자기 예측을 입력으로 넣어 이 차이를 줄인다.
See also
- World Models:Tutorial
- World Models
- Reinforcement learning
- Maximum likelihood estimation
- Normal distribution
- Backpropagation
- PyTorch