WorldModels:Tutorial:09-MDN-RNN
lastmod 2026-11-18created 2026-11-172 edits
기억 만들기: RNN 과 MDN-RNN은 World Model 튜토리얼의 9장이다. 8장의 VAE 는 그림 한 장을 32개의 숫자 \(z\) 로 요약하지만, 그림 한 장에는 진자가 어느 쪽으로 얼마나 빨리 도는지가 담겨 있지 않다. 이 장은 지나간 장면을 기억하는 순환 신경망(RNN)과 LSTM, 하나로 정해지지 않는 미래를 확률 분포로 예측하는 혼합 밀도 네트워크(MDN)를 다루고, 둘을 합친 MDN-RNN 으로 잠재 공간에서 미래를 꿈꾸는 모델을 만든다. Ha & Schmidhuber 의 World Models 에서 M(Memory)에 해당하며, 여기서 학습한 모델과 잠재 시퀀스는 10장이 이어서 쓴다.
- 원문: 09. 기억 만들기: RNN 과 MDN-RNN
- 실습 코드:
code/ch09_mdn_rnn.py(노트북 GPU 로 전체 약 2분 20초, CPU 4스레드로는 학습에만 약 20분.--quick은 연기 시험. 먼저 8장을 실행해ch08_vae.pt,ch08_episodes.npz를 만들어 두어야 한다) - 이전: 08. VAE / 다음: 10. Ha 와 Schmidhuber 의 World Models
그림 한 장으로는 부족하다
막대가 오른쪽으로 45° 기울어진 똑같은 그림이라도, 한쪽은 시계 방향으로 빠르게 떨어지는 중이고 다른 쪽은 거의 멈춰 있을 수 있다. 다음 장면은 전혀 다르지만 그림 한 장만 보는 에이전트는 둘을 구별하지 못한다. 5장에서 이런 상황을 부분 관측(partial observability), 이런 문제를 POMDP 라고 불렀다. 관측 \(o_t\) 가 상태 \(s_t = (\theta, \dot\theta)\) 를 다 담지 않는 것이다.
해결책은 지난 장면들을 함께 보는 것이다. 진자 환경의 물리는 각도를 \(\theta_t = \theta_{t-1} + \dot\theta_t\,\Delta t\) 로 갱신하므로(6장) 두 장면의 각도 차이를 \(\Delta t = 0.05\) 초로 나누면 속도가 정확히 나온다.
\(\dot\theta_t = \frac{\theta_t - \theta_{t-1}}{\Delta t}\)
일반적인 세상에서는 두 장면으로 부족할 수 있으므로(가속도, 가려진 물체, 오래전 사건) "지금까지 본 모든 것의 요약"을 들고 다니는 방법이 필요하다. 그 요약이 은닉 상태(hidden state) \(h_t\) 이고, 그것을 매 스텝 갱신하는 신경망이 순환 신경망(recurrent neural network, RNN)이다.
순환 신경망 RNN
식
가장 기본적인 RNN(Elman RNN)은 한 줄이다.
\(h_t = \tanh\big(W_h\,h_{t-1} + W_x\,x_t + b\big),\qquad y_t = W_y\,h_t + c\)
- \(x_t\): 시각 \(t\) 의 입력이다. MDN-RNN 에서는 \([z_t; a_t]\) 다.
- \(h_{t-1}\): 바로 전까지의 기억이다. 처음 \(h_0\) 은 0 벡터다.
- \(W_h, W_x, b\): 모든 시각에서 같은 가중치다(매개변수 공유). 같은 신경망을 되풀이해 쓰므로 길이가 다른 시퀀스에도 쓸 수 있다.
- \(\tanh\): 결과를 -1 ~ 1 로 눌러 기억이 끝없이 커지지 않게 한다.
- \(y_t\): 그 시각의 출력(예측)이다.
숫자 예
1차원 RNN 에서 \(W_h = 0.5\), \(W_x = 1\), \(b = 0\) 이고 입력이 \(x = (1, 0, 0)\) 이면 다음과 같다.
\(\begin{align} h_1 &= \tanh(0.5 \cdot 0 + 1 \cdot 1) = \tanh(1) \approx 0.762 \\ h_2 &= \tanh(0.5 \cdot 0.762 + 1 \cdot 0) = \tanh(0.381) \approx 0.363 \\ h_3 &= \tanh(0.5 \cdot 0.363) = \tanh(0.182) \approx 0.180 \end{align}\)
입력이 0 이어도 지난 기억의 절반가량이 남지만, 스텝마다 대략 절반씩 줄어든다. 이 RNN 은 "1 을 봤다"는 사실을 몇 스텝밖에 기억하지 못한다. 이 빠른 망각은 아래의 기울기 소실과 같은 뿌리다.
시간 펼침
RNN 을 시간 방향으로 펼치면 같은 칸을 옆으로 이어 붙인 깊은 신경망이 된다. \(h_0 = 0\) 에서 출발해 칸마다 입력 \(x_t\) 를 받아 출력 \(y_t\) 를 내고 기억 \(h_t\) 를 오른쪽 칸으로 넘긴다. 모든 칸은 같은 가중치를 쓰며, 길이 \(T\) 의 시퀀스는 깊이 \(T\) 의 신경망이 된다.
BPTT 와 기울기 소실·폭발
시간을 거슬러 오는 역전파
펼친 RNN 은 깊은 신경망이므로 4장의 역전파를 그대로 쓴다. 기울기가 시간을 거꾸로 흐르므로 BPTT(backpropagation through time)라고 부른다(Backpropagation through time). 손실은 시각마다의 손실의 합 \(L = \sum_t L_t\) 이고, 같은 \(W_h\) 가 모든 시각에서 쓰였으므로 \(W_h\) 의 기울기는 모든 시각에서 온 기여의 합이다.
핵심 질문은 시각 \(T\) 의 손실이 훨씬 이전의 기억 \(h_k\) 에 얼마나 민감한가, 곧 \(\partial L_T / \partial h_k\) 다. 이것이 작으면 모델은 먼 과거와 지금의 관계를 배울 수 없다. 연쇄 법칙으로 단계마다의 변화율(벡터일 때는 야코비안 행렬)을 모두 곱한다.
\(\frac{\partial L_T}{\partial h_k} = \frac{\partial L_T}{\partial h_T}\,\frac{\partial h_T}{\partial h_{T-1}}\,\frac{\partial h_{T-1}}{\partial h_{T-2}}\cdots\frac{\partial h_{k+1}}{\partial h_k} = \frac{\partial L_T}{\partial h_T}\prod_{t=k+1}^{T}\frac{\partial h_t}{\partial h_{t-1}}\)
한 스텝 안에서는 \(h_t = \tanh(a_t)\), \(a_t = W_h h_{t-1} + W_x x_t + b\) 로 놓는다(이 유도의 \(a_t\) 는 행동이 아니라 tanh 에 들어가기 전의 값이다).
- \(\frac{d}{da}\tanh(a) = 1 - \tanh^2(a)\) 이고 tanh 는 성분마다 따로 적용되므로 \(\frac{\partial h_t}{\partial a_t} = \operatorname{diag}(1 - h_t^2)\) 다.
- \(a_t\) 는 \(h_{t-1}\) 에 대해 선형이므로 \(\frac{\partial a_t}{\partial h_{t-1}} = W_h\) 다.
\(\frac{\partial L_T}{\partial h_k} = \frac{\partial L_T}{\partial h_T}\prod_{t=k+1}^{T}\operatorname{diag}\big(1 - h_t^2\big)\,W_h\)
같은 모양의 행렬 \(\operatorname{diag}(1-h_t^2)W_h\) 를 \(T - k\) 번 곱한다. 행렬이므로 순서가 있어 \(t = T\) 인 것이 맨 왼쪽, \(t = k+1\) 인 것이 맨 오른쪽이다. 곱이 길어질수록 결과가 0 으로 가거나 무한히 커지기 쉽다.
tanh 의 미분은 \(\tanh a = N/D\), \(N = e^{a} - e^{-a}\), \(D = e^{a} + e^{-a}\) 로 놓으면 \(N' = D\), \(D' = N\) 이므로 몫의 미분법에서 나온다.
\(\Big(\frac{N}{D}\Big)' = \frac{N'D - ND'}{D^2} = \frac{D\cdot D - N\cdot N}{D^2} = 1 - \frac{N^2}{D^2} = 1 - \tanh^2 a\)
\(\vert\tanh a\vert\) 가 1 에 가까울수록(포화) 미분은 0 에 가깝다.
왜 사라지거나 터지는가
1차원에서 매 스텝 곱하는 수 \(w(1 - h_t^2)\) 의 크기를 대략 \(\rho\) 라고 하면 20 스텝 뒤에는 \(\rho^{20}\) 이 곱해진다.
| \(\rho\) | \(\rho^{20}\) | 현상 |
| 0.5 | \(0.5^{20} \approx 9.5 \times 10^{-7}\) | 기울기 소실(Gradient Vanishing). 20 스텝 전의 일은 기울기에 거의 흔적을 남기지 못한다. |
| 1.5 | \(1.5^{20} \approx 3325\) | 기울기 폭발(Gradient Exploding). 기울기가 수천 배로 부풀어 학습이 한 번에 튕겨 나간다. |
\(\tanh' = 1 - h^2 \le 1\) 이므로 기억이 포화되어(\(\vert h\vert \to 1\)) 있으면 곱하는 수가 더 작아져 소실이 더 잘 일어난다. 벡터일 때는 행렬 \(W_h\) 의 고윳값이 같은 역할을 한다. 고유벡터 \(v\) 는 \(Wv = \lambda v\) 를 만족하므로
\(W^2 v = W(\lambda v) = \lambda^2 v, \qquad W^n v = \lambda^n v\)
이다. 가장 큰 고윳값의 크기가 1 보다 작으면 모든 방향이 0 으로 줄고, 1 보다 크면 그 방향이 폭발한다.
기울기 자르기
폭발은 기울기 자르기(gradient clipping)로 막는다. 기울기 벡터 \(g\) 의 길이가 정해진 값 \(c\) 를 넘으면 방향은 두고 길이만 \(c\) 로 줄인다.
\(g \leftarrow g\cdot\min\Big(1, \frac{c}{\lVert g\rVert}\Big)\)
이 장의 코드는 clip_grad_norm_(model.parameters(), 1.0) 한 줄로 \(c = 1\) 을 쓴다. 소실은 자르기로 해결되지 않으므로 신경망 구조를 바꿔야 하며, 그것이 LSTM 이다.
LSTM: 게이트가 달린 기억
식과 게이트
LSTM(long short-term memory)(Hochreiter & Schmidhuber, 1997)은 기억을 둘로 나눈다. 오래 보관하는 셀 상태 \(c_t\) 와 밖으로 내보이는 은닉 상태 \(h_t\) 다. 셀 상태에 무엇을 지우고, 쓰고, 내보낼지는 세 개의 게이트(gate)가 정한다. 1997년의 원형에는 망각 게이트가 없었고 Gers 외(2000)가 덧붙였으며, 아래는 지금 표준으로 쓰는 형태다. \([h_{t-1}; x_t]\) 는 두 벡터를 이어 붙인 것, \(\sigma\) 는 시그모이드 \(\sigma(u) = \frac{1}{1+e^{-u}}\) (값이 0 ~ 1), \(\odot\) 는 원소별 곱이다. 이 절의 \(o_t\) 는 관측이 아니라 출력 게이트이고, \(\sigma\) 는 이 절에서만 시그모이드다(MDN 절부터는 다시 표준편차다).
\(\begin{align} f_t &= \sigma\big(W_f[h_{t-1}; x_t] + b_f\big) && \text{망각 게이트 (forget gate)} \\ i_t &= \sigma\big(W_i[h_{t-1}; x_t] + b_i\big) && \text{입력 게이트 (input gate)} \\ g_t &= \tanh\big(W_g[h_{t-1}; x_t] + b_g\big) && \text{새로 쓸 내용 (candidate)} \\ o_t &= \sigma\big(W_o[h_{t-1}; x_t] + b_o\big) && \text{출력 게이트 (output gate)} \\ c_t &= f_t \odot c_{t-1} + i_t \odot g_t && \text{셀 상태 갱신} \\ h_t &= o_t \odot \tanh(c_t) && \text{은닉 상태} \end{align}\)
- 망각 게이트 \(f_t\): 셀 상태의 각 칸을 얼마나 남길지 정한다(1 은 다 남김, 0 은 다 지움).
- 입력 게이트 \(i_t\) 와 후보 \(g_t\): 새 정보 \(g_t\) 를 얼마나 써 넣을지 정한다.
- 출력 게이트 \(o_t\): 셀 상태 중 무엇을 지금 밖(다음 층, 출력)에 보여 줄지 정한다.
게이트는 0 ~ 1 사이 값이라 밸브처럼 동작한다. 미분 가능하므로 무엇을 기억할지 자체를 데이터에서 배운다. 구조로 보면 입력 \([h_{t-1}; x_t]\) 가 세 게이트와 후보 모두에 들어가고, 셀 상태 \(c_{t-1} \to c_t\) 는 곱셈 한 번(\(\times f_t\))과 덧셈 한 번(\(+\, i_t \odot g_t\))만 거치는 직선 경로를 따라 흐른다. \(h_t\) 는 \(c_t\) 에 tanh 를 씌우고 \(o_t\) 를 곱해 나온다.
셀 상태가 기울기를 지키는 이유
갱신 식 \(c_t = f_t \odot c_{t-1} + i_t \odot g_t\) 에서 \(c_{t-1}\) 이 직접 나타나는 곳은 첫 항뿐이고, 원소별 곱의 미분은 곱하던 값이다.
\(\frac{\partial c_t}{\partial c_{t-1}} \approx \operatorname{diag}(f_t), \qquad \frac{\partial c_T}{\partial c_k} \approx \prod_{t=k+1}^{T}\operatorname{diag}(f_t)\)
\(f_t, i_t, g_t\) 도 \(h_{t-1}\) 을 거쳐 \(c_{t-1}\) 과 간접적으로 이어지지만 그 경로는 RNN 처럼 줄어드는 경로이고, 여기서는 직통 경로만 본다. 직통 경로에서 곱해지는 것은 망각 게이트 값뿐이며 가중치 행렬도 \(\tanh'\) 도 곱해지지 않는다.
- \(f_t \approx 1\) 이면 기울기가 거의 그대로 먼 과거까지 전달된다. 이때 갱신 식은 \(c_t \approx c_{t-1} + i_t\odot g_t\), 곧 지난 기억에 새것을 더하는 꼴이고 덧셈은 미분이 1 이라 기울기를 줄이지 않는다.
- RNN 은 매 스텝 행렬을 곱하고 tanh 로 눌러 기억을 덮어쓰지만, LSTM 은 필요한 만큼만 지우고 더하는 길을 따로 둔다. 이 덧셈 경로는 ResNet 의 잔차 연결, Transformer 의 잔차 흐름으로 이어진다.
- 실무에서는 망각 게이트의 편향 \(b_f\) 를 1 같은 양수로 초기화해 처음부터 잘 기억하는 쪽에서 출발시키기도 한다.
매개변수 수는 (게이트 세 개 + 후보 \(g_t\)) 네 묶음 × (가중치 + 편향)이다. 은닉 크기 \(H = 256\), 입력 크기 \(X = 32 + 1 = 33\) 이면 \(4 \times (256 \times 33 + 256 \times 256 + 256 + 256) = 297{,}984\) 개다(PyTorch 는 입력 쪽과 은닉 쪽에 편향을 하나씩, 두 벌 둔다).
GRU
GRU(gated recurrent unit)(Cho 외, 2014)는 셀 상태와 은닉 상태를 하나로 합치고 게이트를 두 개로 줄였다.
\(\begin{align} u_t &= \sigma\big(W_u[h_{t-1}; x_t] + b_u\big) && \text{갱신 게이트 (update gate)} \\ r_t &= \sigma\big(W_r[h_{t-1}; x_t] + b_r\big) && \text{리셋 게이트 (reset gate)} \\ \tilde{h}_t &= \tanh\big(W_h[r_t \odot h_{t-1}; x_t] + b_h\big) && \text{후보} \\ h_t &= u_t \odot h_{t-1} + (1 - u_t)\odot \tilde{h}_t && \text{섞기} \end{align}\)
새 기억은 옛 기억과 후보의 가중 평균이고, \(u_t \approx 1\) 이면 옛 기억이 그대로 지나간다(LSTM 의 \(f_t \approx 1\) 과 같은 효과). 매개변수가 LSTM 의 4분의 3 이고 성능은 비슷한 경우가 많아 11장의 RSSM(PlaNet, Dreamer)은 GRU 를 쓴다.
위 식은 Cho 외(2014) 논문의 출판본(EMNLP)을 따랐고 PyTorch 의 nn.GRU 도 \(u\) 를 같은 방향으로 쓴다. 흔한 변형이 두 가지 있다.
- Chung 외(2014)처럼 \(u\) 의 역할을 뒤집어 \(h_t = (1-u_t)\odot h_{t-1} + u_t\odot\tilde h_t\) 로 쓰는 문헌이 있다.
- PyTorch 는 후보를 만들 때 \(r_t\) 를 \(h_{t-1}\) 에 먼저 곱하지 않고 \(W h_{t-1}\) 을 계산한 뒤에 곱한다. Cho 외 논문의 arXiv 초판(v1)에 실렸던 형태다.
하나의 답과 분포
MSE 는 조건부 평균을 맞힌다
RNN 의 출력으로 다음 잠재 벡터 \(z_{t+1}\) 을 예측할 때 6장처럼 MSE 로 회귀하면 무엇을 맞히게 되는지 먼저 본다. 같은 입력 \(x\) 에 대해 정답 \(y\) 가 여러 값으로 흔들릴 때 하나의 예측 \(c\) 로 제곱 오차의 기댓값을 최소화한다.
\(\frac{d}{dc}\mathbb{E}\big[(y - c)^2\big] = \mathbb{E}\big[-2(y - c)\big] = -2\big(\mathbb{E}[y] - c\big) = 0 \quad\Rightarrow\quad c^\ast = \mathbb{E}[y \mid x]\)
둘째 미분이 \(2 \gt 0\) 이므로 최솟값이다. MSE 로 학습한 신경망은 일어날 수 있는 미래들의 평균을 낸다.
미래가 하나로 정해져 있으면 평균이 곧 답이다. 미래가 여러 갈래면 사정이 달라진다. 진자가 꼭대기에 거의 멈춰 서 있으면 왼쪽으로도 오른쪽으로도 넘어질 수 있고, 정답이 반반의 확률로 두 그림이면 MSE 의 답은 두 그림의 평균, 곧 막대가 두 개 겹친 흐린 그림이다. 실제로는 일어나지 않는 미래다. 1차원에서 정답이 \(\pm 1\) 반반이면 MSE 예측은 0 이고, 0 은 한 번도 나오지 않는 값이다. World Model 이 상상 속에서 이런 평균 미래를 만들면 그 위에서 배운 행동도 엉뚱해지므로, 하나의 값이 아니라 분포를 예측해야 한다.
장난감 문제
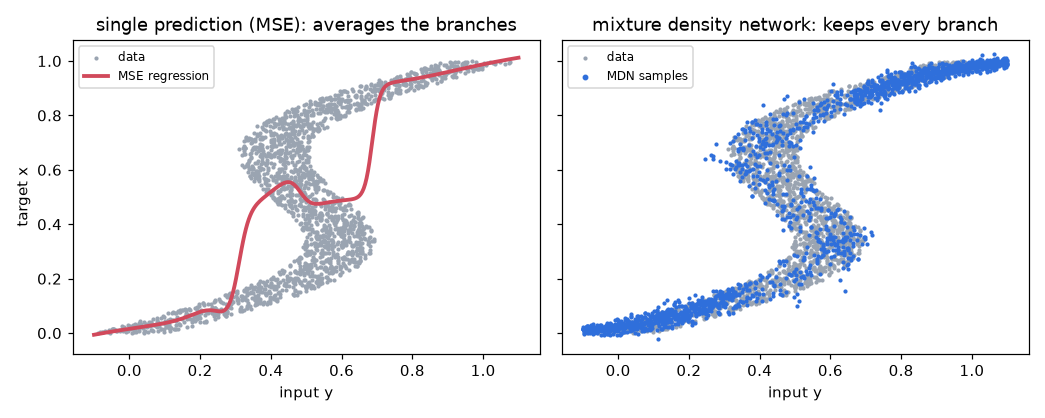
Bishop(1994)의 고전적인 예를 쓴다. \(x\) 를 0 ~ 1 에서 뽑아 \(y = x + 0.3\sin(2\pi x) + \text{잡음}\) 을 만든 뒤(코드에서는 표본 2000개, 잡음은 ±0.1 균등 분포) 거꾸로 \(y\) 를 보고 \(x\) 를 맞히게 한다. \(y\) 가 0.4 ~ 0.6 근처이면 그런 \(y\) 를 만드는 \(x\) 가 세 개씩 있다.
- MSE 로 학습한 신경망은 갈래들의 평균, 곧 데이터가 거의 없는 곳을 지난다. 혼합 밀도 네트워크에서 뽑은 표본은 세 갈래를 모두 따라간다.
- 실행 결과는
[장난감] MSE 회귀 손실 0.0380 | MDN 음의 로그 가능도 -1.142다. MSE 손실 0.038 은 평균 오차가 \(\sqrt{0.038} \approx 0.19\) 라는 뜻으로, 데이터가 퍼진 폭에 비해 큰 오차다. - MDN 의 음의 로그 가능도가 음수인 것은 이상하지 않다. 연속 분포의 밀도는 1 보다 클 수 있으므로(폭이 좁은 가우시안의 꼭대기) 로그 밀도가 양수가 되고 NLL 이 음수가 된다.
- 그림: MSE 회귀선과 MDN 표본 비교(그림 9-3)
혼합 밀도 네트워크 MDN
가우시안의 혼합
혼합 밀도 네트워크(mixture density network, MDN)(Bishop, 1994)는 출력을 숫자 하나가 아니라 가우시안 \(K\) 개의 혼합으로 낸다(Mixture Density Network, Gaussian mixture model).
\(p(y \mid x) = \sum_{k=1}^{K} \pi_k(x)\;\mathcal{N}\big(y;\ \mu_k(x),\ \sigma_k^2(x)\big),\qquad \pi_k \ge 0,\ \ \sum_{k=1}^K \pi_k = 1\)
종 모양 곡선 \(K\) 개를 가중치 \(\pi_k\) 로 더한 것이라 봉우리를 여러 개 가질 수 있다. 신경망은 입력 \(x\) 마다 성분별로 세 가지 숫자를 낸다.
| 매개변수 | 신경망 출력 | 변환 |
| 혼합 가중치 \(\pi_k\) | 로짓 \(\ell_k\) | 소프트맥스 \(\pi_k = \frac{e^{\ell_k}}{\sum_j e^{\ell_j}}\). 늘 양수이고 합이 정확히 1 이다. |
| 평균 \(\mu_k\) | \(\mu_k\) | 그대로 쓴다. |
| 표준편차 \(\sigma_k\) | 로그 표준편차 \(\log\sigma_k\) | \(\sigma_k = e^{\log\sigma_k}\). 늘 양수가 된다. |
여기서 \(\pi_k\) 는 원주율도 정책도 아닌 \(k\) 번째 성분의 가중치다. 아래 식의 \(\log 2\pi\) 속 \(\pi\) 만 원주율이다.
\(y\) 가 \(D\) 차원일 때 Ha & Schmidhuber 는 차원마다 따로 \(K\) 개 성분의 혼합을 둔다.
\(p(y) = \prod_{d=1}^{D}\sum_k \pi_{d,k}\,\mathcal{N}(y_d;\mu_{d,k},\sigma_{d,k}^2)\)
그래서 출력 수는 \(3 \times K \times D\) 다. \(z\) 가 32차원이고 \(K = 5\) 이면 \(3 \times 5 \times 32 = 480\) 개다.
혼합의 로그 가능도
학습은 최대우도, 곧 음의 로그 가능도(NLL) 최소화다. 합의 로그는 로그의 합으로 나눌 수 없으므로 \(u = \exp(\log u)\) 를 써서 log-sum-exp 꼴로 바꾼다.
\(\begin{align} \log p(y \mid x) &= \log \sum_{k=1}^{K}\pi_k\,\mathcal{N}(y;\mu_k,\sigma_k^2) \\ &= \log \sum_{k=1}^{K}\exp\Big(\log\pi_k + \log\mathcal{N}(y;\mu_k,\sigma_k^2)\Big) \\ &= \operatorname{logsumexp}_{k}\big(a_k\big),\qquad a_k = \log\pi_k - \log\sigma_k - \tfrac{1}{2}\log 2\pi - \tfrac{1}{2}\Big(\frac{y - \mu_k}{\sigma_k}\Big)^2 \end{align}\)
\(\operatorname{logsumexp}(a) := \log\sum_k e^{a_k}\) 이고, \(a_k\) 의 뒤쪽 세 항은 가우시안 로그 밀도를 펼친 것이다(\(\log\frac{1}{\sigma\sqrt{2\pi}} = -\log\sigma - \tfrac{1}{2}\log 2\pi\)).
log-sum-exp 안정화
\(a_k\) 를 그대로 \(e^{a_k}\) 로 바꾸면 위험하다. 예측이 정답에서 조금만 멀어도 \(a_k\) 는 -1000 같은 값이 되고, float32 로 \(e^{-1000}\) 은 정확히 0 이다. 모든 성분이 0 이면 \(\log 0 = -\infty\) 가 되어 학습이 무너진다. 반대로 \(a_k\) 가 크면 \(e^{a_k}\) 가 무한대로 넘친다. 가장 큰 값 \(m = \max_k a_k\) 를 미리 빼서 계산한다.
\(\sum_{k} e^{a_k} = e^{m}\sum_k e^{a_k - m} \quad\Rightarrow\quad \log\sum_k e^{a_k} = m + \log\sum_k e^{a_k - m}\)
\(a_k - m \le 0\) 이라 \(e^{a_k - m} \le 1\) 이므로 넘치지 않고, 가장 큰 항이 \(e^0 = 1\) 이라 합이 최소 1 이므로 \(\log 0\) 도 생기지 않는다.
- 숫자 예: \(a = (-1000,\ -1001)\) 을 그대로 계산하면 \(\log(0 + 0) = -\infty\) 다. 안정화하면 \(m = -1000\) 이고 \(-1000 + \log(e^0 + e^{-1}) = -1000 + \log(1.368) \approx -999.687\) 이다.
- PyTorch 의
torch.logsumexp와F.log_softmax가 이 방법을 쓴다. 로그 소프트맥스 \(\log\pi_k = \ell_k - \operatorname{logsumexp}(\ell)\) 도 같은 기법이다.
y.unsqueeze(-1) 로 정답에 성분 축을 만들어 \(K\) 개 성분과 한꺼번에 비교하고(브로드캐스팅), 마지막 축(성분)에 대해 logsumexp 를 한다.
def mdn_log_prob(y, log_pi, mu, log_sigma):
    """혼합 가우시안의 로그 가능도 log p(y) 를 log-sum-exp 로 안정하게 계산한다.

    y         : (..., D)      정답
    log_pi    : (..., D, K)   혼합 가중치의 로그 (log_softmax 결과)
    mu        : (..., D, K)   성분별 평균
    log_sigma : (..., D, K)   성분별 로그 표준편차
    반환       : (..., D)      차원마다의 log p(y_d)
    """
    y = y.unsqueeze(-1)  # (..., D, 1) → K 개 성분과 나란히 비교
    # 성분 k 의 로그 정규 밀도: -log σ - ½ log 2π - ½ ((y-μ)/σ)²
    log_normal = -log_sigma - 0.5 * LOG_2PI - 0.5 * ((y - mu) / log_sigma.exp()) ** 2
    # log Σ_k π_k N_k = logsumexp_k (log π_k + log N_k)
    return torch.logsumexp(log_pi + log_normal, dim=-1)
장난감 문제의 MDN 은 출력 층이 성분마다 (로짓, 평균, 로그 표준편차) 세 숫자를 낸다.
class ToyMDN(nn.Module):
    """입력 x (1차원) → 출력 y 의 혼합 가우시안 (K 개 성분)."""

    def __init__(self, n_mix: int = 5, hidden: int = 64):
        super().__init__()
        self.body = nn.Sequential(nn.Linear(1, hidden), nn.Tanh(), nn.Linear(hidden, hidden), nn.Tanh())
        self.head = nn.Linear(hidden, 3 * n_mix)  # 성분마다 (가중치 로짓, 평균, 로그 표준편차)

    def forward(self, x):
        logit_pi, mu, log_sigma = self.head(self.body(x)).chunk(3, dim=-1)  # 각각 (B, K)
        log_pi = F.log_softmax(logit_pi, dim=-1)  # 합이 1 이 되도록
        return log_pi.unsqueeze(1), mu.unsqueeze(1), log_sigma.clamp(-7, 3).unsqueeze(1)  # (B, 1, K)
온도로 표본 뽑기
혼합 분포에서 표본을 뽑는 방법은 두 단계다.
- 성분 고르기: 확률 \(\pi_1, \dots, \pi_K\) 로 성분 \(k\) 를 고른다.
- 그 성분에서 뽑기: \(y = \mu_k + \sigma_k\,\epsilon\), \(\epsilon \sim \mathcal{N}(0, 1)\).
이렇게 뽑은 \(y\) 의 분포는 \(\sum_k P(k)\,p(y \mid k) = \sum_k\pi_k\mathcal{N}(y;\mu_k,\sigma_k^2)\), 곧 혼합 분포 그 자체다(주변화). Ha & Schmidhuber 는 여기에 온도(temperature) \(\tau\) 를 넣어 꿈의 무작위한 정도를 조절한다.
\(\pi_k^{(\tau)} = \frac{\exp(\log\pi_k/\tau)}{\sum_j\exp(\log\pi_j/\tau)} = \frac{\pi_k^{1/\tau}}{\sum_j \pi_j^{1/\tau}},\qquad y = \mu_k + \sigma_k\sqrt{\tau}\,\epsilon\)
| 온도 | 효과 |
| \(\tau = 1\) | 모델이 배운 분포 그대로다. |
| \(\tau \lt 1\) | 큰 성분이 더 커지고(뾰족) 잡음도 줄어든다. \(\tau \to 0\) 이면 가장 큰 성분의 평균만 내는 잡음 없는 꿈이 된다. |
| \(\tau \gt 1\) | 성분들이 고르게 뽑히고 잡음도 커진다. 더 불확실하고 거친 꿈이다. |
숫자 예로 \(\pi = (0.7,\ 0.3)\) 을 보면, \(\tau = 0.5\) 일 때 \(1/\tau = 2\) 제곱인 \((0.49,\ 0.09)\) 를 합 0.58 로 나눠 \((0.845,\ 0.155)\) 가 된다. \(\tau = 2\) 일 때는 제곱근 \((0.837,\ 0.548)\) 을 합 1.384 로 나눠 \((0.604,\ 0.396)\) 이 된다. 온도가 높을수록 두 성분이 비슷해진다. 이 \(\tau\) 는 10장에서 중요한 역할을 한다.
def mdn_sample(log_pi, mu, log_sigma, tau: float = 1.0):
    """온도 τ 로 혼합 가우시안에서 표본을 뽑는다 (Ha & Schmidhuber 의 방식).

    1) 성분 고르기: 확률 ∝ exp(log π_k / τ)   (τ 가 크면 고르게, 작으면 가장 큰 성분만)
    2) 그 성분에서 뽑기: μ_k + σ_k · √τ · ε
    τ = 0 이면 가장 큰 성분의 평균을 그대로 돌려준다 (잡음 없는 꿈).
    """
    if tau <= 1e-6:
        k = log_pi.argmax(dim=-1, keepdim=True)
        return mu.gather(-1, k).squeeze(-1)
    k = torch.distributions.Categorical(logits=log_pi / tau).sample().unsqueeze(-1)  # (..., D, 1)
    mu_k = mu.gather(-1, k).squeeze(-1)
    sigma_k = log_sigma.gather(-1, k).squeeze(-1).exp()
    return mu_k + sigma_k * math.sqrt(tau) * torch.randn_like(mu_k)
MDN-RNN: World Models 의 M
구조
LSTM 이 매 스텝 \([z_t; a_t]\) 를 읽어 기억을 갱신하고, 그 출력에서 MDN 머리가 다음 잠재 벡터 \(z_{t+1}\) 의 혼합 분포를, 보상 머리가 보상 \(r_t\) 를 낸다(Recurrent World Models Facilitate Policy Evolution).
\(\begin{align} (h_{t+1}, c_{t+1}) &= \text{LSTM}\big([z_t; a_t],\ (h_t, c_t)\big) \\ p_\theta(z_{t+1} \mid z_{\le t}, a_{\le t}) &= \prod_{d=1}^{32}\sum_{k=1}^{5}\pi_{d,k}\,\mathcal{N}\big(z_{t+1,d};\ \mu_{d,k},\ \sigma_{d,k}^2\big),\quad (\pi, \mu, \sigma) = \text{MDN}(h_{t+1}) \\ \hat{r}_t &= w_r^\top h_{t+1} + b_r \end{align}\)
첨자 약속이 앞 절과 다르다. RNN·LSTM 절에서는 입력 \(x_t\) 를 읽은 뒤의 기억을 \(h_t\) 라고 썼지만, 여기서부터는 원 논문을 따라 \(z_t, a_t\) 를 읽은 뒤의 기억을 \(h_{t+1}\) 로 쓴다. 그래서 \(h_t\) 는 \(z_t\) 를 보기 전까지의 기억이고, 10장의 컨트롤러가 \([z_t; h_t]\) 를 함께 받는 것도 이 약속에 따른다.
| 부품 | 크기 | 매개변수 수 |
| 입력 \(z_t\) (32) + \(a_t\) (1) | 33 | - |
| LSTM | 은닉 256 | 297,984 |
| MDN 머리 (\(\pi, \mu, \sigma\)) | 256 → 480 = 3 × 5 × 32 | 123,360 |
| 보상 머리 (\(\hat{r}_t\)) | 256 → 1 | 257 |
| 합계 | 421,601 |
전체 매개변수는 8장 VAE(약 435만 개)의 10분의 1 이다. 기억 \((h, c)\) 가 속도 같은 숨은 정보를 들고 다음 스텝으로 넘어간다.
class MDNRNN(nn.Module):
    """M 모델: LSTM 이 (z_t, a_t) 를 읽고 z_{t+1} 의 혼합 가우시안과 보상 r_t 를 내놓는다.

    z 의 각 차원 d 마다 따로 K 개 성분의 혼합을 쓴다 (Ha & Schmidhuber 와 같다).
    """

    def __init__(self, z_dim: int = 32, act_dim: int = 1, hidden: int = 256, n_mix: int = 5):
        super().__init__()
        self.z_dim, self.act_dim, self.hidden, self.n_mix = z_dim, act_dim, hidden, n_mix
        self.lstm = nn.LSTM(z_dim + act_dim, hidden, batch_first=True)
        self.mdn_head = nn.Linear(hidden, 3 * z_dim * n_mix)  # 차원 · 성분마다 (로짓, μ, log σ)
        self.reward_head = nn.Linear(hidden, 1)

    def heads(self, out):
        """LSTM 출력 (B, T, H) → 혼합 매개변수 각각 (B, T, D, K), 보상 (B, T)."""
        B, T, _ = out.shape
        params = self.mdn_head(out).view(B, T, 3, self.z_dim, self.n_mix)
        logit_pi, mu, log_sigma = params.unbind(dim=2)
        log_pi = F.log_softmax(logit_pi, dim=-1)  # 성분 K 개에 대해 합 1
        log_sigma = log_sigma.clamp(-7.0, 2.0)  # 너무 작거나 큰 σ 막기 (수치 안정)
        reward = self.reward_head(out).squeeze(-1)
        return log_pi, mu, log_sigma, reward

    def forward(self, z, a, state=None):
        """z: (B, T, D), a: (B, T, A) → 혼합 매개변수, 보상, 새 LSTM 상태 (h, c)."""
        out, state = self.lstm(torch.cat([z, a], dim=-1), state)  # out: (B, T, H)
        return (*self.heads(out), state)

    def initial_state(self, batch: int, device):
        zeros = torch.zeros(1, batch, self.hidden, device=device)
        return (zeros, zeros.clone())
-
batch_first=True는 텐서 모양을 (배치, 시간, 특징)으로 쓴다는 뜻이다. -
view(B, T, 3, D, K)로 (로짓, μ, log σ) × 32차원 × 5성분으로 나눈 뒤unbind(dim=2)로 세 텐서를 꺼낸다. -
clamp(-7, 2)는 \(\sigma\) 를 \(e^{-7} \approx 0.0009\) ~ \(e^{2} \approx 7.4\) 사이로 묶어, 한 성분이 바늘처럼 좁아져 NLL 이 폭주하는 것을 막는다. -
initial_state는 에피소드 시작의 \((h_0, c_0) = (0, 0)\) 이다. 모양 (층 수 1, 배치, 은닉)은 PyTorch LSTM 의 약속이다.
학습: 교사 강요와 손실
8장의 VAE 로 200 에피소드의 모든 그림을 \(\mu, \log\sigma^2\) 으로 바꿔 두고(encode_frames) 그 시퀀스로 MDN-RNN 을 학습한다. z 시퀀스의 모양은 (200, 201, 32), 곧 (에피소드, 시간, 차원)이다.
\(\mathcal{L}(\theta) = \frac{1}{BL}\sum_{b=1}^{B}\sum_{t=1}^{L}\Big[-\sum_{d=1}^{32}\log p_\theta\big(z^{(b)}_{t+1,d}\big) + \lambda_r\big(\hat{r}^{(b)}_t - r^{(b)}_t\big)^2\Big]\)
앞 항은 다음 잠재 벡터의 NLL(차원은 합, 시간과 배치는 평균), 뒤 항은 보상의 MSE 이고 \(\lambda_r = 1\) 이다.
- 교사 강요(teacher forcing)
- 학습 때 LSTM 의 입력은 늘 진짜 \(z_t\) 다. 모델이 앞에서 틀리게 예측했더라도 다음 스텝에는 정답을 넣는다. 모든 시각을 한 번에(병렬로) 계산할 수 있고 학습이 안정된다. 대신 꿈을 꿀 때는 자기 예측을 입력으로 받으므로 학습 때 본 적 없는 조금 틀린 입력을 만난다. 이 차이를 노출 편향(exposure bias)이라 하며, 꿈이 길어질수록 어긋나는 이유 가운데 하나다(6장의 오차 누적과 같은 현상).
- 매번 새로 뽑은 z
- 그림을 평균 \(\mu\) 하나로 고정하지 않고 배치마다 \(z = \mu + \sigma\odot\epsilon\) 를 새로 뽑는다(Ha & Schmidhuber 와 같은 방식). VAE 가 구름으로 인코딩했으니 그 구름 전체에 대해 예측을 배우게 하는 데이터 증강이다.
- 잘린 BPTT(truncated BPTT)
- 배치마다 에피소드
ep와 시작 시각t0를 무작위로 골라 길이 65(= \(L + 1\))짜리 창을 자른다. 입력은z[:, :-1](0 ~ 63번째), 정답은z[:, 1:](1 ~ 64번째)로 한 칸 어긋나게 짝지어 "다음"을 맞히게 한다. 에피소드 전체(200 스텝)가 아니라 64 스텝짜리 창만 쓰므로 기울기는 최대 64 스텝까지만 거슬러 흐른다. 창이 에피소드 중간에서 시작해도 기억을 \((h, c) = (0, 0)\) 으로 두고 출발하므로 창의 처음 몇 스텝은 속도를 모르는 채 예측한다.
하이퍼파라미터는 은닉 256, 혼합 성분 5, 6000 스텝, 창 길이 64, 배치 64, Adam 학습률 1e-3, 보상 가중치 1.0, 기울기 자르기 1.0 이고 마지막 10% 에피소드(20개)를 검증용으로 뗀다.
def train_mdnrnn(mu, logvar, actions, rewards, hidden=256, n_mix=5, steps=6000, seq_len=64, batch=64,
                 lr=1e-3, reward_weight=1.0, device="cpu", log=print):
    """mu, logvar: (N, T+1, D) VAE 인코딩, actions: (N, T, 1), rewards: (N, T)."""
    N, T1, D = mu.shape
    T = T1 - 1
    model = MDNRNN(D, actions.shape[-1], hidden, n_mix).to(device)
    opt = torch.optim.Adam(model.parameters(), lr=lr)
    mu_t = torch.as_tensor(mu, device=device)
    std_t = torch.as_tensor(np.exp(0.5 * logvar), device=device)
    act_t = torch.as_tensor(actions, device=device)
    rew_t = torch.as_tensor(rewards, device=device)
    n_train = int(N * 0.9)  # 마지막 10% 에피소드는 검증용
    history = []
    for step in range(1, steps + 1):
        ep = torch.randint(0, n_train, (batch,), device=device)
        t0 = torch.randint(0, T - seq_len + 1, (batch,), device=device)
        idx = t0[:, None] + torch.arange(seq_len + 1, device=device)  # (B, L+1)
        # 매번 q(z|o) 에서 새로 뽑는다: z = μ + σ ε  (모델이 z 의 흔들림에 강해진다)
        z = mu_t[ep[:, None], idx] + std_t[ep[:, None], idx] * torch.randn(batch, seq_len + 1, D, device=device)
        a = act_t[ep[:, None], idx[:, :-1]]  # (B, L, 1)
        r = rew_t[ep[:, None], idx[:, :-1]]  # (B, L)
        # 교사 강요: 입력은 언제나 '진짜' z_t. 출력으로 z_{t+1} 과 r_t 를 맞힌다
        log_pi, m, log_s, r_hat, _ = model(z[:, :-1], a)
        nll = -mdn_log_prob(z[:, 1:], log_pi, m, log_s).sum(-1).mean()  # 차원 합 → 시간 · 배치 평균
        r_loss = F.mse_loss(r_hat, r)
        loss = nll + reward_weight * r_loss
        opt.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)  # 기울기 폭발 막기
        opt.step()
        if step % 500 == 0 or step == 1:
            val = evaluate(model, mu_t[n_train:], act_t[n_train:], rew_t[n_train:])
            history.append((step, nll.item(), r_loss.item(), *val))
            log(f"step {step:5d} | 학습 NLL {nll.item():8.2f}  보상 MSE {r_loss.item():.3f} | "
                f"검증 NLL {val[0]:8.2f}  보상 MSE {val[1]:.3f}")
    return model, history
학습 결과
장치: cuda
[장난감] MSE 회귀 손실 0.0380 | MDN 음의 로그 가능도 -1.142
z 시퀀스: (200, 201, 32) (에피소드, 시간, 차원)
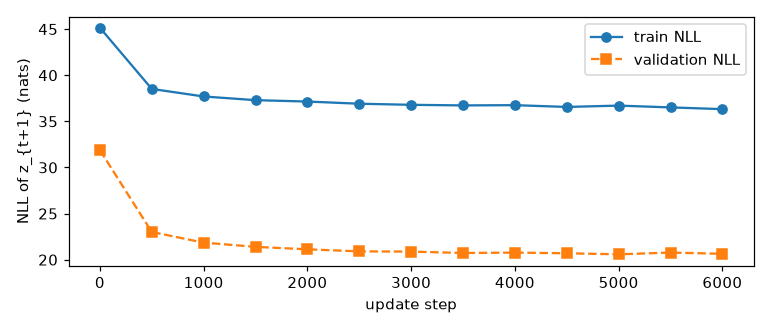
step     1 | 학습 NLL    45.14  보상 MSE 49.446 | 검증 NLL    31.86  보상 MSE 50.686
step   500 | 학습 NLL    38.52  보상 MSE 0.580 | 검증 NLL    23.01  보상 MSE 0.116
step  1000 | 학습 NLL    37.70  보상 MSE 0.397 | 검증 NLL    21.85  보상 MSE 0.058
…
step  5500 | 학습 NLL    36.51  보상 MSE 0.106 | 검증 NLL    20.77  보상 MSE 0.018
step  6000 | 학습 NLL    36.32  보상 MSE 0.083 | 검증 NLL    20.64  보상 MSE 0.018
MDN-RNN 학습 69.4초
dream tau=0: 꿈 시작 후 10 · 25 · 50 스텝의 평균 각도 오차 = 1° · 7° · 14°
dream tau=1: 꿈 시작 후 10 · 25 · 50 스텝의 평균 각도 오차 = 2° · 8° · 16°
그림 저장: figures
- 6,000 스텝 학습에 노트북 GPU 로 약 70초, 꿈 분석까지 전체 약 2분 20초가 걸린다. CPU(4스레드)로는 한 스텝에 약 0.19초라 학습에만 약 20분이 걸린다.
--steps 2000으로 줄여도 꿈은 크게 다르지 않다. - 검증 보상 MSE 는 0.018 까지 내려간다. 보상의 범위가 0 ~ -16 이므로 평균 오차 \(\sqrt{0.018} \approx 0.13\) 은 아주 작다.
- 실행 옵션으로
--n-mix 1(혼합 성분을 하나로 줄여 가우시안 하나로 만들기)과--hidden 32(기억 줄이기)를 바꿔 꿈이 어떻게 달라지는지 비교할 수 있다.
NLL 숫자 읽기: 꺼진 차원의 잡음
검증 NLL(약 21)이 학습 NLL(약 36)보다 훨씬 작다. 보통과 반대인 이유는 8장의 꺼진 차원에 있다. 8장의 VAE 는 32차원 중 7개만 썼고, 나머지 25개 차원은 모든 그림에서 \(q(z_j \mid x) \approx \mathcal{N}(0, 1)\) 이었다.
| 구분 | 입력 z | 꺼진 차원 하나의 NLL | 25개 합 |
| 학습 | 매번 \(z = \mu + \sigma\epsilon\) 을 뽑는다. 꺼진 차원의 값은 순수한 \(\mathcal{N}(0,1)\) 잡음이다. | \(\tfrac{1}{2}\log(2\pi e) \approx 1.419\) | 약 35.5 |
| 검증 | 잡음 없이 평균 \(\mu\) 를 쓴다. 꺼진 차원의 \(\mu\) 는 거의 0 으로 일정하다. | \(\tfrac{1}{2}\log 2\pi + \tfrac{1}{2}\cdot 0^2 \approx 0.919\) | 약 23.0 |
- 학습 쪽: 잡음은 어떤 모델도 맞힐 수 없고 최선은 \(\mathcal{N}(0,1)\) 을 그대로 예측하는 것이다. 그때의 NLL 은 표준 정규 분포의 엔트로피(3장) \(\mathbb{E}[-\log\mathcal{N}(z;0,1)] = \tfrac{1}{2}\log 2\pi + \tfrac{1}{2}\mathbb{E}[z^2] = \tfrac{1}{2}\log(2\pi e)\) 다. 25개 합 35.5 가 학습 NLL 36 의 거의 전부다.
- 검증 쪽: 모델은 학습 때의 잡음 때문에 \(\sigma \approx 1\) 을 예측하므로 차원당 0.919 다. 나머지 7개 살아 있는 차원은 잘 예측되어 음의 NLL 을 보태 합계가 약 21 이 된다.
"NLL 이 36 에서 더 안 내려간다"는 것은 모델의 실패가 아니라 데이터에 원래 있는 잡음 때문이다. 손실 값은 이런 식으로 바닥과 비교해 읽어야 한다.
꿈꾸기: 자기 예측을 다시 입력하기
학습이 끝난 MDN-RNN 은 진짜 환경 없이 미래를 만들어 낸다. 첫 장면의 \(z\) 와 행동을 주면 다음 \(z\) 를 뽑고, 그것을 다시 입력에 넣어 또 다음 \(z\) 를 뽑는 일을 되풀이한다. 이것을 꿈(dream) 또는 상상 롤아웃이라고 부른다. 뽑힌 \(z\) 들을 8장의 VAE 디코더로 그림으로 바꾸면 모델이 무엇을 상상하는지 볼 수 있다.
@torch.no_grad()
def dream(model, z_real, actions, warmup: int, tau: float):
    """처음 warmup 스텝은 진짜 z 를 넣어 기억(h)을 만들고, 그 뒤로는 자기 예측을 다시 넣는다.

    z_real : (1, T+1, D) 진짜 잠재 시퀀스 (처음 warmup+1 개만 쓴다)
    actions: (1, T, 1) 행동 — 꿈속에서도 진짜와 같은 행동을 넣어 비교한다
    반환    : (T+1, D) 꿈속 z 시퀀스
    """
    state = model.initial_state(1, z_real.device)
    z = z_real[:, 0:1]  # (1, 1, D)
    out = [z[0, 0]]
    for t in range(actions.shape[1]):
        log_pi, mu, log_sigma, _, state = model(z, actions[:, t : t + 1], state)
        if t + 1 <= warmup:
            z = z_real[:, t + 1 : t + 2]  # 아직은 진짜를 보여 준다
        else:
            z = mdn_sample(log_pi, mu, log_sigma, tau)  # 이제부터는 꿈: 자기가 뽑은 z 를 다시 입력
        out.append(z[0, 0])
    return torch.stack(out)
실험 설정
- 처음 10 스텝(
warmup)은 진짜 \(z\) 를 넣는다. 그림 한 장으로는 속도를 알 수 없으므로 몇 장면을 보여 줘서 LSTM 의 기억에 지금 얼마나 빨리 도는지를 담게 한다. 그 뒤로는 자기가 뽑은 \(z\) 만으로 나아간다. - 비교를 위해 행동은 진짜 에피소드와 똑같이 넣고, 학습에 쓰지 않은 검증 에피소드를 쓴다.
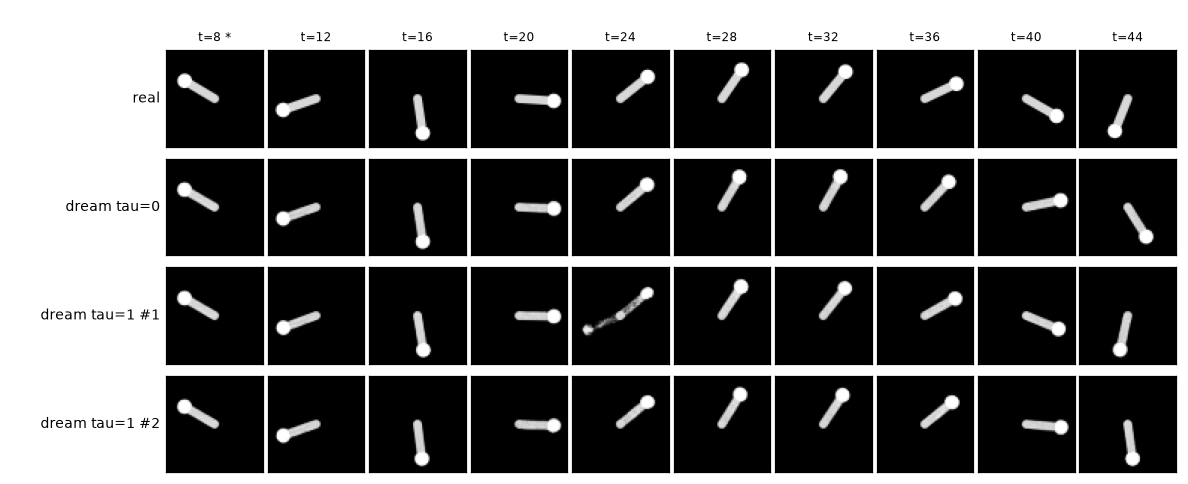
- 그림 9-6 은 진짜 에피소드, \(\tau = 0\) 의 꿈 하나, \(\tau = 1\) 의 꿈 두 개(같은 시작, 다른 난수)를 디코딩해 시간 순으로 나란히 놓은 것이다. \(t \le 10\) 까지는 진짜 장면을 보여 준 구간이다.
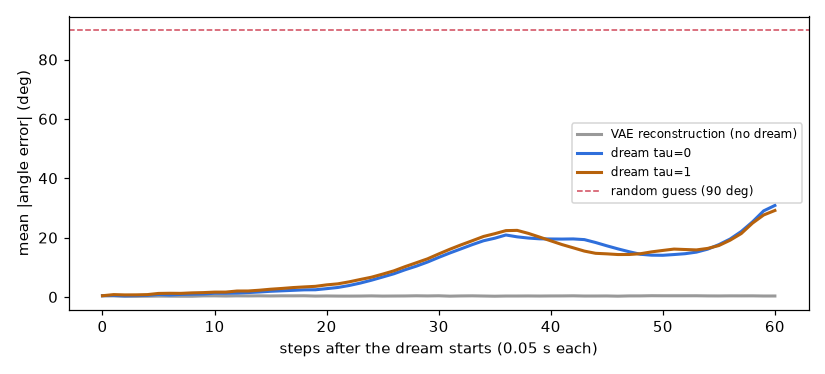
- 그림 9-7 은 검증 에피소드 20개 모두에서 꿈을 꾸게 하고(\(\tau = 1\) 은 에피소드마다 4번, 모두 80개 꿈) 디코딩한 그림에서 각도를 읽어 진짜 각도와 비교한 것이다. 꿈을 시작한 뒤 60 스텝까지 잰다.
- 각도 읽기(
image_angle): 밝기로 가중한 무게중심은 막대 위에 있으므로 중심에서 무게중심을 향한 방향이 막대의 방향이다. 꿈 없이 VAE 로 그림을 되살리기만 한 경우의 오차가 0.5° 안팎이므로 이 읽기 방법의 오차는 무시할 만하다. - 아무렇게나 찍었을 때의 평균 오차는 90° 다.
- 그림: 진짜 에피소드와 꿈의 장면 비교(그림 9-6), 꿈 시작 뒤 스텝별 평균 각도 오차(그림 9-7)
결과
| 꿈 시작 뒤 스텝 (시간) | 평균 각도 오차 |
| 10 (0.5초) | 1 ~ 2° (\(\tau = 0\) 은 1°, \(\tau = 1\) 은 2°) |
| 25 (1.25초) | 7 ~ 8° (\(\tau = 0\) 은 7°, \(\tau = 1\) 은 8°) |
| 35 무렵 | 약 20° |
| 50 | 14 ~ 16° (\(\tau = 0\) 은 14°, \(\tau = 1\) 은 16°) |
| 60 | 약 30° |
- 물리를 배웠다. 진짜 장면을 하나도 보지 않고도 10 스텝 뒤 오차가 1 ~ 2°, 25 스텝 뒤에도 7 ~ 8° 다. 그림 9-6 에서 t = 12 ~ 32 동안 꿈속 진자가 진짜와 거의 같은 각도로 흔들린다. 중력, 토크에 따른 회전, 속도의 기억이 모두 LSTM 안에 들어 있다.
- 시간이 갈수록 어긋난다. 매 스텝의 작은 예측 오차가 다음 입력으로 들어가 쌓인다(6장의 오차 누적, 노출 편향). 각도 오차는 진자가 흔들리는 박자에 따라 오르내려 단조롭게 커지지는 않는다. 진자처럼 작은 차이가 크게 벌어지는 계에서는 피할 수 없지만, 아무렇게나 찍는 것(90°)보다는 훨씬 낫다.
- \(\tau = 1\) 의 꿈은 여러 미래 중 하나다. 평균 오차는 \(\tau = 0\) 과 거의 같지만 그림 9-6 의 두 \(\tau = 1\) 꿈은 t = 36 ~ 40 무렵부터 서로 다른 길로 간다. t = 24 에서처럼 막대가 흐리게 번진 장면도 가끔 나오는데, 혼합에서 성분이 갈아타는 순간이다. \(\tau = 1\) 의 꿈은 하나의 정답을 맞히려는 것이 아니라 일어날 수 있는 미래 가운데 하나를 보여 주며, 10장에서는 이 불확실성이 쓸모가 있다.
V(VAE)와 M(MDN-RNN)을 합치면 그림의 세상이 32차원 잠재 공간의 작은 시뮬레이터로 바뀐다. 이 시뮬레이터는 그림을 그리지 않으므로 진짜 환경보다 훨씬 빠르고, 한꺼번에 수천 개를 돌릴 수 있으며, 미분도 된다. 10장에서는 이 꿈속에서 행동을 배운다.
10장을 위한 준비물
| 파일 | 내용 |
| | 학습한 MDN-RNN 이다. |
| | 모든 에피소드의 \(\mu, \log\sigma^2\), 행동, 보상이다. 10장에서 꿈의 시작 장면으로 쓴다. |
정리
- 그림 한 장은 속도를 담지 못한다(부분 관측). 지난 장면의 요약인 은닉 상태 \(h_t\) 가 필요하다.
- RNN 은 \(h_t = \tanh(W_h h_{t-1} + W_x x_t + b)\) 다. 먼 과거로의 기울기는 \(\prod\operatorname{diag}(1-h_t^2)W_h\) 라서 소실·폭발하기 쉽다.
- LSTM 은 셀 상태의 덧셈 경로 덕분에 \(\partial c_T/\partial c_k \approx \prod\operatorname{diag}(f_t)\) 로 기울기를 지킨다. GRU 는 게이트를 둘로 줄인 변형이다. 폭발은 기울기 자르기로 막는다.
- MSE 회귀는 조건부 평균을 낸다. 미래가 여러 갈래면 평균은 일어나지 않는 미래다. 혼합 밀도 네트워크는 \(\sum_k\pi_k\mathcal{N}(\mu_k,\sigma_k^2)\) 로 모든 갈래를 지킨다.
- 혼합 로그 가능도는 log-sum-exp \(m + \log\sum e^{a_k - m}\) 로 안전하게 계산한다. 온도 \(\tau\) 는 꿈의 무작위성을 조절한다.
- MDN-RNN 은 \((z_t, a_t)\) 로 \(z_{t+1}\) 의 혼합과 \(r_t\) 를 예측한다. 교사 강요로 학습하고, 꿈에서는 자기 예측을 다시 입력한다.
- 진자 꿈은 25 스텝(1.25초) 뒤에도 평균 각도 오차가 8° 안쪽이고, 그 뒤로는 오차가 쌓여 35 ~ 50 스텝 뒤 15 ~ 20°, 60 스텝 뒤 약 30° 로 커진다.
확인 문제
- 1. RNN 계산
- 1차원 RNN 에서 \(W_h = 1\), \(W_x = 1\), \(b = 0\), 입력 \(x = (1, 0, 0)\) 일 때 \(h_1, h_2, h_3\) 과 본문 예(\(W_h = 0.5\))와의 차이를 구한다.
- 답: \(h_1 = \tanh 1 \approx 0.762\), \(h_2 = \tanh(0.762) \approx 0.642\), \(h_3 = \tanh(0.642) \approx 0.566\). 기억이 훨씬 천천히 줄어든다. 대신 \(W_h\) 가 더 커지면(예: 3) 입력 없이도 \(h\) 가 1 근처에 붙어 tanh 가 포화되고 \(1 - h^2 \approx 0\) 이 되어 기울기가 사라진다.
- 2. 기울기 소실
- 매 스텝 곱해지는 값이 0.9 일 때 50 스텝 전으로 가는 기울기의 배율과, LSTM 의 망각 게이트가 0.99 일 때의 배율을 구한다.
- 답: \(0.9^{50} \approx 0.0052\), \(0.99^{50} \approx 0.605\). 망각 게이트가 1 에 가까우면 50 스텝 전까지도 기울기의 60% 가 살아 있다.
- 3. log-sum-exp
- \(a = (2,\ 0,\ -1)\) 일 때 \(\log\sum e^{a_k}\) 를 안정화 공식으로 계산한다(\(e^{-2} \approx 0.135\), \(e^{-3} \approx 0.050\)).
- 답: \(m = 2\) 이고 \(2 + \log(e^0 + e^{-2} + e^{-3}) = 2 + \log(1.185) \approx 2 + 0.170 = 2.170\).
- 4. 온도
- \(\pi = (0.5,\ 0.3,\ 0.2)\) 에서 \(\tau \to 0\) 과 \(\tau \to \infty\) 일 때 성분을 고르는 확률을 구한다.
- 답: \(\tau \to 0\) 이면 \(\pi_k^{1/\tau}\) 에서 가장 큰 0.5 만 살아남아 \((1, 0, 0)\) 이다. \(\tau \to \infty\) 이면 \(\pi_k^{1/\tau} \to \pi_k^0 = 1\) 이라 \((1/3, 1/3, 1/3)\) 로 고르게 된다.
- 5. NLL 의 바닥
- 8장의 VAE 가 살아 있는 차원을 7개가 아니라 3개만 썼다면 학습 NLL 이 내려갈 수 있는 한계를 구한다(살아 있는 차원의 기여는 0 이라고 가정).
- 답: 꺼진 차원 29개 × 1.419 ≈ 41.1. 학습 NLL 은 약 41 아래로 내려갈 수 없다.
See also
- World Models:Tutorial
- World Models
- Recurrent World Models Facilitate Policy Evolution
- Recurrent neural network
- LSTM
- GRU
- Backpropagation through time
- Gradient Vanishing
- Gradient Exploding
- Mixture Density Network
- Gaussian mixture model
- Maximum likelihood estimation
- VAE