WorldModels:Tutorial:11-RSSM-PlaNet
lastmod 2026-11-18created 2026-11-172 edits
RSSM 과 PlaNet은 World Model 튜토리얼의 11장이다. 10장에서 따로 학습하던 눈(VAE)과 기억(MDN-RNN)을 하나의 모델로 합쳐 처음부터 끝까지 함께 학습하는 RSSM(Recurrent State-Space Model, 순환 상태 공간 모델)을 만들고, 그 모델의 상상 속에서 행동을 계획하는 PlaNet 으로 64×64 그림만 보고 진자를 세운다. 중심 내용은 RSSM 의 학습 목표인 순차 ELBO 의 유도이며, 여기서 만든 RSSM 은 12장 Dreamer 계열의 뼈대로 그대로 쓰인다.
- 원문: 11. RSSM 과 PlaNet
- 실습 코드:
code/ch11_rssm_planet.py,code/wm_envs.py(본문 설정은 노트북 GPU 로 약 76분,--quick은 CPU 약 1분) - 이전: 10. Ha 와 Schmidhuber 의 World Models / 다음: 12. Dreamer
배경: World Models 의 한계와 부분 관측
6·7장은 진자의 상태를 숫자 3개 \([\cos\theta, \sin\theta, \dot\theta]\) 로 정확히 받았다. 8장부터는 64×64 그림만 본다. 10장의 World Models 는 이를 V(VAE, 그림마다 따로 학습), M(MDN-RNN, V 를 다 학습한 뒤에 따로 학습), C(컨트롤러, CMA-ES 로 학습)로 풀었는데 세 가지가 아쉽다.
- V 는 무엇이 중요한지 모른다. "그림을 잘 복원하라" 는 목표만 받으므로 미래 예측이나 보상 판단에 필요한 정보를 골라 담는다는 보장이 없다.
- 학습이 두 단계로 나뉜다. M 은 V 가 이미 정해 둔 \(z\) 를 바꿀 수 없어서, 예측하기 좋은 표현을 둘이 함께 찾을 길이 막혀 있다.
- 계획이 없다. C 는 매 순간 반사적으로 행동을 고른다.
Hafner 외의 Learning Latent Dynamics for Planning from Pixels(ICML 2019)는 이 문제들을 한꺼번에 푸는 PlaNet(Deep Planning Network)을 발표했다. 핵심 부품이 RSSM 이다.
그림 한 장으로는 속도를 알 수 없다
그림 한 장 \(o_t\) 는 각도 \(\theta\) 만 알려 준다. 같은 그림이라도 \(\dot\theta = +3\) rad/s(시계 방향)이면 다음 순간 막대가 오른쪽 아래로, \(\dot\theta = -3\) rad/s(반시계 방향)이면 위로 간다. 그림을 보는 진자는 부분 관측 마르코프 결정 과정(POMDP)이고, 관측 \(o_t\) 만으로는 마르코프 성질이 성립하지 않는다(Markov decision process). 해결책은 지금까지 본 것을 모두 요약한 믿음 상태(belief state)를 들고 다니는 것이다. 진자는 최근 두세 장면의 각도 변화만 기억해도 속도를 추정할 수 있다. RSSM 은 이 믿음 상태를 신경망으로 학습한다.
잠재 상태 공간 모델
상태 공간 모델(state-space model, SSM)은 직접 볼 수 없는 숨은 상태 \(s_t\) 가 시간에 따라 바뀌고, 그 상태가 만들어 낸 관측 \(o_t\) 만 본다고 가정한다. 칼만 필터가 대표적인 예다.
\(\begin{align} \text{전이(transition)} &: \quad s_t \sim p(s_t \mid s_{t-1}, a_{t-1}) \\ \text{관측(observation)} &: \quad o_t \sim p(o_t \mid s_t) \\ \text{보상(reward)} &: \quad r_t \sim p(r_t \mid s_t) \end{align}\)
칼만 필터에서는 이 분포들이 사람이 적어 준 선형 식이지만, 잠재 상태 공간 모델에서는 상태 \(s_t\) 의 뜻조차 정하지 않고 신경망이 스스로 만들게 한다.
보상·행동 첨자 규칙
5장은 상태 \(s_t\) 에서 행동 \(a_t\) 를 했을 때 받는 보상을 \(r_t\) 로 적었다. 이 장은 PlaNet·Dreamer 논문을 따라 상태 \(s_t\) 에 도착하며 받은 보상(직전 행동 \(a_{t-1}\) 의 결과)을 \(r_t\) 로 적고 \(s_t\) 에서 예측한다. 5장 표기로는 \(r_{t-1}\) 이다. \(a_{t-1}\) 은 \(s_{t-1}\) 에서 \(s_t\) 로 가는 행동이다.
| 시각 | 그림 | 그 그림에 오기 직전 행동 | 그 그림에 도착하며 받은 보상 |
| \(t = 0\) | \(o_0\) (첫 그림) | 없음 (0 으로 채움) | 없음 (학습에서 뺌) |
| \(t = 1\) | \(o_1\) | \(a_0\) | \(r_1\) |
| \(t = 2\) | \(o_2\) | \(a_1\) | \(r_2\) |
리플레이 버퍼도 이 표대로 obs[t], prev_action[t], reward[t], first[t] 를 저장한다. 시각 \(t\) 의 칸 하나에 그 시각에 필요한 것이 모두 들어 있어 코드가 단순해진다.
필터링
지금까지 본 그림 \(o_{1:t}\) 와 한 행동 \(a_{0:t-1}\) 로 지금 상태를 추측하는 일, 곧 \(p(s_t \mid o_{1:t}, a_{0:t-1})\) 를 구하는 일을 필터링(filtering)이라고 한다. 진짜 분포는 베이즈 정리로 정의되지만 신경망 모델에서는 적분이 불가능하다. 그래서 VAE 처럼 추론 신경망 \(q\) 로 근사하며, 이것이 뒤의 사후 모델이다.
세 가지 설계: 결정적 RNN, 확률적 SSM, RSSM
- 시도 1 (결정적 RNN 만 쓰기)
- 은닉 상태를 \(h_t = f(h_{t-1}, a_{t-1}, o_{t-1})\) 로 계산하고 \(h_t\) 에서 다음 그림을 예측한다. 학습할 때는 진짜 그림이 계속 들어와 잘 동작하지만 계획할 때 문제가 생긴다. 결정적 모델은 같은 입력에 미래를 하나만 내놓으므로, 미래가 여러 갈래일 때(막대가 꼭대기에서 왼쪽으로 넘어갈지 오른쪽으로 넘어갈지) 제곱 오차를 줄이려고 갈래들의 평균, 곧 실제로는 일어나지 않는 흐릿한 미래를 예측한다. 또 학습 때는 늘 그림이 들어오다가 계획 때만 그림 없이 굴리므로 학습과 사용 상황이 어긋난다.
- 시도 2 (확률적 상태만 쓰기)
- \(s_t \sim p(s_t \mid s_{t-1}, a_{t-1})\) 처럼 매 스텝 분포에서 뽑는다. 여러 갈래의 미래를 표현할 수 있고 ELBO 로 학습할 수 있다. 그러나 모든 정보가 매 스텝 뽑기를 거쳐야 다음 스텝으로 넘어가므로 여러 스텝 전의 정보를 정확히 전달하기 어렵다(귓속말 전달처럼 매번 잡음이 섞인다).
- 해결 (RSSM)
- 상태를 두 부분으로 나눈다. 결정 상태 \(h_t\)는 GRU 로 계산하는 결정적 벡터로, 잡음 없이 정보를 오래 전달하는 기억을 맡는다. 확률 상태 \(z_t\)는 매 스텝 가우시안에서 뽑는 벡터로, 아직 모르는 것과 여러 갈래의 미래를 표현하는 불확실성을 맡는다. 모델 상태는 \(s_t = (h_t, z_t)\) 이다.
| 방식 | 오래 기억하기 | 여러 갈래 미래 | ELBO 로 학습 |
| (가) 결정적 RNN | 잘함 | 못함 (평균을 예측) | 불가 (잠재 변수가 없음) |
| (나) 확률적 SSM | 약함 (매 스텝 잡음) | 잘함 | 가능 |
| (다) RSSM | 잘함 (\(h\)) | 잘함 (\(z\)) | 가능 |
원문의 비유로는 터널을 지나는 운전자가 들어가기 전의 속도와 방향을 기억(\(h\))해 위치를 상상하되 정확한 위치는 불확실(\(z\))하고, 터널을 빠져나와 풍경(\(o_t\))을 보면 위치를 고쳐 잡는다. 터널 안의 상상이 사전(prior), 풍경을 보고 고쳐 잡은 위치가 사후(posterior)다.
RSSM 의 다섯 부품
| 부품 | 식 | 하는 일 | 코드 |
| ① 결정 상태 모델 | \(h_t = f_\theta(h_{t-1}, z_{t-1}, a_{t-1})\) | 기억을 한 스텝 앞으로 (GRU) | |
| ② 사전(전이) 모델 | \(p_\theta(z_t \mid h_t)\) | 그림을 보기 전에 \(z_t\) 를 예측 | |
| ③ 사후(표현) 모델 | \(q_\phi(z_t \mid h_t, o_t)\) | 그림을 본 뒤 \(z_t\) 를 고쳐 잡음 | |
| ④ 관측 모델(디코더) | \(p_\theta(o_t \mid h_t, z_t)\) | 상태에서 그림을 다시 그림 | |
| ⑤ 보상 모델 | \(p_\theta(r_t \mid h_t, z_t)\) | 상태에서 보상을 예측 | |
시간축으로 펼친 구조는 다음과 같다.
- \(h_{t-1}\), \(z_{t-1}\), \(a_{t-1}\) 이 GRU 로 들어가 \(h_t\) 가 된다.
- \(h_t\) 에서 사전 \(p(z_t \mid h_t)\) 가 나온다.
- 관측·보상 디코더는 상태 전체 \((h_t, z_t)\) 에서 \(o_t\), \(r_t\) 를 낸다.
- 추론 경로는 그림 \(o_t\) 를 보고 \(z_t\) 를 고쳐 잡는 사후 \(q(z_t \mid h_t, o_t)\) 하나뿐이다. 생성 모델에는 \(o \to z\) 화살표가 없다.
①, ②, ④, ⑤ 는 그림 없이 계산할 수 있는 생성 모델이고 ③ 만 그림을 본다. 학습이 끝나면 ① → ② 만 반복해 그림 없이 미래를 상상할 수 있다. 이것이 World Model 의 "꿈" 이다.
분포의 모양: 대각 가우시안
사전과 사후는 모두 차원마다 독립인 대각 가우시안이다(Normal distribution).
\(p_\theta(z_t \mid h_t) = \mathcal{N}\big(z_t;\ \mu_\theta(h_t),\ \operatorname{diag}(\sigma_\theta(h_t)^2)\big)\)
\(q_\phi(z_t \mid h_t, o_t) = \mathcal{N}\big(z_t;\ \mu_\phi(h_t, e_t),\ \operatorname{diag}(\sigma_\phi(h_t, e_t)^2)\big)\)
\(e_t = \mathrm{enc}_\phi(o_t)\) 는 합성곱 인코더가 그림에서 뽑은 특징 벡터(1024개 숫자)다. 표준편차는 신경망 출력 \(x\) 에 softplus 를 거친 뒤 최솟값을 더해 만든다(F.softplus(std) + self.min_std).
\(\sigma = \operatorname{softplus}(x) + \sigma_{\min} = \log(1 + e^{x}) + 0.1\)
- \(e^x \gt 0\) 이므로 \(\log(1 + e^x) \gt \log 1 = 0\) 이고, \(x\) 가 어떤 값이든 \(\sigma \gt 0.1\) 이다. \(\sigma_{\min} = 0.1\) 은 분포가 한 점으로 쪼그라들지 않게 하는 바닥값이다.
- 미분은 연쇄 법칙으로 \(\frac{d}{dx}\log(1 + e^{x}) = \frac{e^{x}}{1 + e^{x}} = \frac{1}{1 + e^{-x}} = \operatorname{sigmoid}(x)\) 이다. 기울기가 0 과 1 사이로 늘 살아 있어 학습이 안정적이다.
- 예: \(x = 0\) 이면 \(\sigma = \log 2 + 0.1 \approx 0.793\), 기울기는 0.5 이다.
결정 상태 모델: GRU
\([z_{t-1}, a_{t-1}]\) 을 선형층과 ELU 활성화로 200차원 입력 \(x_t\) 로 바꾸고, GRU 가 이전 기억 \(h_{t-1}\) 과 섞는다. ELU 는 \(x \gt 0\) 이면 \(x\), \(x \le 0\) 이면 \(e^x - 1\) 이다. 음수 쪽이 매끄럽게 \(-1\) 로 다가가고, 기울기 \(e^x\) 는 작아질 뿐 ReLU 처럼 정확히 0 이 되지는 않는다. nn.GRUCell 의 계산식은 다음과 같다(\(\odot\) 는 원소별 곱).
\(\begin{align} \rho_t &= \operatorname{sigmoid}(W_\rho x_t + U_\rho h_{t-1} + b_\rho) && \text{(리셋 게이트: 옛 기억을 얼마나 볼지)} \\ u_t &= \operatorname{sigmoid}(W_u x_t + U_u h_{t-1} + b_u) && \text{(갱신 게이트: 옛 기억을 얼마나 남길지)} \\ n_t &= \tanh\big(W_n x_t + b_n + \rho_t \odot (U_n h_{t-1} + b'_n)\big) && \text{(새 후보 기억)} \\ h_t &= (1 - u_t) \odot n_t + u_t \odot h_{t-1} && \text{(옛 기억과 새 후보를 섞기)} \end{align}\)
9장과 같은 구조에 표기만 다르다. \(r\) 은 보상에 쓰므로 리셋 게이트를 \(\rho_t\) 로, 후보 \(\tilde h_t\) 를 PyTorch 이름대로 \(n_t\) 로 적었다. 리셋 게이트는 \(h_{t-1}\) 에 먼저 곱하지 않고 \(U_n h_{t-1} + b'_n\) 을 계산한 뒤에 곱한다. 마지막 줄에서 \(u_t\) 가 1 에 가까운 칸은 옛 기억을 거의 그대로 넘기므로 정보가 잡음 없이 여러 스텝을 건너간다. 확률적 SSM 의 약점을 RSSM 이 피하는 이유가 이 길이다.
코드: RSSM
mlp(입력, 너비, 출력, layers=n) 은 (선형층 → ELU)를 n 번 쌓고 마지막에 선형층을 하나 더 붙이는 도우미 함수다.
class RSSM(nn.Module):
    """순환 상태 공간 모델 (Recurrent State-Space Model).

    결정 경로   h_t = f(h_{t-1}, z_{t-1}, a_{t-1})      ← GRU
    사전(prior) p(z_t | h_t)        = N(μ, σ²)        ← 그림을 보기 전의 예측
    사후(post)  q(z_t | h_t, e_t)   = N(μ', σ'²)      ← 그림 특징 e_t 까지 본 추측
    """

    def __init__(self, act_dim: int, embed_dim: int, deter=200, stoch=30, hidden=200, min_std=0.1):
        super().__init__()
        self.deter, self.stoch, self.min_std = deter, stoch, min_std
        self.inp = nn.Linear(stoch + act_dim, hidden)  # [z_{t-1}, a_{t-1}] → GRU 입력
        self.gru = nn.GRUCell(hidden, deter)
        self.prior_net = mlp(deter, hidden, 2 * stoch, layers=1)
        self.post_net = mlp(deter + embed_dim, hidden, 2 * stoch, layers=1)

    def initial(self, batch: int, device) -> tuple[torch.Tensor, torch.Tensor]:
        return torch.zeros(batch, self.deter, device=device), torch.zeros(batch, self.stoch, device=device)

    def _dist(self, x: torch.Tensor):
        mean, std = x.chunk(2, dim=-1)
        std = F.softplus(std) + self.min_std  # 표준편차는 늘 양수, 그리고 min_std 이상
        return mean, std

    def img_step(self, h, z, action, sample: bool = True):
        """그림 없이 한 스텝 상상한다: (h_{t-1}, z_{t-1}, a_{t-1}) → h_t, z_t ~ p(z_t | h_t)."""
        x = F.elu(self.inp(torch.cat([z, action], -1)))
        h = self.gru(x, h)
        mean, std = self._dist(self.prior_net(h))
        z = mean + std * torch.randn_like(std) if sample else mean  # 재매개변수화
        return h, z, mean, std

    def obs_step(self, h, z, action, embed):
        """그림을 보며 한 스텝: 사전으로 h_t 를 만든 뒤, 그림 특징 e_t 로 z_t 를 고쳐 잡는다."""
        h, _, prior_mean, prior_std = self.img_step(h, z, action)
        post_mean, post_std = self._dist(self.post_net(torch.cat([h, embed], -1)))
        z = post_mean + post_std * torch.randn_like(post_std)
        return h, z, (prior_mean, prior_std), (post_mean, post_std)

    def observe(self, embeds, prev_actions, h=None, z=None):
        """시퀀스 전체를 시간 순서대로 펼친다. embeds (B, L, E), prev_actions (B, L, A)."""
        B, L = embeds.shape[:2]
        if h is None:
            h, z = self.initial(B, embeds.device)
        out = {k: [] for k in ("h", "z", "prior_mean", "prior_std", "post_mean", "post_std")}
        for t in range(L):
            h, z, (pm, ps), (qm, qs) = self.obs_step(h, z, prev_actions[:, t], embeds[:, t])
            for k, v in zip(out, (h, z, pm, ps, qm, qs)):
                out[k].append(v)
        return {k: torch.stack(v, dim=1) for k, v in out.items()}  # 모두 (B, L, ·)
-
img_step: 눈을 감고 한 스텝. GRU 로 \(h_t\) 를 만들고 사전에서 \(z_t\) 를 뽑는다.mean + std * torch.randn_like(std)는 8장의 재매개변수화 트릭(reparameterization trick)으로, 뽑기를 고정된 잡음 \(\epsilon \sim \mathcal{N}(0, I)\) 에 표준편차를 곱하고 평균을 더하는 계산으로 바꿔 \(\mu\), \(\sigma\) 로 기울기가 흐르게 한다. 12장에서 이 성질이 결정적으로 쓰인다. -
obs_step: 눈을 뜨고 한 스텝.img_step으로 \(h_t\) 와 사전을 만든 뒤 같은 \(h_t\) 에 그림 특징 \(e_t\) 를 붙여 사후를 만들고 거기서 \(z_t\) 를 뽑는다. 다음 스텝으로 넘기는 것은 사후에서 뽑은 \(z_t\) 다. -
observe: 시퀀스 전체에obs_step을 적용한다. \(h_t\) 가 \(h_{t-1}\) 에 의존하므로 시간축은 반드시 차례로 돈다.
순차 ELBO 의 유도
RSSM 의 모든 부품은 하나의 목표로 함께 학습된다. 그림과 보상의 시퀀스 전체의 로그 확률을 키우는 최대우도다(Maximum likelihood estimation).
\(\max_{\theta,\phi}\ \log p_\theta(o_{1:T},\ r_{1:T} \mid a_{0:T-1})\)
이 확률은 직접 계산할 수 없어 하한(ELBO)을 대신 키운다. 유도는 (1) 결합 분포의 인수분해, (2) 주변화, (3) \(q\) 를 곱하고 나눈 뒤 젠센 부등식, (4) 기댓값의 시간별 분리 순서다. 아래에서 행동 \(a_{0:T-1}\) 은 늘 주어진 값이라 조건에서 생략한다. \(h_t\) 는 \(z_{1:t-1}\) 과 행동에서 GRU 가 계산하는 값이고 확률 변수는 \(z_{1:T}\) 뿐이다. \(h_0\), \(z_0\) 은 0 벡터다. 식은 합을 \(t = 1\) 부터 적지만 코드는 첫 그림 \(o_0\) 도 "직전 행동 0, \(h = z = 0\) 에서 출발한 한 칸" 으로 다뤄 재구성·KL 항에 넣는다(보상 항만 \(t = 0\) 을 뺀다).
1단계: 결합 분포의 인수분해
확률의 연쇄 법칙으로 시각 \(t\) 의 세 변수 \((z_t, o_t, r_t)\) 를 한 덩어리로 늘어놓고, 덩어리 안에서 한 번 더 쓴다("과거" 는 \(z_{1:t-1}, o_{1:t-1}, r_{1:t-1}\)).
\(p(o_{1:T}, r_{1:T}, z_{1:T}) = \prod_{t=1}^{T} p(z_t, o_t, r_t \mid z_{1:t-1}, o_{1:t-1}, r_{1:t-1})\)
\(p(z_t, o_t, r_t \mid \text{과거}) = p(z_t \mid \text{과거})\; p(o_t \mid z_t, \text{과거})\; p(r_t \mid o_t, z_t, \text{과거})\)
여기에 모델의 가정 두 개를 넣는다.
- 가정 ①: \(p(z_t \mid \text{과거}) = p(z_t \mid h_t)\). \(z_t\) 는 \(h_t\) 로만 과거에 의존한다. 과거의 \(o\), \(r\) 은 생성 모델에서 \(z\) 로부터 만들어지는 결과일 뿐 \(z_t\) 에 직접 영향을 주지 않는다.
- 가정 ②: \(p(o_t \mid z_t, \text{과거}) = p(o_t \mid h_t, z_t)\), \(p(r_t \mid o_t, z_t, \text{과거}) = p(r_t \mid h_t, z_t)\). 그림과 보상은 지금 상태 \(s_t = (h_t, z_t)\) 만 보고 만들어진다. \(r_t\) 가 \(o_t\) 에 직접 의존하지 않는다는 가정도 들어 있다.
\(p(o_{1:T}, r_{1:T}, z_{1:T}) = \prod_{t=1}^{T} p(z_t \mid h_t)\; p(o_t \mid h_t, z_t)\; p(r_t \mid h_t, z_t), \qquad h_t = f(h_{t-1}, z_{t-1}, a_{t-1})\)
결합 분포는 시각마다 사전 × 관측 × 보상의 곱이고, 세 부품이 코드의 prior_net, Decoder, reward 다. 추론 모델 \(q\) 는 유도가 아니라 설계로, 미래 그림을 보지 않는 필터링 형태의 시간별 곱으로 정의한다. 여기서 \(h_t\) 는 사후에서 뽑은 \(z_{1:t-1}\) 로 계산한 값이다.
\(q(z_{1:T} \mid o_{1:T}) = \prod_{t=1}^{T} q(z_t \mid h_t, o_t)\)
2·3단계: 주변화와 젠센 부등식
\(\begin{align} \log p(o_{1:T}, r_{1:T}) &= \log \int p(o_{1:T}, r_{1:T}, z_{1:T})\, dz_{1:T} \\ &= \log \int q(z_{1:T} \mid o_{1:T})\, \frac{p(o_{1:T}, r_{1:T}, z_{1:T})}{q(z_{1:T} \mid o_{1:T})}\, dz_{1:T} \\ &= \log \mathbb{E}_{q}\left[ \frac{p(o_{1:T}, r_{1:T}, z_{1:T})}{q(z_{1:T} \mid o_{1:T})} \right] \\ &\ge \mathbb{E}_{q}\left[ \log \frac{p(o_{1:T}, r_{1:T}, z_{1:T})}{q(z_{1:T} \mid o_{1:T})} \right] \\ &= \mathbb{E}_{q}\left[ \sum_{t=1}^{T} \Big( \log p(o_t \mid h_t, z_t) + \log p(r_t \mid h_t, z_t) + \log p(z_t \mid h_t) - \log q(z_t \mid h_t, o_t) \Big) \right] \\ &= \sum_{t=1}^{T} \Big( \mathbb{E}_{q}[\log p(o_t \mid h_t, z_t)] + \mathbb{E}_{q}[\log p(r_t \mid h_t, z_t)] + \mathbb{E}_{q}[\log p(z_t \mid h_t) - \log q(z_t \mid h_t, o_t)] \Big) \end{align}\)
- 첫 줄은 주변화다. 적분은 30차원 × \(T\) 스텝이라 직접 계산할 수 없다.
- 둘째 줄은 \(q/q = 1\) 을 곱한 것이다(\(q\) 는 가우시안이라 어디서나 0 보다 크다).
- 셋째 줄은 기댓값의 정의 \(\int q(z)\, g(z)\, dz = \mathbb{E}_{z \sim q}[g(z)]\) 다.
- 넷째 줄은 젠센 부등식이다. \(\log\) 가 오목 함수이므로 \(\log \mathbb{E}[X] \ge \mathbb{E}[\log X]\) 이고, 부등호가 여기서 처음 나온다.
- 다섯째 줄은 인수분해와 \(q\) 의 정의를 넣고 곱의 로그를 합으로, 나눗셈의 로그를 차로 푼 것이다.
- 여섯째 줄은 기댓값의 선형성이다.
4단계: 기댓값을 시간별로 쪼개 KL 만들기
시각 \(t\) 의 항은 \(z_{1:t}\) 에만 의존한다. 쓰지 않는 미래 변수는 기댓값에서 빠진다. \(q(z_{1:T}) = q(z_{1:t})\, q(z_{t+1:T} \mid z_{1:t})\) 로 나누면 안쪽 적분이 1 이 되기 때문이다.
\(\mathbb{E}_{q(z_{1:T})}[g(z_{1:t})] = \int q(z_{1:t})\, g(z_{1:t}) \left[ \int q(z_{t+1:T} \mid z_{1:t})\, dz_{t+1:T} \right] dz_{1:t} = \mathbb{E}_{q(z_{1:t})}[g(z_{1:t})]\)
사전·사후 항은 \(q(z_{1:t}) = q(z_{1:t-1})\, q(z_t \mid h_t, o_t)\) 로 기댓값을 두 겹으로 나눈 뒤(반복 기댓값) 안쪽을 KL 발산으로 묶는다. 바깥 기댓값이 \(h_t\) 를 정하고 안쪽은 \(z_t\) 하나에 대한 기댓값이다.
\(\begin{align} \mathbb{E}_{q(z_{1:t})}\big[\log p(z_t \mid h_t) - \log q(z_t \mid h_t, o_t)\big] &= \mathbb{E}_{q(z_{1:t-1})}\Big[ \mathbb{E}_{q(z_t \mid h_t, o_t)}\big[\log p(z_t \mid h_t) - \log q(z_t \mid h_t, o_t)\big] \Big] \\ &= \mathbb{E}_{q(z_{1:t-1})}\Big[ -\mathbb{E}_{q(z_t \mid h_t, o_t)}\Big[\log \frac{q(z_t \mid h_t, o_t)}{p(z_t \mid h_t)}\Big] \Big] \\ &= -\mathbb{E}_{q(z_{1:t-1})}\Big[ D_{\mathrm{KL}}\big(q(z_t \mid h_t, o_t) \parallel p(z_t \mid h_t)\big) \Big] \end{align}\)
결과
\(\log p(o_{1:T}, r_{1:T}) \ge \sum_{t=1}^{T} \Big( \underbrace{\mathbb{E}_{q}\big[\log p(o_t \mid h_t, z_t)\big]}_{\text{① 재구성}} + \underbrace{\mathbb{E}_{q}\big[\log p(r_t \mid h_t, z_t)\big]}_{\text{② 보상 예측}} - \underbrace{\mathbb{E}_{q}\big[D_{\mathrm{KL}}\big(q(z_t \mid h_t, o_t) \parallel p(z_t \mid h_t)\big)\big]}_{\text{③ 사전과 사후의 차이}} \Big)\)
학습은 이 하한을 키우는 것이고, 코드에서는 그 음수인 손실 = 재구성 손실 + 보상 손실 + KL 을 줄인다.
VAE 의 ELBO 는 "재구성 − KL(사후 ‖ 고정된 표준 정규 분포)" 였다. 순차 ELBO 는 그것을 시각마다 더한 것이지만 KL 의 상대가 고정된 \(\mathcal{N}(0, I)\) 가 아니라 과거로부터 예측한 사전 \(p(z_t \mid h_t)\) 다. VAE 의 KL 은 잠재 공간을 정돈하는 역할이었고, 순차 ELBO 의 KL 은 "과거만 보고도 지금의 잠재 상태를 맞혀라", 곧 동역학을 배우라는 학습 신호다. 사전 모델(②)이 학습되는 유일한 통로가 이 KL 항이다.
하한과 진짜 값의 차이
젠센 부등식에서 잃은 차이는 추론 분포와 진짜 사후 분포 사이의 KL 이다(아래첨자 \(1{:}T\) 생략).
\(\begin{align} \log p(o, r) - \text{ELBO} &= \mathbb{E}_{q}\big[\log p(o, r)\big] - \mathbb{E}_{q}\left[\log \frac{p(o, r, z)}{q(z \mid o)}\right] \\ &= \mathbb{E}_{q}\left[\log q(z \mid o) - \log \frac{p(o, r, z)}{p(o, r)}\right] \\ &= \mathbb{E}_{q}\big[\log q(z \mid o) - \log p(z \mid o, r)\big] \\ &= D_{\mathrm{KL}}\big(q(z_{1:T} \mid o_{1:T}) \parallel p(z_{1:T} \mid o_{1:T}, r_{1:T})\big) \ge 0 \end{align}\)
ELBO 는 언제나 진짜 로그 가능도 이하이고, \(q\) 가 진짜 사후 분포에 가까워질수록 하한이 빈틈없어진다.
기댓값의 어림과 KL 의 닫힌 꼴
기댓값 \(\mathbb{E}_q\) 는 몬테카를로 추정으로, 시퀀스마다 사후에서 \(z_1, \dots, z_T\) 를 한 번 뽑아 계산한다. 배치에 시퀀스가 50개 있어 평균을 내면 잡음이 줄고, 뽑기가 재매개변수화라 \(\theta\), \(\phi\) 로 미분할 수 있다. KL 항은 표본이 필요 없다. 두 대각 가우시안 사이의 KL 은 닫힌 꼴이 있다(차원마다 계산해 더한다).
\(D_{\mathrm{KL}}\big(\mathcal{N}(\mu_q, \sigma_q^2) \parallel \mathcal{N}(\mu_p, \sigma_p^2)\big) = \log\frac{\sigma_p}{\sigma_q} + \frac{\sigma_q^2 + (\mu_q - \mu_p)^2}{2\sigma_p^2} - \frac{1}{2}\)
def gaussian_kl(mean_q, std_q, mean_p, std_p):
    """대각 가우시안 두 개의 KL(q ‖ p), 차원별 값 (3장에서 유도한 닫힌 꼴).

    KL = log(σ_p/σ_q) + (σ_q² + (μ_q − μ_p)²) / (2σ_p²) − 1/2
    """
    return (
        torch.log(std_p / std_q)
        + (std_q**2 + (mean_q - mean_p) ** 2) / (2 * std_p**2)
        - 0.5
    )
수치 예: 1차원에서 사후 \(q = \mathcal{N}(0.5,\ 0.2^2)\), 사전 \(p = \mathcal{N}(0,\ 1^2)\) 이면 \(\log 5 + \frac{0.04 + 0.25}{2} - 0.5 = 1.6094 + 0.145 - 0.5 = 1.2544\) 내트다. PyTorch 의 kl_divergence 도 1.2544, 표본 200만 개의 몬테카를로 값도 1.254 다. 그림을 보고 새로 알게 된 정보가 약 1.25 내트라는 뜻이다.
각 항의 뜻과 자유 내트
① 재구성 항
관측 모델은 픽셀마다 평균이 디코더 출력 \(\hat{o}_t\) 이고 분산이 1 인 가우시안이다. 픽셀 하나의 로그 밀도는 \(\log \mathcal{N}(o_i;\ \hat{o}_i,\ 1) = -\tfrac{1}{2}\log(2\pi) - \tfrac{1}{2}(o_i - \hat{o}_i)^2\) 이고, 픽셀끼리 독립이라 그림 전체는 합이다(\(D = 64 \times 64 = 4096\)).
\(-\log p(o_t \mid h_t, z_t) = \frac{1}{2}\sum_{i=1}^{D}(o_i - \hat{o}_i)^2 + \text{상수}\)
코드의 0.5 * ((recon - obs) ** 2).sum(dim=(-2, -1)) 이며, 픽셀에 대해 평균이 아니라 합이다. 예: \(o = (0.5, -0.5, -0.5)\) 를 \(\hat{o} = (0.3, -0.4, -0.5)\) 로 복원하면 손실은 \(\frac{1}{2}(0.04 + 0.01) = 0.025\) 다. 그림은 preprocess 로 0 ~ 255 를 −0.5 ~ 0.5 로 옮겨 쓴다(검은 바탕 −0.5, 흰 막대 0.5).
② 보상 항
보상 모델도 분산 1 가우시안이라 손실은 \(\frac{1}{2}(r_t - \hat{r}_t)^2\) 다. 두 가지를 손봤다.
- 보상 크기 맞추기: 행동 반복 2 의 진자 보상은 한 결정에 −33 에서 0 사이다. 학습할 때
reward_scale = 0.1을 곱해 −3.3 에서 0 정도로 줄인다. 계획은 보상의 순위만 보므로 결과에 영향이 없고, 12장의 가치 함수 학습은 크기가 작을수록 수월하다. - 첫 시각 빼기: 첫 그림 \(o_0\) 에는 도착하며 받은 보상이 없으므로
first표시로 손실에서 뺀다.
③ KL 항
KL 의 기울기는 \(\phi\)(사후)와 \(\theta\)(사전) 양쪽으로 흐른다.
- 사전 쪽: "그림을 보지 않고도 사후가 할 추측을 미리 맞혀라." 사전과 GRU 가 미래를 예측하는 능력, 곧 동역학을 배운다.
- 사후 쪽: "예측할 수 있는 것 이상의 정보는 되도록 담지 마라." 사후의 정보량을 제한한다.
재구성 항은 반대로 그림을 설명할 정보를 충분히 담으라고 당긴다. 그 결과 사후는 그림을 설명하는 데 필요한 정보 가운데 과거로부터 예측하기 어려운 새 정보만 \(z_t\) 에 담는다. 진자는 각도와 속도가 대부분 과거에서 예측되므로 KL 이 작다.
자유 내트
학습 초반에 KL 항이 너무 세면 사후가 그림을 무시하고 사전과 똑같아지는 쪽(KL = 0)으로 무너진다(사후 붕괴, posterior collapse). 그러면 \(z\) 에 정보가 없어 재구성도 동역학도 배울 수 없다. PlaNet 은 자유 내트(free nats)로 이를 막는다.
\(\mathcal{L}_{\text{KL}} = \max\big(D_{\mathrm{KL}},\ 3\big)\)
내트(nat)는 자연로그로 잰 정보량 단위이고 1 내트 \(= 1/\ln 2 \approx 1.443\) 비트다. 한 스텝에 3 내트까지는 KL 로 벌하지 않는다는 뜻이다. 기울기는 다음과 같다.
\(\frac{\partial}{\partial x}\max(x, c) = \begin{cases} 1 & (x \gt c) \\ 0 & (x \lt c) \end{cases}\)
- KL 이 3 아래로 내려가면 KL 로 가는 기울기가 완전히 꺼지고 모델은 재구성과 보상만 신경 쓴다. 예: KL = 1.25 이면 \(\max(1.25, 3) = 3\), 기울기 0.
- 구현은 Dreamer 공개 코드처럼 배치·시간 평균 KL 에 이 규칙을 적용한다(
torch.clamp(kl, min=cfg.free_nats)). - 주의: KL 항은 사전을 가르치는 유일한 통로인데, 평균 KL 이 3 아래인 학습 스텝에서는 기울기가 꺼지므로 사전도 그 스텝에는 배우지 않는다. 사전은 재구성 손실이 사후를 움직여 KL 이 3 을 넘는 스텝마다 사후를 다시 따라잡는 식으로 배운다. KL 이 3 바로 아래에서 맴도는 것이 그 흔적이다.
각 항의 크기
재구성 손실은 픽셀 4096개의 합이라 처음에는 수백이고, KL 은 몇 내트, 보상 손실은 1 보다 작다. 순차 ELBO 를 그대로 따르면 이 비율이 정답이다(그림 한 장은 보상 숫자 하나보다 훨씬 많은 정보를 담는다). 다만 이 비율 때문에 모델이 그림의 세부만 신경 쓰고 보상을 소홀히 할 수 있어, Dreamer 계열은 나중에 항마다 가중치를 따로 준다(12장의 DreamerV3).
코드: 손실 함수
    def loss(self, batch: dict):
        """순차 ELBO 의 음수 = 재구성 + 보상 + KL. 12장이 쓰도록 사후 상태도 돌려준다."""
        cfg = self.cfg
        obs = batch["obs"]  # (B, L, 64, 64)
        embed = self.encoder(obs)  # (B, L, 1024)
        states = self.rssm.observe(embed, batch["prev_action"])
        feat = self.feat(states["h"], states["z"])  # (B, L, 230)

        # ① 재구성: -log p(o_t | h_t, z_t), 분산 1 가우시안 → ½·Σ(o - ô)² (+ 상수)
        recon = self.decoder(feat)
        recon_loss = 0.5 * ((recon - obs) ** 2).sum(dim=(-2, -1)).mean()

        # ② 보상: -log p(r_t | h_t, z_t) → ½·(r - r̂)². 에피소드 첫 시각은 보상이 없으니 뺀다.
        target_r = batch["reward"] * cfg.reward_scale
        mask = 1.0 - batch["first"]
        pred_r = self.reward(feat).squeeze(-1)
        reward_loss = (0.5 * (pred_r - target_r) ** 2 * mask).sum() / mask.sum()

        # ③ KL(q(z_t | h_t, o_t) ‖ p(z_t | h_t)), 자유 내트: 평균 KL 이 free_nats 보다 작으면 기울기 0
        kl = gaussian_kl(states["post_mean"], states["post_std"], states["prior_mean"], states["prior_std"])
        kl = kl.sum(-1).mean()  # z 의 차원끼리는 더하고, 배치 · 시간으로는 평균
        kl_loss = torch.clamp(kl, min=cfg.free_nats)

        loss = recon_loss + reward_loss + cfg.kl_scale * kl_loss
        metrics = dict(recon=recon_loss.item(), reward=reward_loss.item(), kl=kl.item())
        return loss, metrics, states
WorldModel 은 Encoder, RSSM, Decoder, 보상 MLP(mlp(feat_dim, hidden, 1, layers=2))를 묶은 것이고 특징은 \([h_t, z_t]\) 를 붙인 230차원이다. 시각에 대한 합은 .mean()(배치·시간 평균)으로 계산한다. 합을 \(B \cdot T\) 로 나눈 것이라 최적점은 같다.
잠재 과대 예측
KL 항은 사후와 "바로 앞 스텝까지는 진짜 그림을 본" 사전을 비교한다(\(h_t\) 가 사후에서 뽑은 \(z_{t-1}\) 로 계산된다). 곧 사전은 한 스텝 예측만 훈련받는다. 그런데 계획할 때는 그림 없이 사전을 여러 스텝(CEM 은 12 스텝) 연달아 굴리므로, 6장의 오차 누적 문제가 잠재 공간에서도 생길 수 있다.
PlaNet 논문은 잠재 과대 예측(latent overshooting)을 제안했다. \(d\) 스텝 전의 사후에서 출발해 사전만으로 \(d-1\) 스텝 굴려 \(s_{t-1}\) 을 뽑고, 거기서 낸 한 스텝 사전을 지금의 사후와 비교하는 KL 항을 \(d = 1, \dots, D\) 에 대해 더한다.
\(\sum_{t=1}^{T} \Big( \mathbb{E}_q[\log p(o_t \mid s_t)] - \frac{1}{D}\sum_{d=1}^{D} \beta_d\, \mathbb{E}_{p(s_{t-1} \mid s_{t-d})\, q(s_{t-d} \mid o_{\le t-d})}\big[D_{\mathrm{KL}}\big(q(s_t \mid o_{\le t}) \parallel p(s_t \mid s_{t-1})\big)\big] \Big)\)
\(p(s_{t-1} \mid s_{t-d})\) 는 사전을 \(d-1\) 번 이어 붙인 여러 스텝 예측 분포이고 \(\beta_d\) 는 스텝 수별 가중치다. KL 안에는 늘 한 스텝 사전이 들어가 닫힌 꼴로 계산된다. \(D = 1\), \(\beta_1 = 1\) 이면 원래의 순차 ELBO 다. 계산량이 늘고 효과가 모델 종류에 따라 달라 Dreamer 계열은 쓰지 않았고, 이 장의 구현도 쓰지 않는다.
잠재 공간에서 계획하기: CEM
7장의 교차 엔트로피 방법(CEM)을 잠재 상태 \((h_t, z_t)\) 위에서 굴린다. 매 결정마다 다음을 한다.
- 필터링: 방금 받은 그림 \(o_t\) 로 믿음 상태를 갱신한다. \(h_t = f(h_{t-1}, z_{t-1}, a_{t-1})\), \(z_t \sim q(z_t \mid h_t, o_t)\) (
LatentAgent.act). - 계획: \((h_t, z_t)\) 에서 출발해 \(H\) 스텝의 행동열을 CEM 으로 최적화한다. 상상 속 상태는 사전에서 뽑는다(\(h_\tau = f(h_{\tau-1}, z_{\tau-1}, a_{\tau-1})\), \(z_\tau \sim p(z_\tau \mid h_\tau)\)).
- 실행: 계획의 첫 행동 \(a^*_t\) 만 실행하고, 다음 그림이 오면 처음부터 다시 계획한다(7장의 MPC).
\(a^*_{t:t+H-1} = \operatorname*{arg\,max}_{a_{t:t+H-1}}\ \mathbb{E}_{p}\left[\sum_{\tau=t+1}^{t+H} \hat{r}_\tau\right], \qquad \hat{r}_\tau = \text{보상 모델}(h_\tau, z_\tau)\)
CEM 의 한 반복
행동은 \([-1, 1]\) 로 정규화한 값이고 환경에 줄 때 2 를 곱해 토크로 바꾼다. 다음을 \(I\) 번 되풀이한다.
- 평균 \(\mu \in \mathbb{R}^{H}\), 표준편차 \(\sigma \in \mathbb{R}^{H}\) 인 가우시안에서 행동열 후보 \(J\) 개를 뽑는다(처음엔 \(\mu = 0\), \(\sigma = 1\)).
- 후보 \(J\) 개를 배치로 한꺼번에 모델 안에서 \(H\) 스텝 굴려 보상 합을 잰다.
- 보상 합이 가장 큰 \(K\) 개(정예, elite)의 평균과 표준편차로 \(\mu\), \(\sigma\) 를 바꾼다.
정예로 가우시안을 다시 맞추는 것은 가우시안 최대우도와 같다. 행동열의 칸마다 따로 계산한다.
\(\mu \leftarrow \frac{1}{K}\sum_{k=1}^{K} a^{(k)}, \qquad \sigma^2 \leftarrow \frac{1}{K}\sum_{k=1}^{K}\big(a^{(k)} - \mu\big)^2, \qquad (\mu, \sigma^2) = \operatorname*{arg\,max}_{\mu, \sigma^2} \sum_{k=1}^{K} \log \mathcal{N}\big(a^{(k)};\ \mu,\ \sigma^2\big)\)
코드의 elite.std(0) 는 기본값으로 \(K-1\) 로 나누는 불편 분산의 제곱근이지만 \(K = 100\) 이라 차이는 1% 미만이다.
계획 설정과 비용
| 기호 | 뜻 | 값 |
| \(H\) | 계획 길이(몇 스텝 앞까지 상상할지) | 12 |
| \(I\) | CEM 반복 횟수 | 10 |
| \(J\) | 반복마다 뽑는 후보 수 | 1000 |
| \(K\) | 정예 수 | 100 |
결정 한 번에 RSSM 을 \(I \times H \times J = 10 \times 12 \times 1000 = 120{,}000\) 스텝 굴린다(1000개는 배치로 동시에 굴리므로 순차 계산은 120번). 한 에피소드는 결정 100번이니 1200만 스텝이다. 이 비용이 12장에서 Dreamer 가 계획 대신 정책을 배우는 이유다. 매 결정마다 \(\mu, \sigma\) 를 0 과 1 로 되돌려 새로 계획하고, 데이터를 모을 때는 탐험을 위해 고른 행동에 \(\mathcal{N}(0, 0.3^2)\) 잡음을 더한다.
@torch.no_grad()
def cem_plan(wm: WorldModel, h, z, cfg: Config, act_dim: int = 1):
    """잠재 공간에서 CEM 으로 앞으로 H 스텝의 행동열을 고르고, 첫 행동만 돌려준다.

    h, z: 지금의 믿음 상태 (1, ·). 행동은 [-1, 1] 로 정규화한 값.
    """
    H, J, K = cfg.plan_horizon, cfg.plan_candidates, cfg.plan_elites
    mean = torch.zeros(H, act_dim, device=h.device)
    std = torch.ones(H, act_dim, device=h.device)
    for _ in range(cfg.plan_iters):
        # ① 후보 J 개를 N(mean, std²) 에서 뽑는다: (J, H, A)
        actions = (mean + std * torch.randn(J, H, act_dim, device=h.device)).clamp(-1, 1)
        # ② 모델 안에서 J 개를 한꺼번에 굴려 보상 합을 잰다
        hj, zj = h.expand(J, -1), z.expand(J, -1)
        total = torch.zeros(J, device=h.device)
        for t in range(H):
            hj, zj, _, _ = wm.rssm.img_step(hj, zj, actions[:, t])
            total += wm.reward(wm.feat(hj, zj)).squeeze(-1)
        # ③ 보상 합이 가장 큰 K 개(정예)를 골라 평균 · 표준편차를 다시 맞춘다
        elite = actions[total.topk(K).indices]  # (K, H, A)
        mean, std = elite.mean(0), elite.std(0)
    return mean[0:1]  # (1, A): 계획의 첫 행동
-
h.expand(J, -1)은 지금의 믿음 상태 하나를 후보 \(J\) 개가 함께 쓰도록 복사 없이 늘린다. - 상상 속에서는
img_step만 쓴다. 미래 그림이 없으니 사후를 쓸 수 없고, 그래서 사전이 여러 스텝을 잘 예측해야 한다. -
@torch.no_grad()로 기울기 기록을 꺼서 메모리와 시간을 아낀다.
class LatentAgent:
    """그림을 하나씩 받으며 믿음 상태 (h, z) 를 갱신하고, choose() 로 행동을 고른다."""

    def __init__(self, wm: WorldModel, choose, act_dim: int = 1):
        self.wm, self.choose, self.act_dim = wm, choose, act_dim
        self.device = next(wm.parameters()).device

    def reset(self):
        self.h, self.z = self.wm.rssm.initial(1, self.device)
        self.prev_action = torch.zeros(1, self.act_dim, device=self.device)

    @torch.no_grad()
    def act(self, obs: np.ndarray, explore_noise: float = 0.0) -> np.ndarray:
        o = preprocess(torch.as_tensor(obs, device=self.device))[None]  # (1, 64, 64)
        embed = self.wm.encoder(o)
        self.h, self.z, _, _ = self.wm.rssm.obs_step(self.h, self.z, self.prev_action, embed)
        a = self.choose(self.h, self.z)  # (1, A), [-1, 1]
        if explore_noise > 0:
            a = (a + explore_noise * torch.randn_like(a)).clamp(-1, 1)
        self.prev_action = a
        return a[0].cpu().numpy()
행동을 고르는 방법은 바깥에서 받는다(choose). PlaNet 은 choose = cem_plan 이고, 12장의 Dreamer 는 같은 클래스에 정책 신경망을 넣는다. WorldModel, ReplayBuffer, LatentAgent, run_episode 는 ch12_dreamer.py 가 그대로 가져다 쓴다.
전체 학습 고리
모델 학습과 데이터 수집을 번갈아 한다. 처음에는 무작위 행동으로 시작하고, 모델이 나아질수록 계획이 좋아져 진자가 위에 있는 상태의 데이터가 모이며, 그 데이터로 모델이 다시 나아진다.
데이터 D ← 무작위 행동 에피소드 S 개
되풀이 (iterations 번):
    C 번 되풀이:                                  # 모델 학습
        D 에서 길이 L 인 조각 B 개를 뽑는다
        순차 ELBO 손실 = 재구성 + 보상 + max(KL, 자유 내트)
        Adam 으로 θ, φ 를 한 스텝 고친다
    에피소드 하나를 모은다:                        # 데이터 수집
        매 결정마다: 그림으로 (h, z) 갱신 → CEM 계획 → 첫 행동 + 잡음 N(0, 0.3²) 실행
    그 에피소드를 D 에 넣는다
행동 반복 2
행동 반복(action repeat)은 같은 행동을 환경에서 여러 스텝 되풀이하는 것이다(PixelPendulum(action_repeat=2)). PlaNet 은 과제마다 2 ~ 8 을 썼다.
- 좋은 점: 결정 횟수가 200 → 100 으로 줄어, 같은 \(H = 12\) 가 실제 시간 \(12 \times 2 \times 0.05 = 1.2\) 초를 내다본다. 진자가 한 번 흔들리는 시간(약 2초)의 절반 이상이라 지금의 토크가 흔들림에 주는 효과를 계획이 볼 수 있다. 계산도 절반이다.
- 나쁜 점: 반복이 길수록 행동이 거칠어진다. 꼭대기에서 세우는 마지막 단계는 섬세한 조정이 필요해 4 이상은 균형 잡기를 어렵게 한다.
- 보상은 반복한 스텝들의 합으로 받으므로 한 결정의 보상 범위가 \([-33, 0]\) 정도다. 에피소드 리턴(200 스텝 보상 합)은 행동 반복과 관계없이 같은 척도로 비교할 수 있다.
하이퍼파라미터
| 이름 | 뜻 | 이 장의 값 | PlaNet 논문 |
| \(S\) | 무작위 시드 에피소드 | 5 | 5 |
| \(C\) | 수집 사이의 학습 횟수 | 100 | 100 |
| \(B \times L\) | 배치 (시퀀스 수 × 길이) | 50 × 50 | 50 × 50 |
| \(h\) / \(z\) 크기 | 결정·확률 상태 | 200 / 30 | 200 / 30 |
| 자유 내트 | KL 바닥값 | 3 | 3 |
| 학습률 / Adam ε | \(6\times10^{-4}\) / \(10^{-4}\) | \(10^{-3}\) / \(10^{-4}\) | |
| 기울기 자르기 | 노름 상한 | 100 | 1000 |
| \(H, I, J, K\) | CEM | 12, 10, 1000, 100 | 12, 10, 1000, 100 |
| 탐험 잡음 | 수집할 때 행동에 더함 | 0.3 | 0.3 |
| 행동 반복 | 2 | 과제마다 2 ~ 8 | |
| 보상 배율 | 학습용 보상 크기 | 0.1 | 없음 (보상이 이미 0 ~ 1) |
| 반복 횟수 | (학습 C 번 + 수집 1번) | 100 (에피소드 105개, 21,000 스텝) | 과제마다 다름 (수백 에피소드 이상) |
학습률과 기울기 자르기는 12장 Dreamer 와 같은 값을 쓰려고 Dreamer 논문 값으로 맞췄다. 그 밖에 Config 에는 hidden=200(작은 MLP 너비), depth=32(합성곱 채널 기본 단위), min_std=0.1, kl_scale=1.0, eval_every=10, eval_episodes=3 이 있다(region config).
구현 세부
리플레이 버퍼
-
preprocess는obs.float() / 255.0 - 0.5로 uint8 그림을 \([-0.5, 0.5]\) 로 옮긴다. - 에피소드를 통째로 저장하고, 뽑을 때는 무작위 에피소드의 무작위 시작점에서 길이 \(L\) 조각을 자른다. 에피소드 하나는 관측 101개(시작 + 결정 100번)이고 \(L = 50\) 이므로 시작점은 0 ~ 51 가운데 하나다.
- 조각이 에피소드 중간에서 시작해도 RSSM 은 \(h = 0\), \(z = 0\) 에서 출발한다. 처음 몇 스텝은 상태가 부정확하지만 그림을 보며 따라잡는다. 이것도 모델이 배울 일의 일부다.
- 그림은
uint8로 저장하고 배치를 만들 때만 실수로 바꾼다. 에피소드 105개 × 101장 × 4096바이트 ≈ 43MB 다. - 코드는
ch11_rssm_planet.py의 regionpreprocess,buffer에 있다.
합성곱 인코더와 디코더의 크기
인코더(region encoder)는 커널 4, 보폭 2 인 Conv2d 4층과 ReLU 로, 채널은 \(d, 2d, 4d, 8d\)(\(d = 32\))다. 덧대기 0 인 합성곱의 출력 크기는 다음과 같다(Convolution arithmetic).
\(n_{\text{out}} = \left\lfloor \frac{n_{\text{in}} - k}{s} \right\rfloor + 1\)
크기는 64 → 31 → 14 → 6 → 2 로 줄고(31 → 14 에서 \(\lfloor 13.5 \rfloor + 1\) 로 내림이 일어난다), 마지막을 펼치면 \(8d \times 2 \times 2 = 32d = 1024\) 개 숫자가 그림 특징 \(e_t\) 가 된다.
디코더(region decoder)는 특징 230개를 선형층으로 1024개로 바꿔 1×1 그림(채널 1024)으로 본 뒤 보폭 2 인 ConvTranspose2d 4층(채널 \(32d \to 4d \to 2d \to d \to 1\), 커널 5, 5, 6, 6)으로 키운다. 전치 합성곱의 출력 크기는 다음과 같다.
\(n_{\text{out}} = (n_{\text{in}} - 1)\, s + k\)
크기는 1 → 5 → 13 → 30 → 64 다. 커널 5, 5, 6, 6 은 64 에 정확히 맞추려고 고른 값이다(Dreamer 와 같다).
시간축 펼치기
- 배치 \(B = 50\), 길이 \(L = 50\) 의 그림 묶음은
(50, 50, 64, 64)다. 인코더와 디코더는 시간과 상관없으므로 앞의 두 축을 합쳐 2500장을 한꺼번에 처리한다(obs.reshape(-1, 1, 64, 64)). - RSSM 은 시간 순서대로 50번 돈다(
observe의for t in range(L)). 배치 축 50개는 동시에 계산한다. - 학습 한 스텝에서 시간이 가장 많이 드는 곳은 합성곱(인코더·디코더와 그 역전파)이고 순차 루프가 그다음이다.
-
observe는 시각별 결과를 리스트에 모은 뒤torch.stack(v, dim=1)로 시간 축에 쌓아(B, L, ·)로 돌려준다.
학습·수집 고리 (main)
region main 의 순서는 다음과 같다.
- 무작위 시드 에피소드
seed_episodes개를 버퍼에 넣고, 무작위 정책의 리턴을 잰다(random_baseline, 10 에피소드). - 반복마다
train_world_model로 \(C\) 번 학습한다. Adam(lr,eps)과clip_grad_norm_(grad_clip)을 쓴다. - 계획과 탐험 잡음으로 에피소드 하나를 모아 버퍼에 넣는다.
eval_every반복마다 잡음 없는 에피소드eval_episodes개의 평균을 찍는다. - 최종 평가: 처음 보는 시작 상태 10개(
seed + 123환경, 잡음 없이). - 그림 세 장(학습 곡선, 상상 vs 진짜, 계획한 에피소드)을 저장한다. 그림용 에피소드는 같은 시드의 평가 환경을 새로 만든 첫 에피소드다.
명령행 옵션은 --quick, --iterations, --batch-size, --fig-dir, --out, --seed 다. --quick 은 seed_episodes=2, iterations=2, train_steps=5, batch_size=8, seq_len=20, plan_candidates=100, plan_iters=3, plan_elites=10 을 쓴다.
실행 결과
본문 설정 그대로 노트북 GPU(8GB)에서 돌린 결과다. 같은 GPU 에서 12장 Dreamer 학습을 함께 돌렸으므로 혼자 돌리면 더 빠르다. return 은 탐험 잡음을 넣고 모은 에피소드의 리턴, eval 은 잡음 없이 계획만으로 행동한 에피소드 3개의 평균이다.
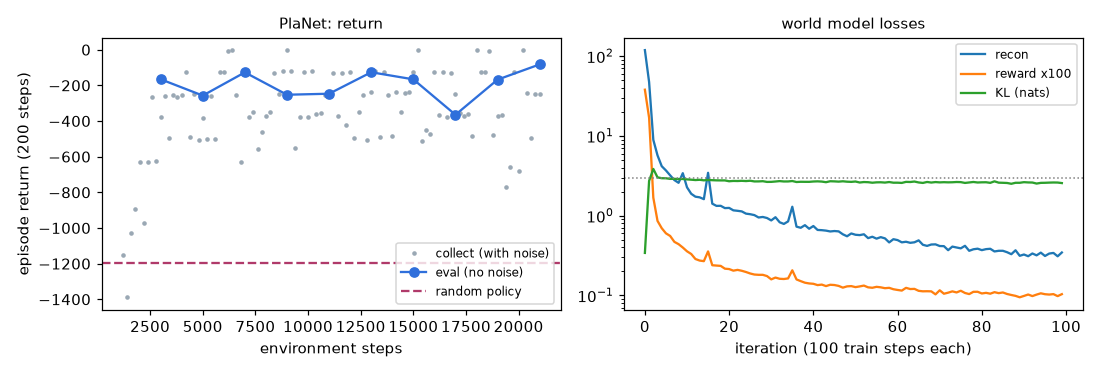
random policy return: -1194.5
it   1 | env steps   1200 | recon  118.81 reward 0.3792 kl  0.34 | return  -1151.9 | plan  99.1 ms/action |     46s
it   2 | env steps   1400 | recon   47.34 reward 0.1691 kl  2.73 | return  -1388.7 | plan  89.8 ms/action |     79s
it   3 | env steps   1600 | recon    8.92 reward 0.0168 kl  3.85 | return  -1027.6 | plan  74.9 ms/action |    110s
it   4 | env steps   1800 | recon    5.70 reward 0.0086 kl  3.02 | return   -894.7 | plan  87.6 ms/action |    139s
it   5 | env steps   2000 | recon    4.17 reward 0.0070 kl  2.95 | return   -628.2 | plan 114.5 ms/action |    182s
…
it  10 | env steps   3000 | recon    3.41 reward 0.0040 kl  2.88 | return   -375.8 | plan 144.9 ms/action |    477s | eval   -165.8
…
it  20 | env steps   5000 | recon    1.24 reward 0.0022 kl  2.77 | return   -383.5 | plan 101.9 ms/action |    962s | eval   -257.3
…
it  30 | env steps   7000 | recon    0.93 reward 0.0017 kl  2.65 | return   -123.5 | plan 149.7 ms/action |   1423s | eval   -127.0
…
it  60 | env steps  13000 | recon    0.51 reward 0.0012 kl  2.59 | return   -239.6 | plan  97.7 ms/action |   2810s | eval   -126.4
…
it 100 | env steps  21000 | recon    0.35 reward 0.0010 kl  2.56 | return   -245.8 | plan  94.1 ms/action |   4496s | eval    -82.4
done in 4535s, final test return -125.8
학습 곡선
- 그림: 에피소드 리턴과 World Model 손실 곡선 (그림 11-4)
- 적은 데이터로 배운다. 환경 스텝 3,000(에피소드 15개, 약 2분 반 분량의 경험)만에 평가 리턴이 −166 이 되었다. 무작위 행동은 −1194 다.
- 재구성 손실은 119 에서 0.35 로 줄었다. 처음 몇 회 만에 바탕을 배우고 그 뒤로 막대의 세부를 천천히 다듬는다.
- KL 은 처음 0.3 에서 곧바로 3 근처로 올라가 그 아래(2.6 안팎)에 머문다. 처음에 0 근처인 것은 사후가 아직 그림을 거의 쓰지 않아서이고, 재구성이 사후를 그림 쪽으로 당기면서 커진다. 3 아래에서는 자유 내트 때문에 기울기가 꺼지므로 "공짜 한도" 근처에서 맴돈다.
- 탐험 잡음을 넣은 에피소드는 0 에 가까운 값부터 −800 근처까지 넓게 흩어진다. 잡음 \(\mathcal{N}(0, 0.3^2)\) 은 토크로 ±0.6 정도라 꼭대기에서 균형을 잡다가 떨어뜨리기도 한다. 그 덕에 떨어지는 상황의 데이터도 모인다.
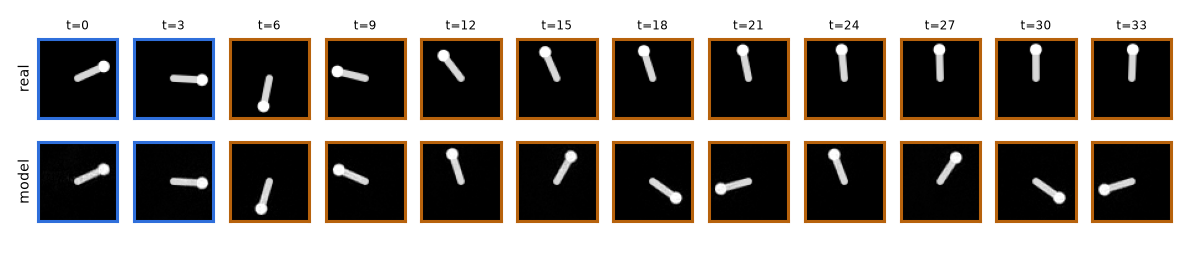
상상 vs 진짜
- 그림: 진짜 그림과 RSSM 이 상상한 그림 비교 (그림 11-5)
- t = 0 ~ 4 는 그림을 보며 사후로 상태를 추측해 디코더로 다시 그린 것이고, t = 5 부터는 그림을 전혀 보지 않고 실제로 한 행동만 넣어 사전으로 상상한 것이다(3 스텝마다 하나씩 표시).
- 다섯 장을 본 뒤 모델은 진자가 아래로 떨어졌다가 반동으로 올라오는 과정(t = 6 ~ 12)을 진짜와 거의 같게 상상한다. 그림 한 장에는 없는 속도를 다섯 장면에서 읽어 \(h_t\) 에 기억해 두었기 때문이다.
- t = 15 무렵부터 어긋난다. 진짜 진자는 꼭대기에 섰는데 상상 속 진자는 꼭대기를 지나쳐 넘어간다. 원인은 오차 누적(사전은 한 스텝 예측만 연습했다)과, 꼭대기가 작은 차이로 결과가 갈리는 불안정한 평형점이라는 점이다.
- 계획에 필요한 것은 12 스텝 앞까지이고 그 범위에서는 상상이 충분히 정확하다. MPC 는 매 순간 새 그림으로 믿음 상태를 고쳐 잡고 다시 계획하므로 먼 미래의 상상 오차가 쌓이지 않는다.
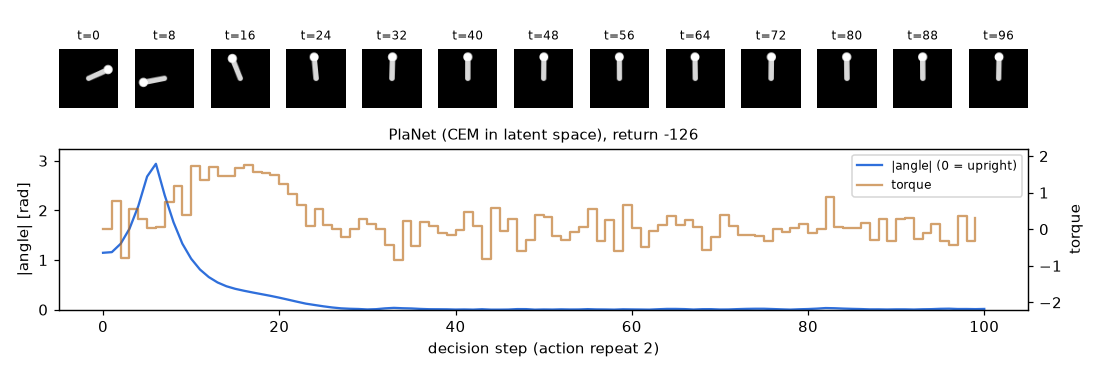
계획으로 진자 세우기
- 그림: PlaNet 이 계획으로 진자를 세우는 에피소드 (그림 11-6, 리턴 −126)
- 꼭대기에서 1.15 rad 쯤 기운 채 시작한다. PlaNet 은 곧장 밀어 올리지 않고 먼저 진자를 아래로 떨어뜨린다(결정 0 ~ 6 에서 \(\vert\theta\vert\) 가 3 rad 가까이 커진다). 토크가 약해 곧장 올릴 수 없으니 아래에서 반동을 모으는 것이다.
- 그다음 최대에 가까운 토크로 밀어 올리고(결정 8 ~ 18), 꼭대기에서는 작은 토크로 균형을 잡는다(결정 25 이후 \(\vert\theta\vert \approx 0\)).
- 이 "그네 타기" 전략은 누가 가르친 것이 아니라 상상 속 12 스텝 계획만으로 찾은 것이다.
성능과 시간
처음 보는 시작 상태 10개를 평가한 값이다(main 의 final eval over 10 episodes 줄). 출력 마지막 줄의 final test return 과 그림 11-5·11-6 은 같은 시드의 평가 환경을 새로 만들어 얻은 첫 에피소드다.
| 정책 | 평균 리턴 (10 에피소드) | 표준편차 | 최저 / 최고 |
| 무작위 행동 | −1194.5 | - | - |
| PlaNet (환경 스텝 21,000) | −196.8 | 113.7 | −376.2 / −0.5 |
리턴이 에피소드마다 크게 다른 것은 시작 위치 때문이다. 꼭대기 근처에서 시작하면 거의 0(−0.5)이고, 맨 아래에서 시작하면 올라가는 동안 각도 벌점을 받아 −250 ~ −380 이 된다. 평균 −150 ~ −200 이면 이 과제를 사실상 푼 것이다.
| 항목 | 값 |
| 전체 학습 시간 (노트북 GPU, 다른 학습과 함께) | 4,535초 ≈ 76분 |
| 계획 시간 (결정 한 번, GPU) | 평균 약 100 ms. 에피소드 하나(결정 100번)에 약 10초 |
| World Model 학습 한 스텝 (CPU 4스레드, \(B = 50\)) | 약 17초. 본문 설정(1만 스텝)은 CPU 로 사실상 불가능 |
| 같은 것, | 약 5초. 1만 스텝에 반나절 이상 |
| | 약 1분 (동작 확인용, 학습은 되지 않음) |
GPU 가 없으면 --quick 으로 코드가 끝까지 도는지 확인하고 실제 학습은 무료 클라우드 GPU(예: Google Colab)에서 돌린다. 올릴 파일은 wm_envs.py, ch11_rssm_planet.py, ch12_dreamer.py 세 개다.
자주 겪는 문제
| 증상 | 흔한 원인 | 해 볼 것 |
| 재구성 그림에 막대가 없고 검은 바탕만 나온다 | 막대가 그림의 일부라 초반에는 바탕만 맞춰도 손실이 크게 준다 | 더 오래 학습한다. 수천 스텝 뒤 막대가 나타난다. 그래도 안 되면 학습률을 낮춘다 |
| KL 이 0 근처로 떨어지고 상상이 엉망이다 | 사후 붕괴: 사후가 그림을 무시한다 | 자유 내트가 켜져 있는지 확인한다( |
| 상상(열린 고리)이 몇 스텝 만에 흐려진다 | 사전이 한 스텝 예측만 연습했다, 데이터 부족 | 데이터를 더 모은다. 잠재 과대 예측, 더 긴 \(L\) |
| 계획한 행동이 실제로는 엉뚱하다 | 보상 모델이 아직 부정확하거나 계획이 모델의 오류를 "이용" 한다 | 보상 손실을 확인한다. 탐험 잡음을 유지한다. 데이터가 쌓이면 줄어든다 |
| CPU 에서 너무 느리다 | 합성곱 2500장 × 역전파 | |
정리
- 그림만 보면 속도를 알 수 없어(부분 관측) 과거를 요약한 믿음 상태가 필요하다. 잠재 상태 공간 모델이 그것을 학습한다.
- RSSM 은 상태를 결정 상태 \(h_t\)(GRU, 기억)와 확률 상태 \(z_t\)(가우시안, 불확실성)로 나눈다. 부품은 GRU, 사전, 사후, 관측 디코더, 보상 디코더 다섯 개다.
- 학습 목표는 순차 ELBO = \(\sum_t\) (재구성 + 보상 − KL(사후 ‖ 사전))이다. 결합 분포의 인수분해, 젠센 부등식, 기댓값의 시간별 분리로 유도된다.
- KL 항은 사전(동역학)을 가르치는 유일한 통로다. 자유 내트는 KL 이 3 내트 아래면 기울기를 꺼서 사후 붕괴를 막는다.
- PlaNet 은 잠재 공간에서 CEM(\(H=12\), \(I=10\), \(J=1000\), \(K=100\))으로 계획하고 첫 행동만 실행한다(MPC). 결정 한 번에 RSSM 을 12만 스텝 굴리는 비싼 방법이며, 12장의 Dreamer 는 같은 RSSM 의 상상 속에서 정책 자체를 학습해 이 비용을 없앤다.
확인 문제
- 문제 1. RSSM 에서 \(h_t\) 를 빼고 확률 상태만 남기면, 반대로 \(z_t\) 를 빼면 어떤 문제가 생기는가.
- \(h_t\) 를 빼면(순수 확률 SSM) 모든 정보가 매 스텝 뽑기를 거쳐야 해서 여러 스텝 전의 정보를 정확히 전달하기 어렵다. \(z_t\) 를 빼면(결정적 RNN) 미래를 하나밖에 표현할 수 없어 여러 갈래의 미래를 평균 내 흐릿하게 예측하고, 잠재 변수가 없으니 ELBO 와 KL 로 학습할 수도 없다.
- 문제 2. 순차 ELBO 유도에서 부등호가 처음 나타나는 줄은 어디이고, 등호가 성립하려면 무엇이 필요한가.
- 젠센 부등식 \(\log \mathbb{E}[X] \ge \mathbb{E}[\log X]\) 를 쓴 줄이다. 차이는 \(D_{\mathrm{KL}}(q(z_{1:T} \mid o_{1:T}) \parallel p(z_{1:T} \mid o_{1:T}, r_{1:T}))\) 이므로 \(q\) 가 진짜 사후 분포와 같을 때 등호가 성립한다.
- 문제 3. 사전과 사후가 모두 \(\mathcal{N}(0.2,\ 0.5^2)\) 로 같다면 KL 과, 자유 내트 3 을 적용한 손실과 기울기는 얼마인가.
- \(\log(0.5/0.5) + (0.25 + 0)/(2 \cdot 0.25) - 0.5 = 0\) 이다. 자유 내트 손실은 \(\max(0, 3) = 3\) 이고 이 영역에서 기울기는 0 이다.
- 문제 4. CEM 의 후보를 \(J = 100\), 정예를 \(K = 10\) 으로 줄이면 결정 한 번에 RSSM 을 몇 스텝 굴리며, 무엇을 잃는가.
- \(10 \times 12 \times 100 = 12{,}000\) 스텝으로 10배 줄어든다. 한 반복에서 살펴보는 행동열이 적어 특히 처음 몇 반복에서 좋은 행동열을 찾을 확률이 낮아지고 계획의 질이 떨어질 수 있다(
--quick이 이 \(J\), \(K\) 를 쓰고 반복도 \(I = 3\) 으로 줄인다). - 문제 5.
reward_scale을 0.1 에서 1 로 바꾸면 CEM 이 고르는 행동이 달라지는가. - 보상 모델이 정확하다면 달라지지 않는다. CEM 은 보상 합의 순위로 정예를 고르고, 모든 보상에 같은 양수를 곱해도 순위는 그대로다. 다만 학습 중에는 보상 손실의 크기가 100배 커져 다른 손실과의 균형이 달라지므로 모델이 배우는 내용은 조금 달라질 수 있다.
See also
- World Models:Tutorial
- World Models
- World Models:Tutorial:08 VAE
- World Models:Tutorial:07 MPC 와 CEM
- World Models:Tutorial:12 Dreamer
- VAE
- GRU
- Recurrent neural network
- Markov decision process
- Reinforcement learning