WorldModels:Tutorial:12-Dreamer
lastmod 2026-11-18created 2026-11-172 edits
Dreamer: 상상 속에서 배우는 행동은 World Model 튜토리얼의 12장이다. 11장의 PlaNet 이 결정마다 World Model 안에서 12만 스텝을 상상하고 버리던 것을, Dreamer 는 같은 상상으로 액터(정책)와 크리틱(가치 함수)을 학습하는 데 쓴다. 상상 궤적, λ-리턴, 크리틱 손실, World Model 을 거슬러 미분하는 액터 학습, tanh-가우시안 정책의 엔트로피를 유도하고 그림만 보고 진자를 세우는 구현과 실측 결과를 정리한 뒤, DreamerV2 와 DreamerV3 의 기법을 다룬다.
- 원문: 12. Dreamer: 상상 속에서 배우는 행동
- 실습 코드:
code/ch12_dreamer.py(ch11_rssm_planet.py를 불러 쓴다. 노트북 GPU 혼자 약 45분,--quick은 CPU 약 15초) - 이전: 11. RSSM 과 PlaNet / 다음: 13. 현대 World Model 지형도
계획의 비용과 Dreamer 의 발상
PlaNet 의 계획에는 약점이 두 가지 있다.
- 비싸다. 결정 한 번에 RSSM 을 \(I \times H \times J = 10 \times 12 \times 1000 = 120{,}000\) 스텝 굴린다. 노트북 GPU 에서도 결정 한 번에 0.1초 안팎이 걸렸다. 그렇게 만든 상상은 행동 하나를 고른 뒤 버려지고, 다음 순간에는 처음부터 다시 상상한다.
- 근시안이다. 계획은 \(H = 12\) 스텝 안의 보상 합만 본다. 진자처럼 지금은 손해(아래로 내려가 반동을 모음)지만 나중에 큰 이득(위에 서기)인 문제에서 치명적일 수 있다.
5장의 두 도구가 각각의 해결책이다.
- 정책(액터) \(\pi_\psi(a \mid s)\): 상태를 넣으면 행동을 내놓는 신경망이다. 한 번 배워 두면 결정할 때 신경망을 한 번만 계산한다. 비용 문제를 푼다.
- 가치 함수(크리틱) \(v_\xi(s)\): 상태에서 앞으로 받을 보상의 합을 예측한다. 상상이 끝나는 지점의 가치를 더하면 지평선 너머까지 내다본다. 근시안 문제를 푼다.
정책과 가치 함수를 배우려면 보통 많은 양의 경험이 필요하다(모델 없는 강화학습). Dreamer 는 그 경험을 World Model 의 상상으로 만든다. 상상은 GPU 에서 수천 개를 동시에 굴릴 수 있고 실제 세상을 건드리지 않는다.
Dreamer 는 Hafner, Lillicrap, Ba, Norouzi 의 논문 Dream to Control: Learning Behaviors by Latent Imagination(ICLR 2020)에서 발표되었다. World Model 은 11장의 RSSM 을 그대로 쓰고 그 위에 상상 속 행동 학습을 얹는다.
세 고리
| 고리 | 하는 일 |
| ① 모델 학습 (11장과 같음) | 리플레이 버퍼 D 에서 B×L 조각을 뽑아 순차 ELBO 로 RSSM 을 학습한다. 사후 상태 B·L 개가 나온다. |
| ② 상상 속 행동 학습 (새로운 부분) | 사후 상태마다 액터로 H=15 스텝을 상상하고 λ-리턴을 계산한다. 크리틱은 λ-리턴에 맞추고, 액터는 모델을 거슬러 미분해 λ-리턴을 키운다. |
| ③ 환경과 상호작용 | 그림으로 믿음 상태를 갱신하고 액터로 행동한다(+ 잡음). 계획 없이 신경망 1번이다. 새 에피소드를 D 에 넣는다. |
C=100 번 학습마다 에피소드 1개를 수집한다. ③ 은 PlaNet 의 CEM 계획을 액터 신경망 한 번으로 바꾼 것이다.
상상 궤적 만들기
상상의 출발점은 ① 에서 World Model 을 학습하며 계산한 사후 상태를 그대로 쓴다. 배치가 \(B = 50\) 개 시퀀스 × 길이 \(L = 50\) 이므로 출발점이 2500개 생긴다.
- 실제로 겪은 장면을 그림까지 보고 추측한 상태라 출발점으로 가장 믿을 만하다.
- 버퍼 곳곳에서 뽑으므로 진자가 아래에 있을 때, 돌고 있을 때, 위에 있을 때가 고루 섞인다.
- 이미 계산해 둔 값이라 추가 비용이 없다.
출발점 \(s_0 = (h_0, z_0)\) 에서 \(H = 15\) 스텝을 상상한다. 상상 속 시각은 \(t = 0, 1, \dots, H\) 로 센다.
\(\begin{align} a_t &\sim \pi_\psi(a_t \mid s_t) \\ h_{t+1} &= f_\theta(h_t, z_t, a_t),\quad z_{t+1} \sim p_\theta(z_{t+1} \mid h_{t+1}) \\ \hat{r}_t &= R_\theta(h_{t+1}, z_{t+1}) \end{align}\)
액터가 행동을 고르고, RSSM 의 사전으로 그림 없이 한 스텝 가고, 도착한 상태에서 보상을 예측한다. 도착한 상태마다 크리틱이 가치 \(v\) 도 예측한다.
보상 첨자 주의. 11장의 보상 모델은 "상태 \(s_{t+1}\) 에 도착하며 받은 보상"을 \(s_{t+1}\) 에서 예측한다. 이 장은 그 값을 \(\hat{r}_t\) 라고 부른다. 즉 \(\hat{r}_t\) 는 \(s_t\) 에서 \(a_t\) 를 했을 때 받는 보상으로 5장의 \(r_t\) 와 같은 첨자이고, 5장의 리턴 공식을 그대로 쓸 수 있다. 논문마다 이 첨자 맞춤이 조금씩 다르므로 보상이 어느 상태에서 예측되는지 먼저 확인해야 한다.
    def imagine(self, h, z):
        """사후 상태 (N, ·) 에서 출발해 액터로 H 스텝을 상상한다. 상태 · 엔트로피 목록을 돌려준다."""
        feats, ents = [self.wm.feat(h, z)], []
        for _ in range(self.cfg.imag_horizon):
            a, ent = self.actor.sample(feats[-1].detach())  # 액터 입력에서는 기울기를 끊는다 (sg)
            h, z, _, _ = self.wm.rssm.img_step(h, z, a)  # z ~ p(z | h) 도 재매개변수화로 뽑는다
            feats.append(self.wm.feat(h, z))
            ents.append(ent)
        return torch.stack(feats), torch.stack(ents)  # (H+1, N, F), (H, N)
-
img_step은 11장의 함수다. 사전에서 \(z\) 를 뽑을 때도 재매개변수화를 쓰므로 상상 궤적 전체가 미분 가능한 계산이다. -
feats의 모양은(H+1, N, 230)이다. \(N = 2500\) 개 궤적의 \(s_0, \dots, s_H\) 다.
가치 추정: n-스텝 리턴에서 λ-리턴까지
5장의 할인된 리턴은 다음과 같다.
\(G_t = \hat{r}_t + \gamma\,\hat{r}_{t+1} + \gamma^2\,\hat{r}_{t+2} + \cdots = \sum_{k=0}^{\infty} \gamma^k\,\hat{r}_{t+k}\)
상상은 \(H = 15\) 스텝에서 끝나므로 끝나는 지점 이후는 크리틱의 예측으로 대신한다. 가치 함수의 정의 \(v(s) = \mathbb{E}[G \mid s]\) 에서 자연스럽게 나오는 처리다.
n-스텝 리턴
보상을 상상 속에서 \(n\) 스텝 더하고 그 뒤를 크리틱으로 마무리한 값이 n-스텝 리턴(n-step return)이다.
\(V^{(n)}_t = \sum_{k=0}^{n-1} \gamma^k\,\hat{r}_{t+k} + \gamma^n\, v(s_{t+n})\)
\(\begin{align} V^{(1)}_t &= \hat{r}_t + \gamma\, v(s_{t+1}) \\ V^{(2)}_t &= \hat{r}_t + \gamma\,\hat{r}_{t+1} + \gamma^2\, v(s_{t+2}) \\ V^{(3)}_t &= \hat{r}_t + \gamma\,\hat{r}_{t+1} + \gamma^2\,\hat{r}_{t+2} + \gamma^3\, v(s_{t+3}) \end{align}\)
\(n = 1\) 은 벨만 방정식의 오른쪽이다(TD 목표). \(n\) 의 선택에는 편향과 분산의 줄다리기가 있다.
| 작은 \(n\) (예: 1) | 큰 \(n\) (예: 15) | |
| 크리틱에 기대는 정도 | 크다. 크리틱이 틀리면 그대로 틀린다(편향). | 작다. 크리틱의 비중이 \(\gamma^{n}\) 으로 줄어든다. |
| 상상(모델)에 기대는 정도 | 작다. 한 스텝만 상상한다. | 크다. 긴 상상의 오차와 무작위성이 쌓인다(분산). |
| 학습 초반 | 크리틱이 엉망이라 나쁘다. | 보상 신호를 빨리 전달해 좋다. |
λ-리턴의 정의
λ-리턴(λ-return)은 n-스텝 리턴을 \(\lambda\) 의 거듭제곱 가중치로 섞은 평균이다. 시각 \(t\) 에서 상상 끝까지 남은 스텝 수를 \(N = H - t\) 라 하면(이 절에서 \(N\) 은 궤적 개수가 아니라 남은 스텝 수다),
\(V^\lambda_t = (1 - \lambda)\sum_{n=1}^{N-1} \lambda^{n-1}\, V^{(n)}_t + \lambda^{N-1}\, V^{(N)}_t,\qquad \lambda \in [0, 1]\)
앞의 리턴들은 \((1-\lambda), (1-\lambda)\lambda, (1-\lambda)\lambda^2, \dots\) 의 가중치를 받고 가장 긴 \(N\)-스텝 리턴이 남은 가중치 \(\lambda^{N-1}\) 을 모두 받는다. 등비수열의 합 \(\sum_{n=1}^{N-1}\lambda^{n-1} = \frac{1 - \lambda^{N-1}}{1 - \lambda}\) 을 쓰면 가중치의 합은 1 이다.
\((1-\lambda)\cdot\frac{1 - \lambda^{N-1}}{1 - \lambda} + \lambda^{N-1} = 1 - \lambda^{N-1} + \lambda^{N-1} = 1\)
따라서 λ-리턴은 n-스텝 리턴들의 가중 평균이다.
- \(\lambda = 0\): \(V^\lambda_t = V^{(1)}_t\). 크리틱에 가장 많이 기댄다.
- \(\lambda = 1\): \(V^\lambda_t = V^{(N)}_t\). 상상을 끝까지 쓴다.
- Dreamer 는 \(\lambda = 0.95\) 를 쓴다. \(N = 15\) 이면 가장 긴 리턴의 가중치가 \(0.95^{14} \approx 0.488\) 로, 거의 절반이 "15 스텝 상상 + 끝의 가치"에 실린다.
정의에서 재귀식으로
정의대로 계산하면 시각마다 n-스텝 리턴을 \(N\) 개씩 만들어야 한다. 뒤에서부터 한 번에 계산하는 재귀식을 유도한다. 먼저 n-스텝 리턴의 재귀 성질이 필요하다. 정의의 합에서 \(k=0\) 항을 꺼내고 \(\gamma\) 를 묶은 뒤 첨자를 \(j = k - 1\) 로 바꾼다.
\(\begin{align} V^{(n)}_t &= \hat{r}_t + \sum_{k=1}^{n-1}\gamma^k\,\hat{r}_{t+k} + \gamma^n\, v(s_{t+n}) \\ &= \hat{r}_t + \gamma\left[\sum_{j=0}^{n-2}\gamma^{j}\,\hat{r}_{t+1+j} + \gamma^{n-1}\, v(s_{t+1+(n-1)})\right] \\ &= \hat{r}_t + \gamma\, V^{(n-1)}_{t+1},\qquad V^{(0)}_{t+1} := v(s_{t+1}) \end{align}\)
대괄호 안은 시각 \(t+1\) 에서 출발한 \((n-1)\)-스텝 리턴의 정의다. "0-스텝 리턴"을 크리틱 값으로 정의하면 \(n = 1\) 일 때도 맞는다.
이 성질을 λ-리턴의 정의(\(N \ge 2\))에 넣는다.
\(\begin{align} V^\lambda_t &= (1 - \lambda)\sum_{n=1}^{N-1} \lambda^{n-1}\big[\hat{r}_t + \gamma V^{(n-1)}_{t+1}\big] + \lambda^{N-1}\big[\hat{r}_t + \gamma V^{(N-1)}_{t+1}\big] \\ &= \hat{r}_t\underbrace{\left[(1-\lambda)\sum_{n=1}^{N-1}\lambda^{n-1} + \lambda^{N-1}\right]}_{=\,1} + \gamma\left[(1-\lambda)\sum_{n=1}^{N-1}\lambda^{n-1} V^{(n-1)}_{t+1} + \lambda^{N-1} V^{(N-1)}_{t+1}\right] \\ &= \hat{r}_t + \gamma\left[(1-\lambda)\, V^{(0)}_{t+1} + (1-\lambda)\sum_{n=2}^{N-1}\lambda^{n-1} V^{(n-1)}_{t+1} + \lambda^{N-1} V^{(N-1)}_{t+1}\right] \\ &= \hat{r}_t + \gamma\left[(1-\lambda)\, v(s_{t+1}) + \lambda\left\{(1-\lambda)\sum_{m=1}^{N-2}\lambda^{m-1} V^{(m)}_{t+1} + \lambda^{N-2} V^{(N-1)}_{t+1}\right\}\right] \\ &= \hat{r}_t + \gamma\Big[(1-\lambda)\, v(s_{t+1}) + \lambda\, V^\lambda_{t+1}\Big] \end{align}\)
각 줄의 근거는 다음과 같다.
- \(\hat{r}_t\) 가 붙은 항끼리, \(\gamma\) 가 붙은 항끼리 모은다. \(\hat{r}_t\) 의 계수는 가중치의 합 1 이다.
- 합에서 \(n = 1\) 항 \((1-\lambda)\lambda^{0} V^{(0)}_{t+1}\) 을 꺼낸다.
- \(V^{(0)}_{t+1} = v(s_{t+1})\) 로 바꾸고, 나머지 두 항에서 \(\lambda\) 하나를 묶어 첨자를 \(m = n - 1\) 로 바꾼다.
- 시각 \(t+1\) 에서는 남은 스텝 수가 \(N - 1\) 이므로 중괄호 안은 정의에서 \(N\) 을 \(N-1\) 로 바꾼 것, 즉 \(V^\lambda_{t+1}\) 이다.
끝 조건은 \(V^\lambda_H := v(s_H)\) 다. \(t = H - 1\)(\(N = 1\))에서 정의는 \(V^\lambda_{H-1} = \hat{r}_{H-1} + \gamma v(s_H)\) 이고, 재귀식에 끝 조건을 넣어도 \(\hat{r}_{H-1} + \gamma[(1-\lambda)v(s_H) + \lambda v(s_H)]\) 로 같다.
핵심: λ-리턴의 재귀식
\(V^\lambda_t = \hat{r}_t + \gamma\Big[(1-\lambda)\, v(s_{t+1}) + \lambda\, V^\lambda_{t+1}\Big],\qquad V^\lambda_H = v(s_H)\)
"지금 보상 + 할인된 [다음 상태의 크리틱 값과 다음 상태의 λ-리턴을 \((1-\lambda) : \lambda\) 로 섞은 값]"으로 읽는다. \(\lambda = 0\) 이면 한 스텝 목표 \(\hat{r}_t + \gamma v(s_{t+1})\), \(\lambda = 1\) 이면 5장의 리턴 재귀식 \(\hat{r}_t + \gamma V_{t+1}\) 이 된다.
숫자 확인
\(H = 3\), \(\gamma = 0.9\), \(\lambda = 0.5\), 보상 \(\hat{r}_0 = 1,\ \hat{r}_1 = 0,\ \hat{r}_2 = 2\), 크리틱 값 \(v(s_1) = 4,\ v(s_2) = 3,\ v(s_3) = 5\) 로 둔다.
재귀식(뒤에서부터):
\(\begin{align} V^\lambda_3 &= 5 \\ V^\lambda_2 &= 2 + 0.9\,[0.5 \cdot 5 + 0.5 \cdot 5] = 6.5 \\ V^\lambda_1 &= 0 + 0.9\,[0.5 \cdot 3 + 0.5 \cdot 6.5] = 0.9 \cdot 4.75 = 4.275 \\ V^\lambda_0 &= 1 + 0.9\,[0.5 \cdot 4 + 0.5 \cdot 4.275] = 1 + 0.9 \cdot 4.1375 = 4.72375 \end{align}\)
정의(\(t = 0\), \(N = 3\), 가중치 0.5, 0.25, 0.25):
\(\begin{align} V^{(1)}_0 &= 1 + 0.9 \cdot 4 = 4.6 \\ V^{(2)}_0 &= 1 + 0.9 \cdot 0 + 0.81 \cdot 3 = 3.43 \\ V^{(3)}_0 &= 1 + 0 + 0.81 \cdot 2 + 0.729 \cdot 5 = 6.265 \\ V^\lambda_0 &= 0.5 \cdot 4.6 + 0.25 \cdot 3.43 + 0.25 \cdot 6.265 = 2.3 + 0.8575 + 1.56625 = 4.72375 \end{align}\)
두 값이 같다. 코드는 재귀식으로 계산하고, 정의대로 계산하는 함수를 함께 두어 실행할 때마다 둘을 비교한다.
def lambda_return(rewards, values, gamma, lam):
    """λ-리턴을 뒤에서부터 재귀식으로 계산한다.

    rewards : (H, N)    r̂_0 … r̂_{H-1}   (r̂_t = 상태 s_{t+1} 에서 예측한, 전이 t 의 보상)
    values  : (H+1, N)  v(s_0) … v(s_H)
    반환    : (H, N)    V^λ_0 … V^λ_{H-1}
      V^λ_t = r̂_t + γ [ (1-λ) v(s_{t+1}) + λ V^λ_{t+1} ],   V^λ_H = v(s_H)
    """
    H = rewards.shape[0]
    g = values[H]  # V^λ_H = v(s_H)
    out = []
    for t in reversed(range(H)):
        g = rewards[t] + gamma * ((1 - lam) * values[t + 1] + lam * g)
        out.append(g)
    return torch.stack(out[::-1])
정의대로 계산하는 함수는 ch12_dreamer.py 의 lambda-check 구간(lambda_return_by_definition)에 있다. 실행하면 두 결과의 최대 차이를 출력한다.
무작위 보상과 가치에서 두 계산의 차이가 \(10^{-7}\) 수준(32비트 실수의 반올림 오차)이다.
크리틱 학습
크리틱 \(v_\xi(s)\) 는 상상 속 상태 \(s_t\) 의 λ-리턴을 예측하도록 배운다. λ-리턴은 크리틱 자신의 값으로 만든 부트스트랩 목표이므로 목표 쪽으로는 기울기를 차단한다.
\(\mathcal{L}(\xi) = \mathbb{E}\left[\sum_{t=0}^{H-1} \frac{1}{2}\Big(v_\xi(s_t) - \operatorname{sg}\big(V^\lambda_t\big)\Big)^2\right]\)
\(\operatorname{sg}(\cdot)\) 는 기울기 차단(stop-gradient)으로, 값은 그대로 쓰되 미분할 때는 상수로 본다. PyTorch 의 .detach() 다. \(\frac{\partial}{\partial \xi}\operatorname{sg}(V^\lambda_t) = 0\) 이므로 기울기는 다음과 같다.
\(\frac{\partial}{\partial \xi}\,\frac{1}{2}\big(v_\xi(s_t) - \operatorname{sg}(V^\lambda_t)\big)^2 = \big(v_\xi(s_t) - V^\lambda_t\big)\cdot\frac{\partial v_\xi(s_t)}{\partial \xi}\)
예측이 목표보다 크면 줄이고 작으면 키우는 단순한 회귀다. 차단하지 않으면 \(V^\lambda_t\) 안의 \(v_\xi(s_{t+1})\) 로도 기울기가 흘러, 크리틱이 목표를 자기 쪽으로 끌어당겨 손실을 줄이는 길이 생긴다.
안정 장치 두 가지를 더 쓴다.
- 느린 크리틱(목표 크리틱): λ-리턴을 계산할 때 쓰는 \(v\) 는 학습 중인 크리틱이 아니라 100번 학습마다 한 번씩 복사해 두는 사본이다. 목표가 매 스텝 흔들리지 않게 한다. DreamerV2 부터 쓰였고 DreamerV1 원본에는 없다. 5장의 DQN 목표 신경망과 같은 생각이다.
- 입력 차단: 크리틱에 넣는 상태도
feats[:-1].detach()로 끊어 크리틱 손실이 World Model 이나 액터를 건드리지 않게 한다.
액터 학습: World Model 을 거슬러 미분하기
액터의 목표는 상상 속 λ-리턴을 키우는 것이다. 부호를 뒤집어 손실로 만들고 탐험용 엔트로피 보너스를 더한다.
\(\max_\psi\ \mathbb{E}\left[\sum_{t=0}^{H-1} V^\lambda_t\right] \quad\Longrightarrow\quad \mathcal{L}(\psi) = -\,\mathbb{E}\left[\sum_{t=0}^{H-1} V^\lambda_t\right] - \eta\,\mathbb{E}\left[\sum_{t=0}^{H-1}\mathcal{H}\big[\pi_\psi(\cdot \mid s_t)\big]\right]\)
\(\mathcal{H}\) 는 정책의 엔트로피이고, 이 장에서 \(\eta\) 는 학습률이 아니라 Dreamer 논문을 따라 엔트로피 계수를 뜻한다.
REINFORCE 와 재매개변수화 경사
5장의 정책 경사 정리(로그 미분 기법)는 다음과 같다.
\(\nabla_\psi\, \mathbb{E}_{a \sim \pi_\psi}[R(a)] = \mathbb{E}_{a \sim \pi_\psi}\big[R(a)\,\nabla_\psi \log \pi_\psi(a \mid s)\big]\)
이 식은 리턴 \(R\) 의 값만 쓰고 \(R\) 이 행동에 따라 어떻게 변하는지(미분)는 쓰지 않는다. 미분할 수 없는 실제 환경에서도 쓸 수 있는 대신 추정의 분산이 크고 표본이 많이 필요하다.
상상 세계는 신경망이다. GRU, 사전 MLP, 보상 모델, 크리틱 모두 미분할 수 있고 뽑기도 재매개변수화로 했다. 행동도 재매개변수화로 뽑는다.
\(a_t = \tanh\big(\mu_\psi(s_t) + \sigma_\psi(s_t)\,\epsilon_t\big),\qquad \epsilon_t \sim \mathcal{N}(0, 1)\)
그러면 λ-리턴은 \(\psi\) 의 미분 가능한 함수가 된다. \(\psi\) → 행동 \(a_t\) → 다음 상태 \(s_{t+1}\) → 보상 \(\hat{r}_t\) 와 가치 \(v(s_{t+1})\) → λ-리턴으로 이어지는 계산 그래프를 역전파로 거슬러 올라가면 기울기가 나온다. "World Model 을 거슬러 미분한다(backpropagate through the dynamics)"는 말의 뜻이다.
한 스텝 장난감 예. \(s_1 = s_0 + a_0\), \(\hat{r}_0 = -s_1^2\), \(v(s) = -2s^2\), \(a_0 = \mu\)(잡음 없음)로 둔다. \(H = 1\) 이면 λ-리턴은 \(V^{(1)}_0\) 하나다.
\(\begin{align} V^\lambda_0 &= \hat{r}_0 + \gamma\, v(s_1) = -s_1^2 - 2\gamma s_1^2 \\ \frac{dV^\lambda_0}{d\mu} &= \frac{\partial V^\lambda_0}{\partial s_1}\cdot\frac{\partial s_1}{\partial a_0}\cdot\frac{\partial a_0}{\partial \mu} = (-2s_1 - 4\gamma s_1)\cdot 1 \cdot 1 \end{align}\)
보상 모델과 크리틱의 상태 미분 × 동역학의 행동 미분 × 정책의 매개변수 미분이다. \(s_0 = 1,\ \mu = 0.2,\ \gamma = 0.9\) 이면 \(s_1 = 1.2\), 기울기는 \(-2.4 - 4.32 = -6.72\) 다. 음수이므로 리턴을 키우려면 \(\mu\) 를 줄여야 한다. 수치 확인: \(\mu = 0.21\) 이면 \(V^\lambda_0 = -1.4641 - 2.6354 = -4.0995\) 로 \(\mu = 0.2\) 의 \(-4.032\) 보다 나쁘고, 변화율 \((-4.0995 + 4.032)/0.01 \approx -6.75\) 가 미분값과 거의 같다. 한 번의 계산이 "어느 쪽으로 얼마나" 고칠지를 알려 준다. REINFORCE 라면 여러 행동을 시도해 점수를 비교해야 얻는 정보다.
핵심. 실제 세상(진자의 물리)은 미분할 수 없는 블랙박스지만 World Model 은 처음부터 끝까지 미분 가능한 신경망이다. 그래서 Dreamer 는 "행동을 이만큼 바꾸면 미래 리턴이 이만큼 바뀐다"는 해석적 기울기를 얻는다. 대가로, 모델이 틀린 곳에서는 기울기도 틀리므로 액터가 모델의 오류를 이용할 수 있다. 실제 데이터를 계속 모아 모델을 고쳐야 하는 이유다.
무엇이 고쳐지고 무엇이 멈추는가
액터 손실의 기울기는 상상 궤적 전체를 거슬러 흐르지만 고쳐지는 것은 액터의 매개변수 \(\psi\) 뿐이어야 한다.
| 위치 | 처리 | 이유 |
| 상상의 출발점 \(s_0\) | | 출발점은 데이터로 정해진 상수다. 액터 손실이 World Model 학습(사후)을 건드리지 않게 한다. |
| World Model 매개변수 \(\theta\) | | 모델은 데이터로만 배운다는 원칙이다. 액터 옵티마이저에는 액터 매개변수만 있어 얼리지 않아도 모델이 바뀌지는 않지만, 얼려 두면 모델 매개변수 쪽 기울기를 계산하지 않아 빠르고 액터 손실의 기울기가 모델의 |
| 느린 크리틱 매개변수 | | \(v(s_{t+1})\) 을 거쳐 상태 쪽으로는 기울기가 흘러야 하지만 크리틱 자체는 바뀌면 안 된다. |
| 액터의 입력 상태 | | DreamerV1 공개 코드와 같은 처리다(논문 식에는 드러나지 않는 구현상의 선택). "행동 \(a_t\) → 다음 상태들 → 보상과 가치" 길의 기울기만 남고, \(a_t\) 가 \(s_{t+1}\) 을 바꿔 다음 행동 \(a_{t+1} = \pi_\psi(s_{t+1})\) 까지 바꾸는 길(\(\partial a_{t+1}/\partial s_{t+1}\))은 무시된다. 엄밀한 전미분에서 이 항을 뺀 근사다. |
| 크리틱의 목표 \(V^\lambda_t\) | | 부트스트랩 목표는 상수다. |
| 크리틱의 입력 상태 | | 크리틱 손실이 상상 궤적(액터와 모델)을 건드리지 않게 한다. |
얼리기와 끊기의 차이. requires_grad_(False) 는 그 매개변수로 가는 기울기를 계산하지 않을 뿐, 그 층을 지나 입력 쪽으로 흐르는 기울기는 막지 않는다. .detach() 는 그 텐서에서 계산 그래프를 잘라 그 너머로 기울기가 전혀 흐르지 않는다. 액터 학습에서는 World Model 을 얼려야 하고 끊으면 안 된다. 끊으면 행동이 미래에 주는 영향이 보이지 않는다.
tanh-가우시안 정책
진자의 행동(토크)은 \([-2, 2]\) 범위다. \([-1, 1]\) 로 정규화해 다루고 환경에 줄 때 2 를 곱한다. 가우시안에서 뽑은 값 \(u\) 를 \(\tanh\) 로 눌러 \((-1, 1)\) 안에 넣는다.
class Actor(nn.Module):
    """tanh-가우시안 정책: u ~ N(μ, σ²), a = tanh(u) ∈ (-1, 1)."""

    def __init__(self, feat_dim, act_dim=1, hidden=300, layers=3, init_std=1.0, min_std=1e-4):
        super().__init__()
        self.net = mlp(feat_dim, hidden, 2 * act_dim, layers)
        self.raw_init_std = math.log(math.exp(init_std) - 1)  # softplus(raw) = init_std 가 되는 raw
        self.min_std = min_std

    def forward(self, feat):
        mean, std = self.net(feat).chunk(2, -1)
        mean = 5 * torch.tanh(mean / 5)  # 평균이 너무 커져 tanh 가 포화되지 않게 [-5, 5] 로 부드럽게 묶는다
        std = F.softplus(std + self.raw_init_std) + self.min_std
        return mean, std

    def sample(self, feat):
        """재매개변수화로 행동을 뽑고, 그 행동의 엔트로피 추정값도 함께 돌려준다."""
        mean, std = self(feat)
        eps = torch.randn_like(mean)
        u = mean + std * eps  # 기울기가 mean · std 로 흐른다
        a = torch.tanh(u)
        # H[a] = H[u] + E[log |da/du|],  log |da/du| = log(1 - tanh²(u))
        gauss_ent = (0.5 * math.log(2 * math.pi * math.e) + torch.log(std)).sum(-1)
        log_det = torch.log(1 - a.pow(2) + 1e-6).sum(-1)
        return a, gauss_ent + log_det

    def mode(self, feat):
        mean, _ = self(feat)
        return torch.tanh(mean)
-
mean = 5 * torch.tanh(mean / 5): 평균을 \([-5, 5]\) 로 부드럽게 묶는다. \(\tanh(5) \approx 0.9999\) 라 그 이상은 의미가 없고, 너무 크면 \(\tanh\) 가 포화되어 기울기가 사라진다(DreamerV1 의 방법). -
F.softplus(std + self.raw_init_std): 처음 출력이 0 근처일 때 표준편차가init_std(=1)가 되도록 softplus 의 역함수 값 \(\log(e^1 - 1) \approx 0.541\) 을 더해 둔다. -
mode()는 평가할 때 쓰는 결정적 행동 \(\tanh(\mu)\) 다.
엔트로피 보너스와 변수 바꾸기
액터가 일찍 한 가지 행동만 고집하면 새로운 것을 시도하지 않는다. 손실에서 \(\eta\,\mathcal{H}\) 를 빼면(엔트로피를 키우면) 탐험이 유지된다. \(a = \tanh(u)\) 로 바꾼 분포의 엔트로피는 변수 바꾸기 공식으로 구한다. \(p_a(a)\,\vert da\vert = p_u(u)\,\vert du\vert\) 에서 출발한다(\(\tanh\) 는 증가 함수라 일대일 대응).
\(\begin{align} p_a(a) &= \frac{p_u(u)}{\left\vert \frac{da}{du} \right\vert} \\ -\log p_a(a) &= -\log p_u(u) + \log\left\vert \frac{da}{du} \right\vert \\ \mathcal{H}[a] &= \mathbb{E}[-\log p_a(a)] = \mathcal{H}[u] + \mathbb{E}\left[\log\left\vert \frac{da}{du} \right\vert\right] \end{align}\)
\(\frac{d}{du}\tanh(u) = 1 - \tanh^2(u) = 1 - a^2\) 는 늘 0 과 1 사이라 로그가 0 이하다. \(\tanh\) 로 누르면 값이 \((-1, 1)\) 안으로 압축되어 엔트로피가 줄어든다. 가우시안의 엔트로피는 \(\mathbb{E}[(u-\mu)^2] = \sigma^2\) 을 써서 다음과 같다.
\(\mathcal{H}[u] = \mathbb{E}\left[\frac{1}{2}\log(2\pi\sigma^2) + \frac{(u-\mu)^2}{2\sigma^2}\right] = \frac{1}{2}\log(2\pi\sigma^2) + \frac{1}{2} = \frac{1}{2}\log(2\pi e\,\sigma^2)\)
두 번째 기댓값은 방금 뽑은 행동 하나로 어림한다(몬테카를로).
\(\mathcal{H}[a] \approx \sum_{\text{dim}}\left[\frac{1}{2}\log(2\pi e) + \log\sigma\right] + \sum_{\text{dim}}\log\big(1 - a^2\big)\)
코드의 gauss_ent + log_det 이다(\(10^{-6}\) 은 \(\log 0\) 을 막는 작은 수). \(\sigma = 1\) 이면 첫 부분은 \(\frac{1}{2}\log(2\pi e) \approx 1.419\) 다. 연속 분포의 엔트로피(미분 엔트로피)는 음수가 될 수 있으므로 학습 로그의 ent 가 음수인 것은 정상이다.
계수 \(\eta\) 는 \(10^{-4}\) 로 작게 둔다. DreamerV1 원본은 엔트로피 보너스 없이 수집할 때 행동에 잡음 \(\mathcal{N}(0, 0.3^2)\) 을 더해 탐험했고 이후 버전은 엔트로피 보너스를 쓴다. 이 구현은 둘 다 쓴다.
전체 알고리즘
데이터 D ← 무작위 행동 에피소드 S 개
되풀이:
    C 번 되풀이:
        # ① 모델 학습 (11장)
        D 에서 B×L 조각 → 순차 ELBO 로 θ, φ 한 스텝 → 사후 상태 {(h, z)} B·L 개
        # ② 상상 속 행동 학습
        출발점 s_0 ← 사후 상태들 (기울기 차단)
        t = 0..H-1:  a_t ~ π_ψ(·|sg(s_t)),  s_{t+1} ← RSSM 사전(s_t, a_t),  r̂_t ← R(s_{t+1})
        V^λ_t ← 뒤에서부터 재귀식 (느린 크리틱 v 사용)
        액터:   ψ ← ψ − α_ψ ∇_ψ [ −mean(V^λ) − η·mean(H[π]) ]   (World Model 을 거슬러 역전파)
        크리틱: ξ ← ξ − α_ξ ∇_ξ mean( ½ (v_ξ(sg(s_t)) − sg(V^λ_t))² )
        100 번마다 느린 크리틱 ← 크리틱
    # ③ 환경과 상호작용
    에피소드 하나: 매 결정마다 그림으로 (h, z) 갱신 → a ~ π_ψ + 잡음 N(0, 0.3²) → 실행
    D 에 추가
    def train_step(self, batch):
        cfg = self.cfg
        # ① World Model: 11장과 똑같이 순차 ELBO 로 한 스텝
        wm_loss, metrics, states = self.wm.loss(batch)
        self.wm_opt.zero_grad(set_to_none=True)
        wm_loss.backward()
        nn.utils.clip_grad_norm_(self.wm.parameters(), cfg.grad_clip)
        self.wm_opt.step()

        # ② 상상: 배치의 모든 사후 상태 (B·L 개) 에서 출발. 출발점은 상수로 본다 (detach).
        h = states["h"].detach().reshape(-1, cfg.deter)
        z = states["z"].detach().reshape(-1, cfg.stoch)
        self.wm.requires_grad_(False)  # 액터 손실이 World Model 을 고치지 않게 얼린다 (기울기는 통과)
        feats, ents = self.imagine(h, z)
        rewards = self.wm.reward(feats[1:]).squeeze(-1)  # (H, N): r̂_t = R(s_{t+1})
        values = self.slow_critic(feats).squeeze(-1)  # (H+1, N): v(s_0..s_H)
        returns = lambda_return(rewards, values, cfg.gamma, cfg.lam)  # (H, N)
        self.wm.requires_grad_(True)

        # ③ 액터: λ-리턴을 키우는 쪽으로 (동역학을 거슬러 역전파) + 엔트로피 보너스
        if cfg.return_norm:  # DreamerV3: 리턴의 5–95 백분위 폭으로 나눈다 (1 보다 작으면 1)
            with torch.no_grad():
                q = torch.quantile(returns.flatten(), torch.tensor([0.05, 0.95], device=returns.device))
                self.ret_scale = 0.99 * self.ret_scale + 0.01 * (q[1] - q[0]).item()
            actor_obj = returns / max(1.0, self.ret_scale)
        else:
            actor_obj = returns
        actor_loss = -actor_obj.mean() - cfg.entropy_scale * ents.mean()
        self.actor_opt.zero_grad(set_to_none=True)
        actor_loss.backward()
        nn.utils.clip_grad_norm_(self.actor.parameters(), cfg.grad_clip)
        self.actor_opt.step()

        # ④ 크리틱: v(s_t) 를 λ-리턴(상수로 본다)에 맞춘다
        v = self.critic(feats[:-1].detach()).squeeze(-1)  # (H, N)
        critic_loss = 0.5 * ((v - returns.detach()) ** 2).mean()
        self.critic_opt.zero_grad(set_to_none=True)
        critic_loss.backward()
        nn.utils.clip_grad_norm_(self.critic.parameters(), cfg.grad_clip)
        self.critic_opt.step()

        # ⑤ 느린 크리틱: 일정 횟수마다 지금 크리틱을 복사 (목표값을 흔들리지 않게)
        self.steps += 1
        if self.steps % cfg.slow_critic_every == 0:
            self.slow_critic.load_state_dict(self.critic.state_dict())

        metrics.update(actor=actor_loss.item(), critic=critic_loss.item(),
                       imag_return=returns.mean().item(), entropy=ents.mean().item())
        return metrics
한 번의 train_step 안에서 옵티마이저 세 개(World Model, 액터, 크리틱)가 각자의 손실로 한 스텝씩 움직인다. self.wm.requires_grad_(False) 와 (True) 사이가 World Model 을 얼린 채 상상하는 구간이다. 수집과 평가 루프는 ch12_dreamer.py 의 main 구간에 있다(수집은 actor.sample, 평가는 actor.mode).
하이퍼파라미터
@dataclass
class DreamerConfig(Config):
    # 11장의 Config(모델 크기 · 배치 · 자유 내트 등)를 물려받고, 행동 학습에 필요한 값만 더한다.
    imag_horizon: int = 15  # H: 상상 길이
    gamma: float = 0.99  # γ: 할인율
    lam: float = 0.95  # λ: λ-리턴의 섞는 비율
    actor_lr: float = 8e-5
    critic_lr: float = 8e-5
    ac_hidden: int = 300  # 액터 · 크리틱 MLP 너비
    ac_layers: int = 3
    entropy_scale: float = 1e-4  # η: 엔트로피 보너스
    init_std: float = 1.0  # 액터의 처음 표준편차 (tanh 앞)
    slow_critic_every: int = 100  # 목표(느린) 크리틱을 몇 번마다 복사할지 (DreamerV2)
    return_norm: bool = False  # DreamerV3 식 리턴 정규화
| 이름 | 뜻 | 이 구현 | DreamerV1 논문 |
| World Model | RSSM, 인코더, 디코더, 보상 | 11장과 같음 (h 200, z 30, 자유 내트 3) | 같음 |
| \(H\) | 상상 길이 | 15 | 15 |
| \(\gamma\) / \(\lambda\) | 할인율 / λ-리턴 | 0.99 / 0.95 | 0.99 / 0.95 |
| 학습률 | 모델 / 액터 / 크리틱 | \(6\times10^{-4}\) / \(8\times10^{-5}\) / \(8\times10^{-5}\) | 같음 |
| \(B \times L\) | 배치 | 50 × 50 | 50 × 50 |
| 액터, 크리틱 | MLP | 너비 300, 은닉층 3개, ELU | 비슷한 크기의 ELU MLP |
| 기울기 자르기 | 노름 상한 | 100 | 100 |
| 탐험 잡음 | 수집할 때 | 0.3 | 0.3 |
| 엔트로피 \(\eta\) | 보너스 계수 | \(10^{-4}\) | 없음 (잡음으로 탐험) |
| 느린 크리틱 | 복사 주기 | 100 스텝 | 없음 (V2 부터) |
| \(S\), \(C\), 행동 반복 | 시드, 학습 횟수, 반복 | 5, 100, 2 | 5, 100, 2 |
| 보상 배율 | 학습용 보상 크기 | 0.1 | 없음 (DMC 보상은 이미 0 ~ 1) |
보상 배율이 중요한 이유. 진자의 보상은 한 결정에 최저 \(-33\) 까지 내려가고 \(\gamma = 0.99\) 면 가치가 수백에서 천 단위가 된다. 크리틱 출력은 0 근처에서 시작해 학습률 \(8\times10^{-5}\) 로 천천히 움직이므로 그런 값에 도달하는 데만 오래 걸린다. 보상에 0.1 을 곱하면 가치가 DMC(DreamerV1 이 실험한 과제들)와 비슷한 크기가 된다. DreamerV3 는 이 문제를 symlog 와 리턴 정규화로 푼다.
실행 결과
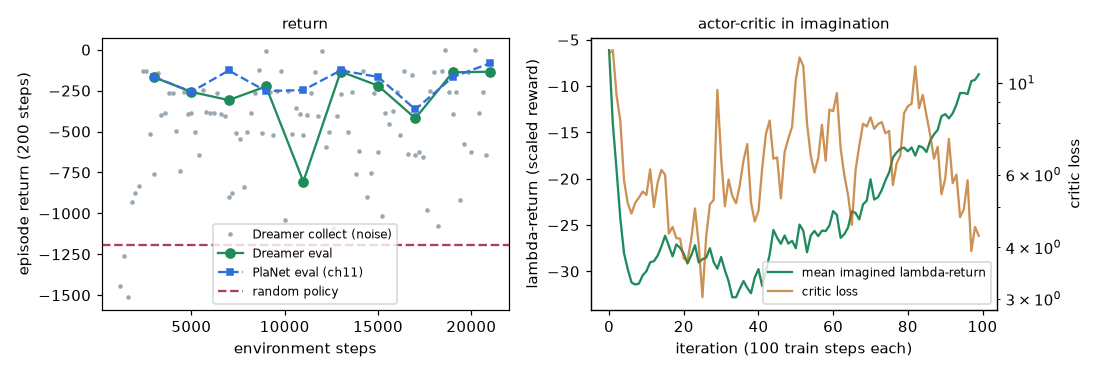
본문 설정 그대로 노트북 GPU(8GB)에서 11장의 PlaNet 과 같은 시드, 같은 환경 스텝 수(21,000)로 돌린 결과다. 두 학습이 GPU 를 나눠 썼다. imag G 는 상상 궤적의 평균 λ-리턴(보상 배율 0.1 이 곱해진 값), ent 는 액터의 엔트로피 추정값, act 는 실제 환경에서 결정 한 번에 걸린 시간이다.
lambda-return check: recursion vs definition max |diff| = 2.38e-07
random policy return: -1194.5
it   1 | env steps   1200 | recon   78.5 kl 1.15 | imag G   -6.12 critic 11.788 ent -1.21 | return  -1445.7 | act  8.5 ms |    66s
it   2 | env steps   1400 | recon   23.8 kl 4.60 | imag G  -14.08 critic 12.012 ent -2.91 | return  -1257.8 | act  4.7 ms |   119s
it   3 | env steps   1600 | recon    5.9 kl 3.14 | imag G  -19.05 critic  9.342 ent -3.36 | return  -1513.0 | act 12.8 ms |   180s
…
it  10 | env steps   3000 | recon    1.9 kl 2.78 | imag G  -30.42 critic  5.457 ent -5.15 | return   -759.9 | act  2.7 ms |   598s | eval   -167.8
…
it  50 | env steps  11000 | recon    0.7 kl 2.67 | imag G  -26.70 critic  7.834 ent -6.87 | return   -520.6 | act  5.0 ms |  2529s | eval   -805.8
…
it 100 | env steps  21000 | recon    0.4 kl 2.62 | imag G   -8.73 critic  4.260 ent -6.90 | return   -129.7 | act  4.3 ms |  4799s | eval   -134.5
final eval over 10 episodes: mean -196.4, std 120.9, min -393.3, max -3.3
done in 4806s
10회마다 잰 평가 리턴(잡음 없는 에피소드 3개 평균)은 차례로 −167.8, −257.7, −307.9, −224.8, −805.8, −133.4, −219.4, −419.3, −138.4, −134.5 다.
학습 곡선
- 그림: Dreamer 와 PlaNet 의 리턴 곡선, 상상 속 λ-리턴과 크리틱 손실
- 같은 출발. Dreamer 도 환경 스텝 3,000 에서 평가 리턴 −168 로 PlaNet(−166)과 거의 같은 속도로 진자를 세우기 시작한다. 이 시점까지 액터는 실제 환경에서 10 에피소드만 겪었지만 상상 속에서는 \(100 \times 10 \times 2500 \times 15 \approx 3{,}750\)만 스텝을 경험했다.
- 더 흔들린다. 평가 리턴이 11,000 스텝에서 −806 까지 떨어졌다가 회복한다. 계획(PlaNet)은 매 순간 새로 최적화하므로 모델이 조금 바뀌어도 결과가 크게 흔들리지 않지만, 액터는 모델과 크리틱의 오차까지 함께 배워 버릴 수 있다(모델 착취). 탐험 잡음을 넣은 수집 리턴도 PlaNet 보다 넓게 흩어진다.
- 상상 속 리턴은 후반에 오른다. λ-리턴은 처음 40회 남짓 −30 근처(−26 ~ −33)에 머물다가 −9 까지 올라간다. 처음 몇 회에 −6 에서 −30 으로 내려가는 것은 학습 초반의 보상 모델과 크리틱이 0 근처의 엉터리 값을 내다가 진짜 보상(음수)을 배우면서 생기는 일이다.
에피소드와 상상의 품질
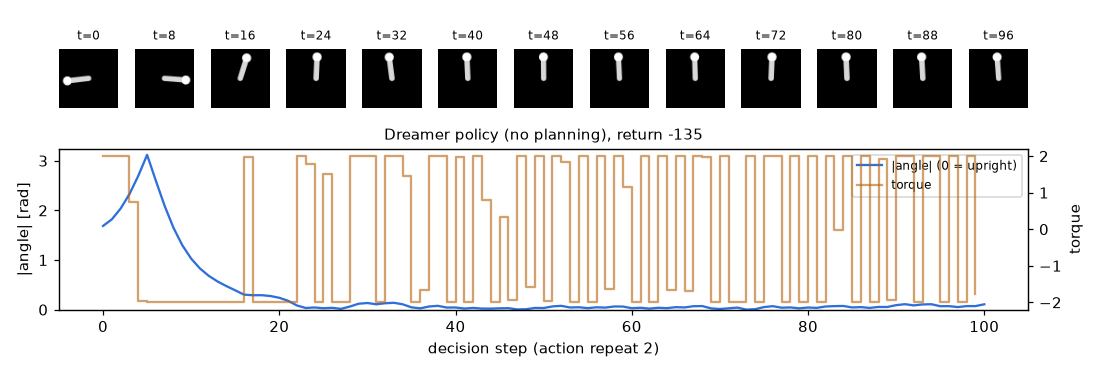
학습을 마친 액터는 계획 없이 신경망 한 번 계산으로 진자를 세운다(꼭대기에서 약 1.7 rad 기운 채 출발, 리턴 −135). 전략은 PlaNet 과 같다. 아래로 떨어뜨려 반동을 모으고(결정 0 ~ 5), 반대 방향 최대 토크로 끌어올린 뒤(결정 5 ~ 16), 꼭대기에서 균형을 잡는다. 차이는 토크 모양이다. Dreamer 는 거의 늘 \(+2\) 아니면 \(-2\) 만 낸다(뱅뱅 제어). 로그의 엔트로피가 \(-7\) 근처까지 내려간 것과 같은 현상으로, tanh 앞의 값이 커져 행동이 \(\pm 1\) 에 붙은 것이다. 진자처럼 토크가 약한 과제에서는 뱅뱅 제어도 꽤 좋은 정책이라 균형은 잡지만 꼭대기에서 막대가 미세하게 떨린다. PlaNet 은 정예 100개의 평균을 쓰므로 꼭대기에서 작은 토크를 내는 부드러운 행동이 나온다.
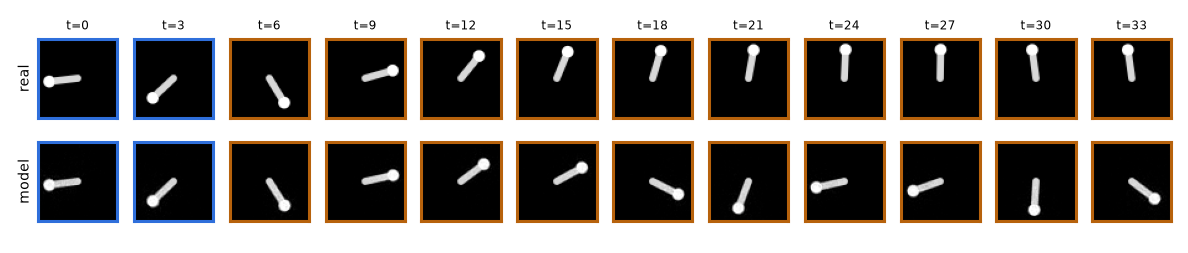
Dreamer 의 World Model 은 처음 몇 스텝(t = 5 ~ 9)은 진짜와 거의 같게 상상하지만 t = 12 무렵부터 뒤처지고, 진짜 진자가 꼭대기에 서는 동안 상상 속 진자는 꼭대기에 닿지 못하고 도로 떨어져 아래에서 흔들린다. 상상 길이 \(H = 15\) 를 넘는 먼 미래는 크리틱이 맡고, 실제로 행동할 때는 매 순간 새 그림으로 믿음 상태를 고쳐 잡으므로 이 오차가 정책을 망치지는 않는다. 다만 꼭대기 근처의 상상이 부정확하면 액터가 꼭대기에서의 미세한 균형을 배우기 어렵고, 이것은 뱅뱅 제어와 떨림과 무관하지 않다.
PlaNet 과 Dreamer 비교
학습을 마친 뒤 처음 보는 같은 시작 상태 10개로 평가했다.
| 정책 | 평균 리턴 (10 에피소드) | 표준편차 | 최저 / 최고 | 결정 한 번에 걸린 시간 |
| 무작위 행동 | −1194.5 | - | - | - |
| PlaNet (11장, CEM 계획) | −196.8 | 113.7 | −376.2 / −0.5 | 약 100 ms |
| Dreamer (액터) | −196.4 | 120.9 | −393.3 / −3.3 | 약 5 ms |
결정 시간은 환경 한 스텝, 그림 그리기, 인코더까지 포함한 값이라 계획 자체만 비교하면 차이가 더 크다. 이 실험(환경 스텝 21,000)에서 Dreamer 는 PlaNet 과 같은 성능을 약 20배 빠른 결정으로 냈고 학습 과정은 더 출렁였다. Dreamer 논문은 DMC 20개 과제에서 Dreamer 가 PlaNet 을 포함한 기존 방법보다 데이터 효율, 계산 시간, 최종 성능 모두 앞섰다고 보고한다. 이 과제는 계획 길이 12 스텝으로도 충분히 내다볼 수 있어 가치 함수로 지평선 너머를 보는 장점이 드러나기 어렵다.
| 항목 | 값 |
| 전체 학습 시간 (노트북 GPU, PlaNet 과 함께) | 4,806초 ≈ 80분 |
| 같은 GPU 를 혼자 쓸 때 ( | 2,575초 ≈ 43분, 결정 한 번 약 1.5 ms |
| 학습 한 스텝 (CPU 4스레드, \(B = 50\)) | 약 23초. 본문 설정(1만 스텝)은 CPU 로 사실상 불가능 |
| 같은 것, | 약 5초. 1만 스텝에 반나절 이상 |
| | 약 15초 (동작 확인용) |
학습 시간은 PlaNet 과 비슷하다. 학습 한 스텝은 상상, 액터, 크리틱이 더해져 무겁지만 데이터를 모을 때 계획이 없어 그만큼 빠르다.
리턴 정규화를 켠 실험
DreamerV3 식 리턴 정규화를 --return-norm 으로 켜고 다른 것은 같게(같은 시드) 돌렸다. GPU 를 혼자 써서 2,575초가 걸렸고, 마지막 줄은 imag G -16.20 critic 7.012 ent -7.95, 최종 평가는 mean −248.5, std 117.5, min −392.6, max −132.3 이다.
| 설정 | 최종 평균 리턴 (10 에피소드) | 학습 중 평가 리턴의 범위 |
| Dreamer (기본) | −196.4 ± 120.9 | −806 ~ −133 |
| Dreamer + 리턴 정규화 | −248.5 ± 117.5 | −604 ~ −140 |
결과는 나아지지 않았다. 해석은 다음과 같다.
- 시드 하나의 비교는 결론이 되지 못한다. 두 설정 모두 학습 중 평가 리턴이 수백씩 출렁이므로 평균 50 정도의 차이는 시드로도 생긴다. 시드를 5개 이상 돌려 평균과 신뢰 구간을 봐야 한다.
- V3 의 기법은 한 묶음이다. 리턴 정규화는 엔트로피 계수 \(3\times10^{-4}\), symlog 와 two-hot 크리틱, 느린 크리틱의 정규화 등과 함께 맞춰진 것이라 하나만 떼어 V1 에 붙이면 효과가 그대로 나오지 않을 수 있다.
- 이 과제는 이미 보상 배율로 크기를 맞췄다. 리턴 정규화의 장점은 과제마다 손으로 맞추지 않아도 된다는 데 있는데, 보상 배율 0.1 로 이미 손질했으므로 더 얻을 것이 적다.
DreamerV2: 범주형 잠재와 KL 균형
DreamerV1 은 연속 제어 과제(DMC)에서 좋았지만 Atari 처럼 장면이 갑자기 바뀌는 과제에서는 약했다. Hafner, Lillicrap, Norouzi, Ba 의 Mastering Atari with Discrete World Models(ICLR 2021), 즉 DreamerV2 는 World Model 만으로 학습한 에이전트로는 처음으로 Atari 55개 게임에서 사람 수준의 성능을 냈다.
범주형 잠재 변수
V1 의 \(z_t\) 는 30차원 가우시안이다. V2 는 32개의 범주형 변수를 쓰고 각 변수가 32개 범주 중 하나를 원-핫 벡터로 가진다. 32 × 32 = 1024 칸 중 32칸만 1 인 성긴 벡터다. 논문은 범주형이 왜 더 나은지 확실히는 모른다고 밝히면서 가설을 든다.
- 가우시안 하나는 봉우리가 하나지만 범주형은 "적이 왼쪽에서 나온다 / 오른쪽에서 나온다"처럼 여러 봉우리의 미래를 표현한다.
- 장면 바뀜, 아이템 획득 같은 불연속적인 변화에 어울린다.
- 최적화가 더 잘 될 수 있다(직선 통과 기울기가 재매개변수화 기울기보다 다루기 쉬울 수 있다는 추측).
직선 통과 추정기
범주형 표본(원-핫)은 확률 \(p\) 의 계단 함수라 미분이 0 이거나 정의되지 않아 재매개변수화를 쓸 수 없다. V2 는 직선 통과 추정기(straight-through estimator)를 쓴다.
\(z = \operatorname{onehot} + p - \operatorname{sg}(p)\)
- 값: \(\operatorname{sg}(p)\) 는 값으로는 \(p\) 이므로 \(z = \operatorname{onehot}\) 이다. 순전파에서 \(z\) 는 뽑은 원-핫 벡터 그대로다.
- 기울기: 뽑은 원-핫은 그래프에 연결되지 않은 상수이고 \(\operatorname{sg}\) 의 미분은 0 이므로 \(\frac{\partial z}{\partial p} = 0 + I - 0 = I\), 즉 \(\frac{\partial \mathcal{L}}{\partial p} = \frac{\partial \mathcal{L}}{\partial z}\) 다. 역전파에서는 \(z\) 에 도착한 기울기를 그대로 \(p\) 로 넘긴다. 뽑기를 항등 함수로 취급하는 것이라 정확한 기울기는 아니지만(편향 있음) 실전에서 잘 동작한다.
- 예: \(p = (0.2,\ 0.7,\ 0.1)\) 에서 두 번째 범주가 뽑히면 순전파 값은 \(z = (0, 1, 0)\) 이고, 역전파에서는 \((g_1, g_2, g_3)\) 가 세 확률 모두로 흘러간다.
probs = logits.softmax(-1)                                   # (..., 32, 32)
idx = torch.distributions.Categorical(probs=probs).sample()  # (..., 32)
onehot = F.one_hot(idx, 32).float()
z = onehot + probs - probs.detach()                          # 값은 원-핫, 기울기는 probs 로
KL 균형
순차 ELBO 의 KL 항 \(D_{\mathrm{KL}}(q \,\Vert\, p)\) 는 사후 \(q\) 와 사전 \(p\) 를 서로에게 끌어당긴다. 둘이 같은 속도로 끌려가면, 학습 초반의 엉망인 사전 쪽으로 사후가 끌려가 그림의 정보를 덜 담게 된다. 바람직한 것은 사전이 사후를 따라가는 것(동역학을 배우는 것)이다. KL 균형(KL balancing)은 기울기 차단으로 이 비율을 조절한다.
\(\mathcal{L}_{\text{KL}} = \alpha\,D_{\mathrm{KL}}\big(\operatorname{sg}(q)\ \Vert\ p\big) + (1 - \alpha)\,D_{\mathrm{KL}}\big(q\ \Vert\ \operatorname{sg}(p)\big),\qquad \alpha = 0.8\)
- 값: \(\operatorname{sg}\) 는 값을 바꾸지 않고 가중치의 합이 1 이므로 손실의 값은 원래 KL 과 같다.
- 사전으로 가는 기울기는 첫 항에서만 온다: \(\alpha\,\nabla D_{\mathrm{KL}}(q \,\Vert\, p)\).
- 사후로 가는 기울기는 둘째 항에서만 온다: \((1-\alpha)\,\nabla D_{\mathrm{KL}}(q \,\Vert\, p)\).
- \(\alpha = 0.8\) 이면 사전은 KL 기울기의 80%, 사후는 20% 만 받는다. 값은 두고 누가 더 많이 움직일지만 정하는 장치다.
이산 행동과 REINFORCE
Atari 의 행동은 이산이라 행동에 대해 재매개변수화 경사를 쓸 수 없다. V2 는 Atari 에서 REINFORCE 를 상상 궤적에 적용한다.
\(\mathcal{L}(\psi) = -\sum_{t}\Big[\rho\,\log\pi_\psi(a_t \mid s_t)\,\operatorname{sg}\big(V^\lambda_t - v_\xi(s_t)\big) + (1-\rho)\,V^\lambda_t + \eta\,\mathcal{H}[\pi_\psi(\cdot \mid s_t)]\Big]\)
\(\rho\) 는 두 추정기를 섞는 비율이다. 논문은 Atari 에서 \(\rho = 1\)(REINFORCE 만), 연속 제어에서 \(\rho = 0\)(동역학 역전파만)을 썼다. \(V^\lambda_t - v_\xi(s_t)\) 는 이점(advantage)이다. 행동에 의존하지 않는 기준선 \(b\)(여기서는 \(v_\xi(s_t)\))를 빼도 기울기의 기댓값은 변하지 않는다.
\(\mathbb{E}_{a \sim \pi}\big[b\,\nabla_\psi \log\pi_\psi(a \mid s)\big] = b\sum_{a}\pi_\psi(a \mid s)\,\frac{\nabla_\psi\pi_\psi(a \mid s)}{\pi_\psi(a \mid s)} = b\,\nabla_\psi\sum_{a}\pi_\psi(a \mid s) = b\,\nabla_\psi\, 1 = 0\)
기준선은 기댓값을 바꾸지 않으면서 리턴의 크기를 0 근처로 옮겨 분산을 줄인다. 이 밖에 V2 는 느린 목표 크리틱(이 구현이 쓴 것), 층 정규화 등을 더했다.
DreamerV3: 하나의 설정으로 여러 영역
강화학습 알고리즘은 과제마다 하이퍼파라미터를 새로 맞춰야 한다(이 장의 보상 배율 0.1 도 그런 예다). Hafner, Pasukonis, Ba, Lillicrap 의 DreamerV3(Mastering diverse control tasks through world models, 2023년 arXiv 공개, 2025년 Nature 게재)는 하나의 고정된 설정으로 Atari, DMC, Minecraft 등 150개가 넘는 과제에서 좋은 성능을 냈고, 사람의 데이터나 교과 과정 없이 처음부터 Minecraft 에서 다이아몬드를 캐낸 첫 알고리즘이 되었다. 신호의 크기에 흔들리지 않게 만드는 기법들이 핵심이다.
symlog 와 symexp
과제마다 보상과 관측의 크기가 크게 다르다(진자는 \(-16\) ~ \(0\), 어떤 게임은 수천). 제곱 오차로 큰 숫자를 맞추면 기울기가 폭발하고 작은 숫자는 묻힌다. V3 는 예측 대상을 symlog(symmetric logarithm)로 눌러 학습하고 쓸 때 symexp 로 되돌린다.
\(\operatorname{symlog}(x) = \operatorname{sign}(x)\,\log\big(\vert x\vert + 1\big),\qquad \operatorname{symexp}(x) = \operatorname{sign}(x)\big(\exp(\vert x\vert) - 1\big)\)
- 역함수: \(y = \operatorname{symlog}(x)\) 이면 \(\log(\vert x\vert+1) \ge 0\) 이므로 \(\operatorname{sign}(y) = \operatorname{sign}(x)\), \(\vert y\vert = \log(\vert x\vert + 1)\) 이고 \(\operatorname{symexp}(y) = \operatorname{sign}(x)\big(\exp(\log(\vert x\vert+1)) - 1\big) = x\) 다.
- 미분: 양쪽을 따로 미분해 합치면 \(\frac{d}{dx}\operatorname{symlog}(x) = \frac{1}{\vert x\vert + 1}\) 이다. \(x = 0\) 에서 1(작은 값은 거의 그대로), \(\vert x\vert\) 가 커질수록 작아져 큰 값을 누른다.
- 예: \(\operatorname{symlog}(10) = \log 11 \approx 2.398\), \(\operatorname{symlog}(1000) = \log 1001 \approx 6.909\), \(\operatorname{symlog}(-10) \approx -2.398\). 1000 과 10 의 차이가 100배에서 약 2.9배로 줄어든다.
일반 로그와 달리 0 과 음수에서도 정의되고 원점 근처에서는 기울기가 1 이라 작은 값을 망가뜨리지 않는다. V3 는 벡터 관측의 입력과 복원 대상, 보상과 가치 예측에 이 변환을 쓴다.
two-hot 인코딩
V3 는 보상과 가치의 회귀를 분류 문제로 바꾼다. symlog 공간에 일정 간격의 칸(bin) \(b_1 \lt b_2 \lt \cdots \lt b_K\) 를 깔고(arXiv 초판은 \(-20\) 에서 \(20\) 까지 255칸), 신경망은 칸들에 대한 소프트맥스 확률 \(p_1, \dots, p_K\) 를 낸다. 목표값 \(y\) 는 그것을 끼고 있는 두 이웃 칸에 나눠 담는다(two-hot encoding). \(b_k \le y \lt b_{k+1}\) 일 때 조건은 두 가지다.
\(w_k + w_{k+1} = 1,\qquad w_k\, b_k + w_{k+1}\, b_{k+1} = y\)
\(w_k = 1 - w_{k+1}\) 을 넣어 풀면 선형 보간이 나온다. 나머지 칸의 가중치는 0 이다.
\(w_{k+1} = \frac{y - b_k}{b_{k+1} - b_k},\qquad w_k = \frac{b_{k+1} - y}{b_{k+1} - b_k}\)
예: 보상 \(r = 10\) 이면 \(y = \operatorname{symlog}(10) \approx 2.398\). 칸 간격이 1 이고 \(b_k = 2\), \(b_{k+1} = 3\) 이면 \(w_k = 0.602\), \(w_{k+1} = 0.398\) 이고 \(0.602 \times 2 + 0.398 \times 3 = 2.398\) 로 되살아난다.
손실은 목표 가중치와 예측 확률 사이의 교차 엔트로피 \(-\sum_i w_i \log p_i\) 이고 예측값은 \(\hat{y} = \operatorname{symexp}\big(\sum_i p_i\, b_i\big)\) 다. 교차 엔트로피의 기울기는 \(p - w\) 꼴로 크기가 늘 1 이하라서, 목표값이 1 이든 10000 이든 기울기의 크기가 목표의 크기와 무관해진다. 분류로 바꾸는 이유다. 여기까지는 arXiv 초판의 서술이다. 2024년 개정판은 칸 자체를 \(b = \operatorname{symexp}(-20, \dots, 20)\) 으로 지수 간격으로 깔고, 목표값을 그대로 two-hot 으로 바꾸며, 예측값은 \(\hat{y} = \sum_i p_i\, b_i\) 로 읽는다(symexp 가 평균의 바깥에서 안으로 들어갔다).
자유 비트와 KL 나누기
V3 는 11장의 자유 내트(free nats)를 1 내트로 쓰고(논문은 "free bits" 라고 부른다), V2 의 KL 균형을 두 손실로 나눠 각각에 적용한다.
\(\mathcal{L}_{\text{dyn}} = \max\Big(1,\ D_{\mathrm{KL}}\big(\operatorname{sg}(q)\ \Vert\ p\big)\Big),\qquad \mathcal{L}_{\text{rep}} = \max\Big(1,\ D_{\mathrm{KL}}\big(q\ \Vert\ \operatorname{sg}(p)\big)\Big)\)
\(\mathcal{L} = \mathcal{L}_{\text{pred}} + \beta_{\text{dyn}}\,\mathcal{L}_{\text{dyn}} + \beta_{\text{rep}}\,\mathcal{L}_{\text{rep}}\)
\(\mathcal{L}_{\text{dyn}}\) 은 사전(동역학)을, \(\mathcal{L}_{\text{rep}}\) 은 사후(표현)를 학습시킨다. \(\mathcal{L}_{\text{pred}}\) 는 재구성, 보상, 계속 여부(에피소드가 끝나는지) 예측 손실이다. 가중치는 판에 따라 다르다. arXiv 초판(2023년 1월)은 \(\beta_{\text{dyn}} = 0.5\), \(\beta_{\text{rep}} = 0.1\), 개정판(2024년)은 \(\beta_{\text{dyn}} = 1\), \(\beta_{\text{rep}} = 0.1\) 이다. 어느 쪽이든 사전 쪽 가중치가 훨씬 커서 V2 의 \(\alpha = 0.8\) 과 같은 역할을 한다(초판 \(0.5/0.6 \approx 0.83\), 개정판 \(1/1.1 \approx 0.91\)). KL 이 1 내트 아래로 내려가면 그 항의 기울기가 꺼지는 것은 11장의 유도와 같다.
unimix
범주형 분포의 어떤 범주 확률이 0 에 가까워지면 KL 의 \(\log(q/p)\) 가 폭발할 수 있다. V3 는 신경망이 낸 확률에 균등 분포를 1% 섞는다.
\(p_i = 0.99\cdot\operatorname{softmax}(\ell)_i + 0.01\cdot\frac{1}{K}\)
모든 범주의 확률이 적어도 \(0.01/K\) 이므로 어떤 \(q_i \le 1\) 에 대해서도 \(\log(q_i/p_i) \le \log(100K)\) 로 위가 막힌다. \(K = 32\) 면 \(\log 3200 \approx 8.07\) 이다. 같은 기법을 이산 행동의 정책에도 쓴다.
리턴 정규화
액터의 기울기 크기는 리턴의 크기에 비례한다. 보상이 큰 과제에서는 액터 기울기가 엔트로피 보너스를 압도하고(탐험 부족) 보상이 작은 과제에서는 반대가 된다. V3 는 리턴을 그 퍼진 폭으로 나눈다.
\(S = \operatorname{EMA}\Big(\operatorname{Per}(V^\lambda, 95) - \operatorname{Per}(V^\lambda, 5),\ 0.99\Big),\qquad \frac{V^\lambda_t - v_\xi(s_t)}{\max(1,\ S)}\)
- \(\operatorname{Per}(\cdot, 95)\) 는 배치 안 리턴들의 95 백분위수다. 최댓값과 최솟값 대신 백분위수를 써서 튀는 값에 흔들리지 않는다.
- EMA(지수 이동 평균, 계수 0.99)로 배치마다 출렁이지 않게 따라간다: \(S \leftarrow 0.99\,S + 0.01\,(\text{range})\).
- \(\max(1, S)\) 는 보상이 희소한 과제에서 작은 리턴 차이(잡음)를 부풀리지 않기 위한 것이다. 폭이 1 보다 클 때만 줄인다.
- 엔트로피 계수는 모든 과제에서 \(\eta = 3 \times 10^{-4}\) 로 고정된다. 리턴의 크기가 맞춰졌기 때문에 가능하다.
위 식처럼 크리틱 값을 뺀 이점에 REINFORCE 를 쓰는 것은 2024년 개정판의 꼴이다(이산, 연속 행동 모두). arXiv 초판은 \(\operatorname{sg}(V^\lambda_t)/\max(1, S)\) 를 쓰고 V2 처럼 연속 행동에는 동역학 역전파를, 이산 행동에는 REINFORCE 를 썼다. 이 장의 코드는 --return-norm 옵션(train_step 의 if cfg.return_norm:)으로 넣었고, 동역학 역전파를 쓰므로 초판처럼 \(v_\xi(s_t)\) 를 빼지 않고 리턴을 그대로 나눈다.
세 버전 비교
| DreamerV1 (2020) | DreamerV2 (2021) | DreamerV3 (2023, 2025) | |
| 잠재 \(z\) | 가우시안 30차원 | 범주형 32 × 32 (직선 통과) | 범주형 + unimix 1% |
| KL | 자유 내트 3 | KL 균형 \(\alpha = 0.8\) | dyn 0.5(개정판 1) / rep 0.1, 자유 비트(free bits) 1 |
| 보상, 가치 | 가우시안 회귀 | 가우시안 회귀 | symlog + two-hot 분류 |
| 액터 기울기 | 동역학 역전파 | Atari: REINFORCE / 연속: 역전파 | 정규화한 리턴(초판), 이점 + REINFORCE(개정판) |
| 크리틱 목표 | λ-리턴 | λ-리턴 + 느린 크리틱 | λ-리턴 + 느린 크리틱(EMA) |
| 대표 성과 | DMC 20개 과제 | Atari 55개, 사람 수준 | 150여 과제 고정 설정, Minecraft 다이아몬드 |
자주 겪는 문제
| 증상 | 흔한 원인 | 해 볼 것 |
| 상상 리턴( | 액터가 World Model 의 오류를 이용한다(모델 착취). | 데이터를 더 모은다. 탐험 잡음과 엔트로피를 유지한다. 상상과 진짜 그림을 비교해 모델을 확인한다. |
| 크리틱 손실이 계속 커진다 | 가치의 크기가 너무 크거나 목표가 흔들린다. | 보상 배율, 느린 크리틱, (V3) 리턴 정규화와 two-hot. |
| 액터가 늘 \(\pm 1\) 만 낸다 | \(\tanh\) 포화. 진자에서는 이 뱅뱅 제어가 꽤 좋은 정책이다. | 문제가 될 때만 엔트로피 계수를 키운다. |
| 학습 초반 리턴이 무작위보다 나쁘다 | 모델이 아직 엉망이라 상상 속 최적 행동이 실제로는 나쁘다. | 정상이다. 데이터가 쌓이면 나아진다. 시드 에피소드 수를 늘려도 된다. |
| NaN | \(\log(1 - a^2)\) 에서 \(a = \pm 1\), 표준편차 0. | 작은 수 더하기(\(10^{-6}\)), 최소 표준편차, 기울기 자르기. |
정리
- PlaNet 의 계획은 비싸고(결정마다 12만 스텝) 근시안적이다. Dreamer 는 상상 속에서 액터와 크리틱을 학습해 결정할 때 신경망 한 번으로 행동한다.
- 상상은 World Model 학습에서 얻은 사후 상태 2500개에서 출발해 액터와 RSSM 사전으로 \(H = 15\) 스텝 굴린다.
- λ-리턴은 n-스텝 리턴들의 가중 평균이고(가중치 합 1), 재귀식 \(V^\lambda_t = \hat{r}_t + \gamma[(1-\lambda)v(s_{t+1}) + \lambda V^\lambda_{t+1}]\), \(V^\lambda_H = v(s_H)\) 로 계산한다.
- 크리틱은 \(\operatorname{sg}(V^\lambda_t)\) 에 회귀하고, 액터는 World Model 을 거슬러 미분해 λ-리턴을 키운다(재매개변수화 경사). 모델은 얼리고(
requires_grad_(False)) 끊지는 않는다. - tanh-가우시안 정책의 엔트로피는 변수 바꾸기 공식으로 \(\mathcal{H}[u] + \mathbb{E}[\log(1 - a^2)]\) 이다.
- 진자 실험에서 Dreamer 는 PlaNet 과 같은 평균 리턴(−196.4 대 −196.8)을 약 20배 빠른 결정(약 5 ms 대 약 100 ms)으로 냈고, 학습 곡선은 더 출렁였다.
- V2 는 범주형 잠재 + 직선 통과 추정기(\(z = \operatorname{onehot} + p - \operatorname{sg}(p)\)), KL 균형(\(\alpha = 0.8\)), 이산 행동의 REINFORCE 를 더했다. V3 는 symlog, two-hot, 자유 비트 1, unimix 1%, 리턴 정규화로 하나의 설정이 여러 영역에서 동작하게 했다.
확인 문제
- 1. \(\gamma = 1\) 일 때 \(H = 2\) 상상 궤적의 \(V^\lambda_0\) 은 \(\lambda = 0\) 과 \(\lambda = 1\) 에서 각각 무엇인가.
- \(\lambda = 0\): \(V^\lambda_0 = \hat{r}_0 + v(s_1)\) (한 스텝 TD 목표. \(v(s_2)\) 와 \(\hat{r}_1\) 은 쓰이지 않는다). \(\lambda = 1\): \(V^\lambda_1 = \hat{r}_1 + v(s_2)\) 이고 \(V^\lambda_0 = \hat{r}_0 + \hat{r}_1 + v(s_2)\) (상상을 끝까지 쓴 2-스텝 리턴).
- 2. 액터 학습에서 World Model 을 얼리는 대신 상상한 상태를
.detach()로 끊으면 어떻게 되는가. - 행동 \(a_t\) 에서 다음 상태 \(s_{t+1}\) 로 가는 길이 끊겨 λ-리턴이 행동에 어떻게 의존하는지가 기울기에 나타나지 않는다. 엔트로피 항 말고는 액터로 가는 기울기가 없어 액터가 리턴을 키우는 법을 배우지 못한다. 얼리기는 "고치지 않되 통과시키기", 끊기는 "통과시키지 않기"다.
- 3. \(\sigma = 0.5\), 평균 0 인 1차원 가우시안 \(u\) 와 \(a = \tanh(u)\) 의 엔트로피는 얼마인가.
- \(\mathcal{H}[u] = \frac{1}{2}\log(2\pi e) + \log 0.5 \approx 1.419 - 0.693 = 0.726\). \(u\) 가 0 근처면 \(\log(1 - a^2) \approx -u^2\) 이므로 보정항은 대략 \(-\sigma^2 = -0.25\) 다(표본 200만 개로 어림하면 \(-0.23\)). 따라서 \(\mathcal{H}[a] \approx 0.50\) 이다. \(\sigma = 0.1\) 이면 보정이 \(-0.01\) 정도로 사라지고, \(u\) 가 \(\pm 3\) 근처에 몰리면 \(1 - \tanh^2(3) \approx 0.0099\) 라 로그가 약 \(-4.6\) 이 되어 엔트로피가 크게 줄어든다.
- 4. 칸이 \(b = (-1, 0, 1, 2)\) 일 때 \(y = 1.25\) 의 two-hot 벡터는 무엇인가.
- \(b_k = 1\), \(b_{k+1} = 2\) 이므로 \(w_{k+1} = 0.25\), \(w_k = 0.75\), 벡터는 \((0, 0, 0.75, 0.25)\) 다. 확인: \(0.75 \times 1 + 0.25 \times 2 = 1.25\).
- 5. KL 균형에서 \(\alpha = 0.5\) 와 \(\alpha = 1\) 은 각각 어떤 뜻인가.
- \(\alpha = 0.5\) 면 사전과 사후가 같은 비율의 기울기를 받는다. 값은 원래 KL 그대로이고 기울기는 양쪽 모두 0.5 배라서 \(0.5\,D_{\mathrm{KL}}(q \,\Vert\, p)\) 로 학습하는 것과 같다(0.5 는 학습률에 흡수된다). \(\alpha = 1\) 이면 둘째 항이 사라져 사후는 KL 에서 기울기를 받지 않고 재구성 손실로만 학습된다.
See also
- World Models:Tutorial
- World Models
- World Models:Tutorial:05 강화학습 기초
- World Models:Tutorial:11 RSSM 과 PlaNet
- Reinforcement learning
- Policy
- Backpropagation through time
- Entropy
- Cross entropy